Ett prov börjar vid en bestämd tid. Studenter kommer samtidigt och plattformen måste ta emot deras svar medan klockan fortsätter att gå. En större server löser inte de viktiga frågorna: Vad händer när en nod går sönder, en delad tjänst blir långsammare eller en distribution avbryter en aktiv begäran?
I den här fallstudien i fem delar följer vi en plattform för onlinekurser och prov från den ursprungliga uppsättningen till ändringarna inför en planerad topp. Del 1 visar hur vi identifierade riskerna innan vi valde infrastruktur.
Om fallet: NovaCommerce är ett anonymiserat namn. Konfigurationen och mätningarna nedan kommer från projektets dokumentation för september–oktober 2026. De beskriver plattformen och arbetslasten, inte en benchmark för Store Console. Den allmänna tekniska vägledningen granskades den 3 november 2026.
Börja med den affärsmässiga händelsen
En vanlig dags genomsnittliga trafik var en dålig indikator på provkapaciteten. Den krävande händelsen var den första minuten: Studenter som laddade frågor, kontrollerade sin session och påbörjade provet ungefär samtidigt.
Vi översatte händelsen till fyra krav:
Var redo innan starten. Kapaciteten måste redan vara godkänd och funktionsduglig när studenterna anländer.
Skydda bekräftade inlämningar. Definiera när ett svar har sparats varaktigt och hur en ny försöksansökan undviker att skapa dubbletter.
Låt inte ändringar avbryta pågående arbeten. Distributioner och borttagning av noder kräver hälsokontroller och att pågående begäranden hinner slutföras.
Gör kostnaden förklarbar. Varje återkommande resurs bör motverka en uppmätt kapacitetsbrist eller ett definierat fel.
Detta var krav, inte påståenden om att alla felscenarier redan hade testats.
Den ursprungliga arkitekturen och dess svaga punkter
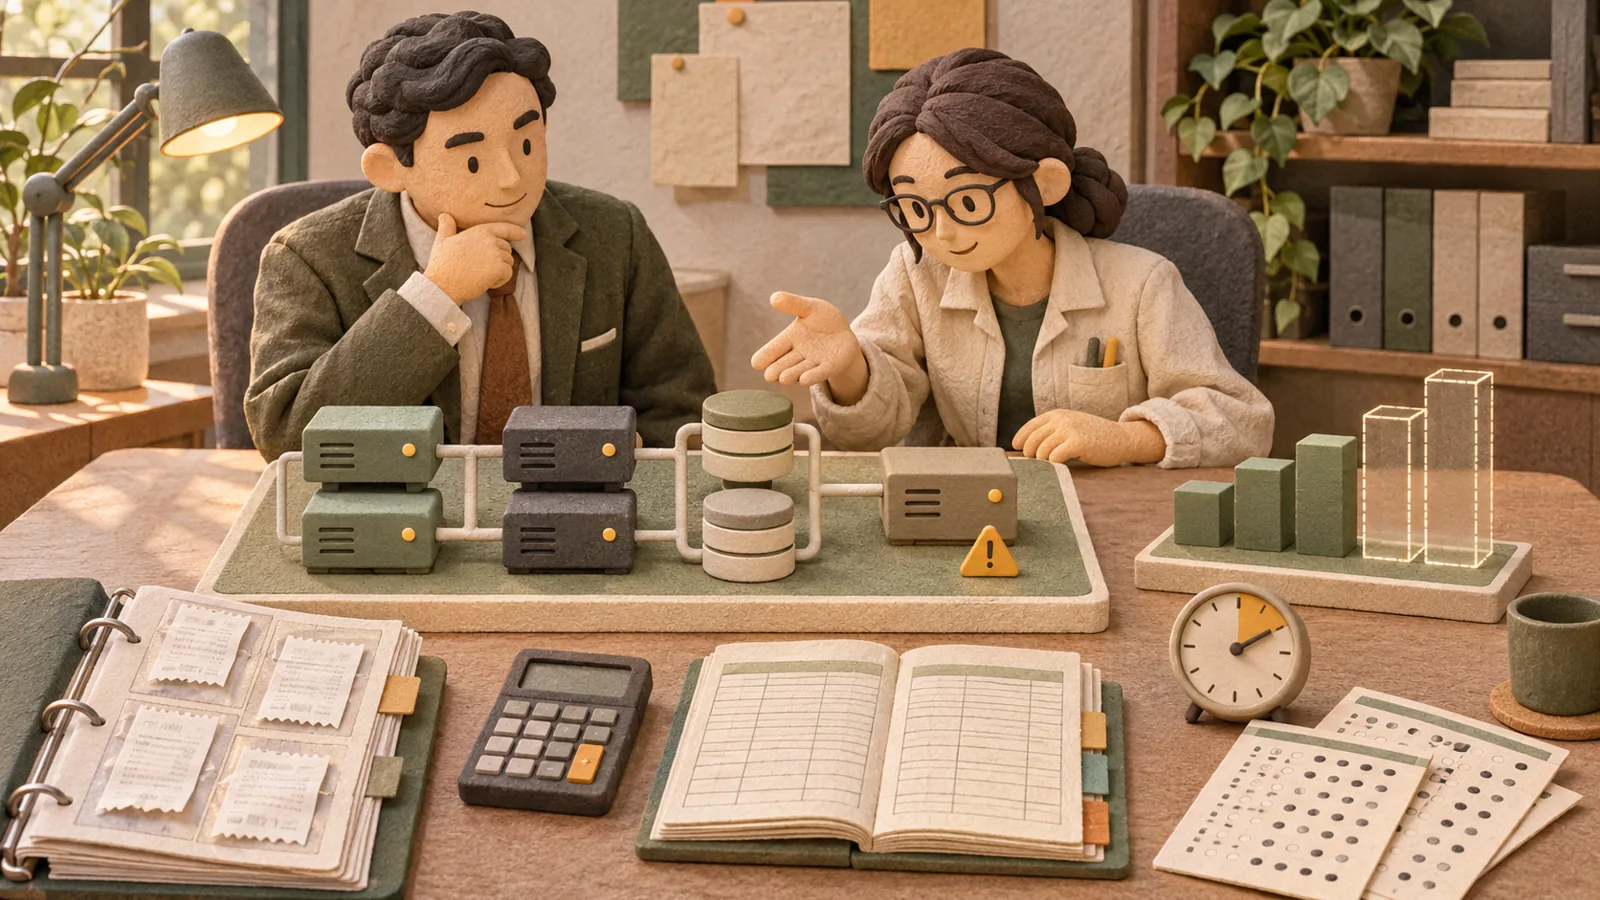
De ursprungliga felställena och det godkännandeunderlagg som krävdes inför ett prov. Detta är en undervisningskarta över det historiska fallet, inte en uppmätt tillgänglighetsgaranti.
Frontendens Next.js-container kördes på en Droplet med 8 vCPU och 16 GB, utan load balancer framför. Om den förlorades skulle den publika webbplatsen bli otillgänglig. Backendens uppdelning var bättre: Två noder med 4 vCPU och 8 GB körde Laravel via nginx och PHP-FPM, medan bakgrundsjobb, schemaläggaren och WebSockets kördes på en separat worker.
Backendens load balancer riktade sig mot fasta Droplet-ID:n. Att lägga till en server krävde därför registrering; konfigurationen hittade inte ny kapacitet automatiskt. Sessioner, cache och köer hade redan externaliserats till hanterad Valkey, vilket gjorde det lättare att ersätta webbnoder.
MySQL hade en hanterad nod med 8 vCPU och 32 GB samt ingen konfigurerad standby. En hanterad tjänst kan ersätta en trasig nod, men det är inte samma sak som att ha en replikerad standby redo för befordran. Den enskilda workern var ett annat felställe för asynkront arbete.
Ytterligare två Droplets var avstängda som återhämtningskapacitet. De kunde användas i en återhämtningsrutin, men hanterade ingen trafik och kunde inte ge automatisk failover.
En användbar skillnad: En enda JavaScript-event loop kan begränsa CPU-intensiv rendering, men Node.js använder även en worker pool och inbyggda operationer. En container ensam bevisar inte att sju av åtta kärnor var inaktiva. Rätt antal processer framgår av profilering och belastningstester.
Definiera tillgänglighet som ett test du kan köra
I stället för att kalla hela plattformen ”högtillgänglig” frågade vi vad en person skulle uppleva under ett specifikt fel.
Fel i webbnod: friska noder fortsätter att betjäna trafik; trasiga noder tar inte emot ny trafik.
Databasfel: en dokumenterad failover-återgång återställer tjänsten och applikationen hanterar tillfälliga frånkopplingar.
Distribution: en ersättningsnod blir redo innan den gamla noden slutar ta emot trafik; aktiva begäranden får tid att slutföras.
Planerad topp: tillräcklig kapacitet är godkänd och funktionsduglig före händelsen, med extra marginal för ojämn trafik.
Tillgänglighet och datavaraktighet kräver separat underlag. Statslösa webbnoder möjliggör ersättning, men garanterar inte i sig att ett svar överlever. Det beror också på databasens commit, replikering och persistensinställningar, hantering av försöksansökningar, säkerhetskopior och återhämtningstester. En design med en enda region garanterar heller inte återhämtning efter ett regionalt fel.
Tre resultat, tre olika åtgärder
1. HTTP 429: begränsningen räknade fel identitet
Den 25 september fick studenter som delade skolans eller operatörens nät ”för många förfrågningar”. API-begränsningen använde deras IP-adress eftersom den förväntade autentiserade identiteten inte kunde fastställas. Många personer delade därför samma tillåtna antal anrop.
Korrigeringen kopplade autentiserade begränsningar till student- eller lärar kontot och behöll en IP-baserad reserv för gäster. Fler servrar hade inte ändrat den regeln. Identitetsbaserade begränsningar kräver fortfarande separat skydd mot missbruk och är inte ett skäl att ta bort strypningen.
2. Timeouts för Valkey-anslutningar: en delad beroendefaktor klarade inte belastningen
Testet den 6 oktober registrerade 2 854 programfel med timeouts för Valkey-anslutningar. Fallets dokumentation beskriver att nya TLS-anslutningar medförde overhead och att konfigurationen ändrades från en primär och standby på 4 GB till 8 GB per nod.
Efter ändringen rapporterade en gradvis ramp från 25–500 förfrågningar per sekund noll programfel, men 143 fel i load balancern medan backendens CPU var fullt utnyttjad. Det visar att felet med timeout i applikationen eliminerades i den körningen. Det var däremot inte ett rent end-to-end-genomförande vid högsta belastning: Förfrågningar misslyckades fortfarande.
En timeout ensam bevisar inte att minnet är otillräckligt. För ett annat system bör du undersöka anslutningsflöden, gränser, nätverksbeteende och tjänstemätvärden innan du antar att en större plan är lösningen.
3. Backendens CPU: kapaciteten blev nästa begränsning
För den testade API-blandningen nådde en backendnod med 4 vCPU cirka 65–70 förfrågningar per sekund vid full CPU-användning. Det är en observerad mättnadsnivå, inte ett säkert driftmål eller en generell benchmark. Att minska CPU-arbetet och att öka kapaciteten är båda alternativ som bör utvärderas.
I ett test kom den första extra autoskalade noden ungefär sju minuter efter att CPU-nivån nådde 99 procent. Fördröjningen var specifik för den här uppsättningen. För ett planerat prov var den praktiska åtgärden att skala i förväg och verifiera beredskapen före starten.
Håll kostnadsjämförelsen ärlig
Den ursprungliga projektbudgeten uppskattade webbnivån till cirka 416 USD/månad, inklusive 112 USD/månad för de avstängda Droplets. Detta är historiska siffror från september–oktober 2026; de omfattar inte databaserna, Valkey eller lagringen. De bör inte jämföras med en senare faktura för hela plattformen.
DigitalOcean debiterar fortfarande reserverade CPU-Droplets även när de är avstängda. Om kall kapacitet är värd beror på hur snabbt den faktiskt kan ge återhämtning. Fråga vilket fel en resurs täcker, hur snabbt den kan hjälpa till och när den återhämtningsrutin senast testades.
Leverantörens planer ändras också. Digitaloceans aktuella dokumentation anger begränsningar för planer för PostgreSQL och MySQL Standard Edition från och med den 15 oktober 2026 för konton som aldrig har skapat ett PostgreSQL- eller MySQL-kluster och från och med den 30 november 2026 för alla konton. Kontrollera den aktuella planberättigingen och priserna innan du återskapar en historisk konfiguration.
Använd samma granskning inför nästa topp
För ett prov, en produktlansering eller en checkout-topp: Skriv ned den kritiska förfrågningsvägen. Identifiera varje delat beroende och fråga vad som händer när det blir otillgängligt. Testa sedan den förväntade arbetslasten och mät lyckade svar, svanslatens och fel längs hela vägen.
Ändra den nivå som underlaget pekar ut och upprepa sedan testet. Målet är en tjänst som hanterar den affärsmässiga händelsen inom en definierad budget för fel och återhämtning.
Fallets konfiguration, incidentantal och testobservationer kommer från historisk projektdokumentation. Källorna nedan stöder de allmänna förklaringarna, inte de privata mätningarna.
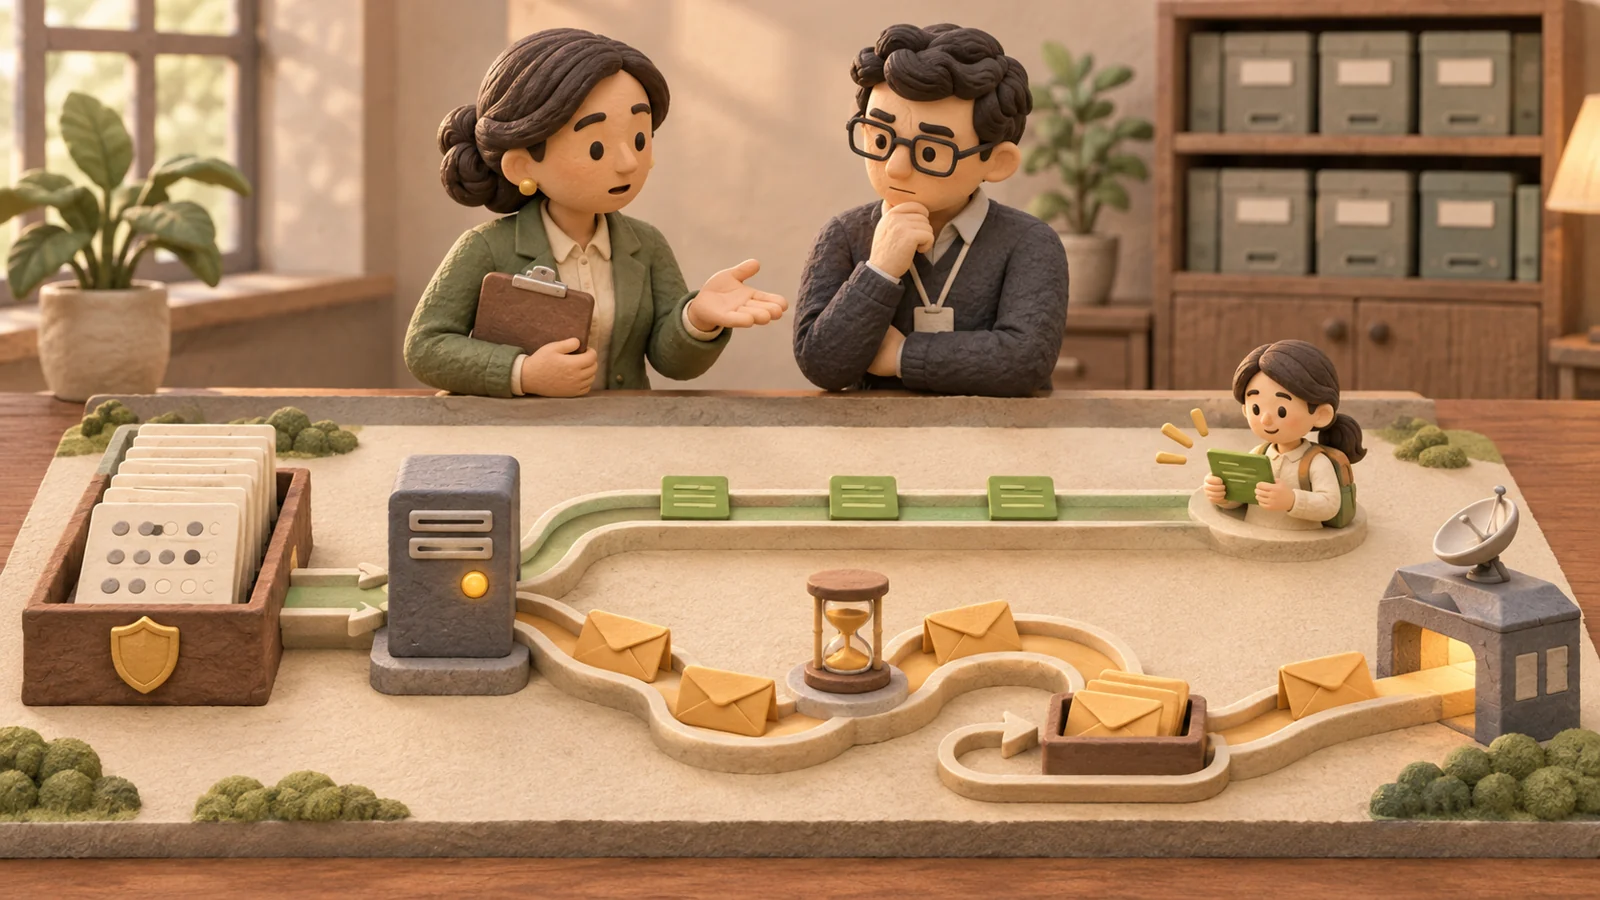
Granskad den 6 november 2026. Ett godkänt svar kräver ett explicit kvittens för varaktig sparande, en operationsidentifierare och en idempotent återförsöksväg. Ett jobb i en kö är inte den enda kopian av svaret. En standby, en säkerhetskopia och ett lyckat återställningstester löser olika problem; inget av dem ensamt bevisar noll dat förlust. De historiska incidentantalen nedan har bevarats från den befintliga falldokumentationen och har inte mätts om oberoende i den här redaktionella granskningen.