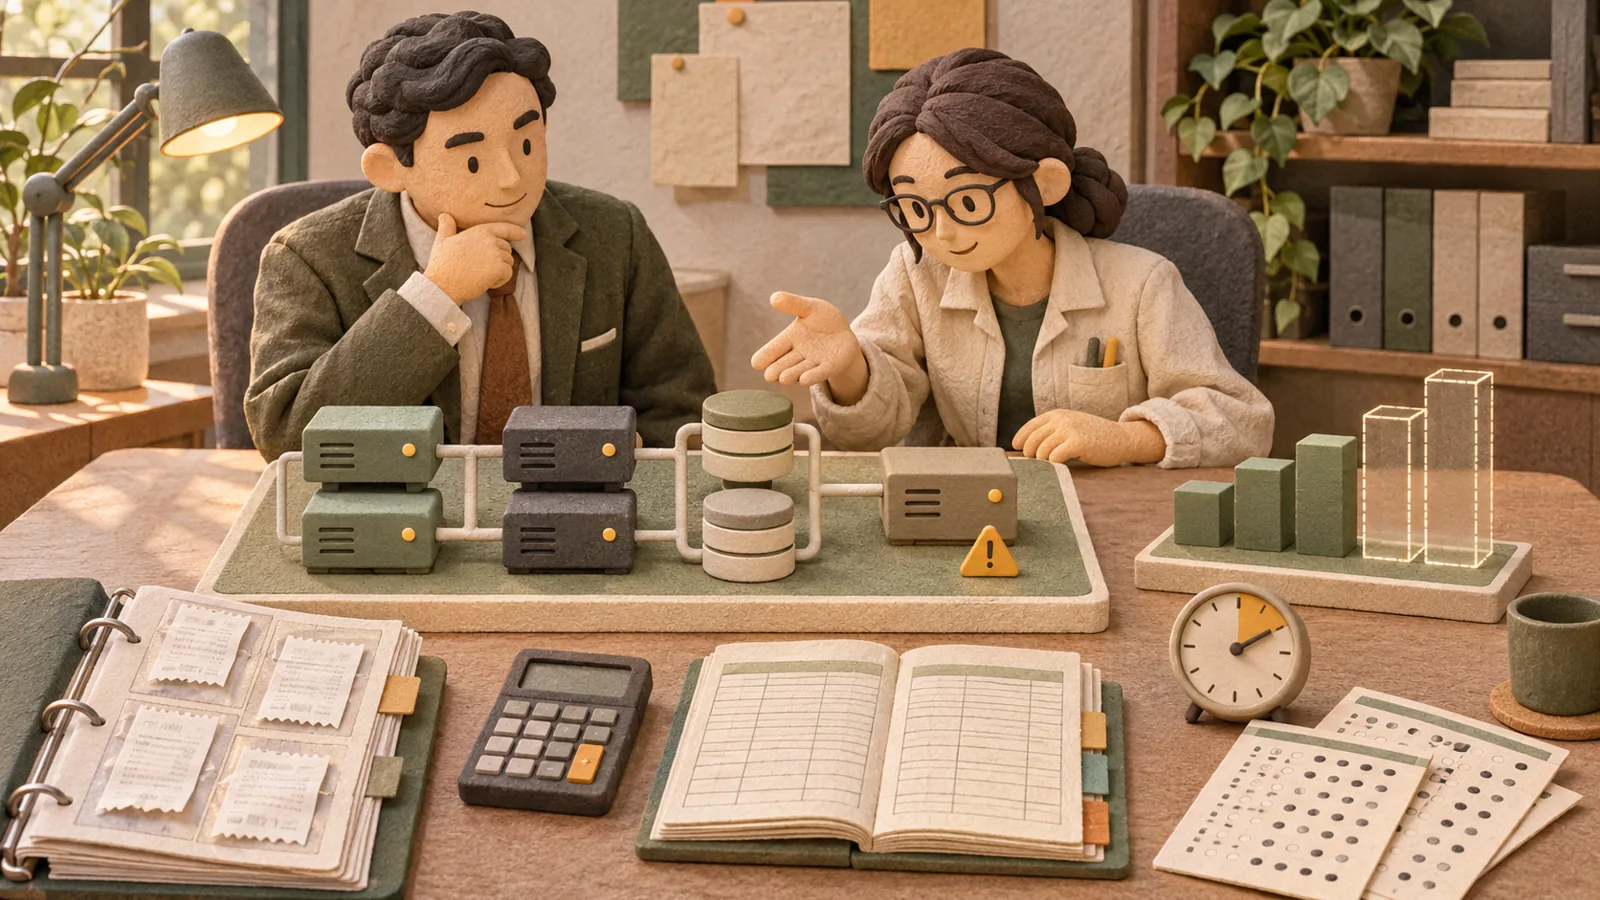
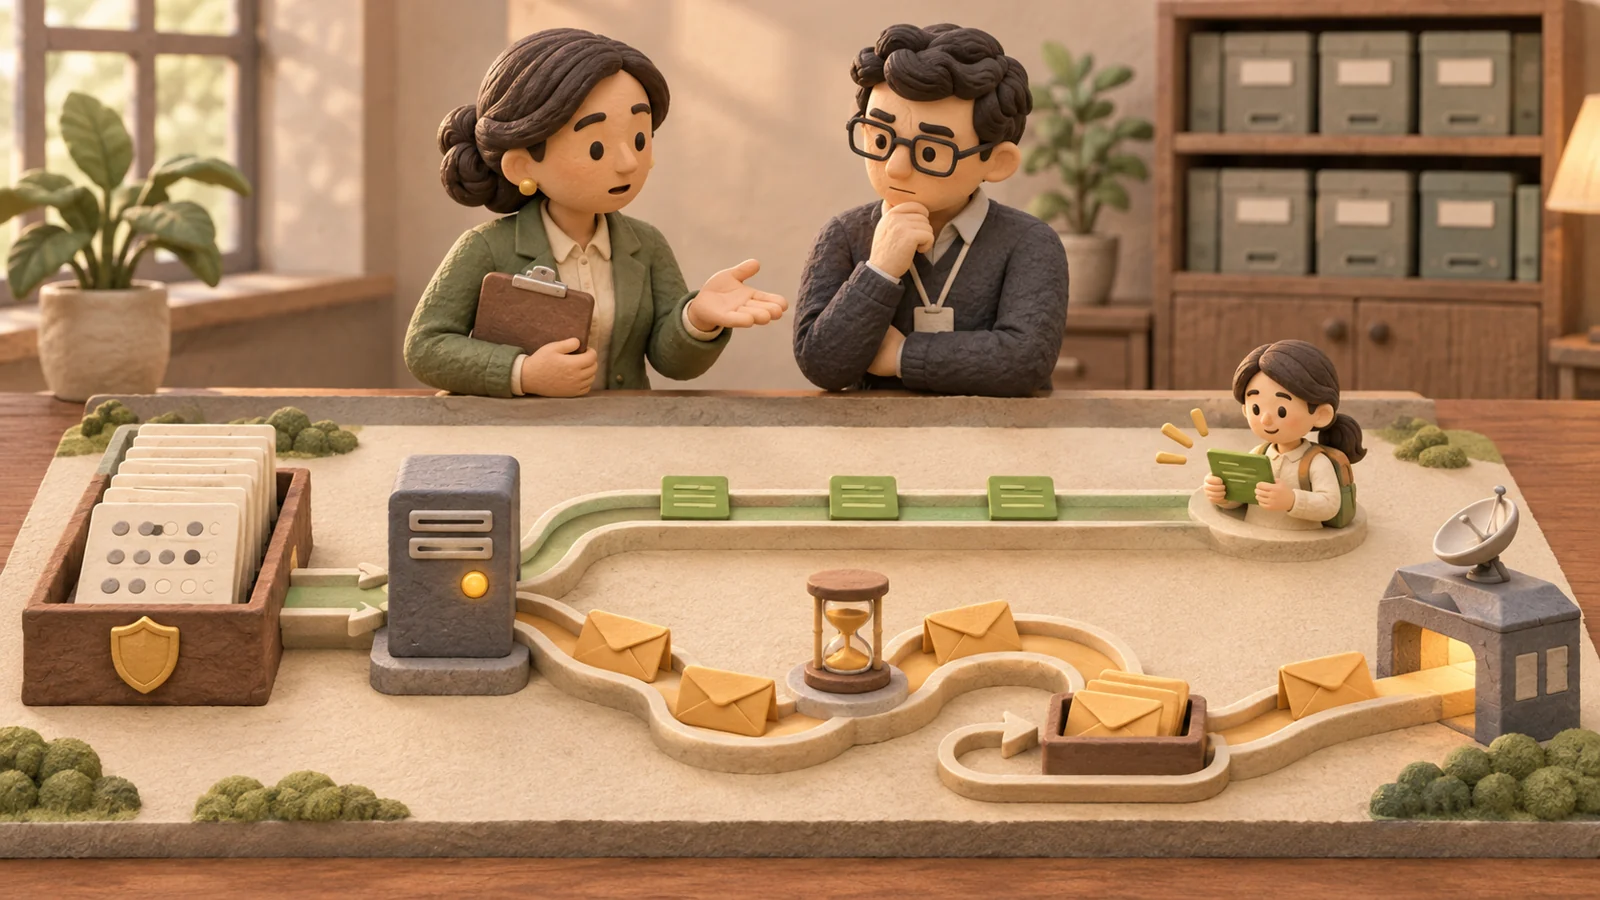
Kỳ thi bắt đầu vào một thời điểm cố định. Học viên đến cùng lúc và nền tảng phải tiếp nhận bài làm trong khi đồng hồ vẫn chạy. Mua một server lớn hơn không giải quyết những câu hỏi quan trọng: điều gì xảy ra khi một node hỏng, một dịch vụ dùng chung bị chậm lại hoặc một lần deploy làm gián đoạn request đang xử lý?
Trong case study gồm năm phần này, chúng tôi theo dõi một nền tảng khóa học và thi trực tuyến từ kiến trúc ban đầu đến những thay đổi được thực hiện cho đợt peak đã lên lịch. Phần 1 trình bày cách chúng tôi xác định rủi ro trước khi lựa chọn hạ tầng.
Giới thiệu case: NovaCommerce là tên đã ẩn danh. Cấu hình và số đo bên dưới đến từ hồ sơ dự án tháng 9–10 năm 2026. Chúng mô tả nền tảng và workload đó, không phải benchmark của Store Console. Hướng dẫn kỹ thuật chung đã được rà soát ngày 3 tháng 11 năm 2026.
Bắt đầu từ sự kiện kinh doanh
Lưu lượng trung bình trong một ngày bình thường là chỉ dẫn kém cho năng lực phục vụ kỳ thi. Sự kiện gây tải lớn diễn ra trong phút đầu: học viên tải câu hỏi, kiểm tra session và bắt đầu bài thi gần như cùng lúc.
Chúng tôi chuyển sự kiện này thành bốn yêu cầu:
Sẵn sàng trước khi bắt đầu. Năng lực phải ổn định ngay khi học viên bắt đầu thi.
Bảo vệ các bài đã được xác nhận gửi. Xác định thời điểm một câu trả lời được lưu bền vững và cách thao tác retry tránh tạo bản trùng.
Không để các thay đổi làm gián đoạn công việc đang thực hiện. Deploy và loại bỏ node cần health check và drain request.
Giúp chi phí có thể được giải thích. Mỗi tài nguyên định kỳ nên đáp ứng một nhu cầu năng lực đã đo hoặc một tình huống hỏng đã xác định.
Đây là các yêu cầu, không phải tuyên bố rằng mọi kịch bản hỏng đã được kiểm thử.
Kiến trúc ban đầu và các điểm yếu của nó
Các điểm hỏng ban đầu và bằng chứng nghiệm thu cần có trước kỳ thi. Đây là sơ đồ giảng dạy của case lịch sử, không phải cam kết availability đã được đo.
Frontend chạy một Next.js container trên Droplet 8 vCPU, 16 GB, không có load balancer phía trước. Mất frontend có thể khiến website công khai ngừng hoạt động. Backend được tách b better: hai node 4 vCPU, 8 GB phục vụ Laravel qua nginx và PHP-FPM, còn background job, scheduler và WebSockets chạy trên một worker riêng.
Backend load balancer nhắm đến các Droplet ID cố định. Vì vậy, thêm một server mới vẫn cần đăng ký; cấu hình không tự động phát hiện năng lực mới. Session, cache và queue đã được externalize sang Valkey được quản lý, giúp thay thế web node dễ dàng hơn.
MySQL có một managed node 8 vCPU, 32 GB và không có standby được cấu hình. Một managed service có thể thay thế node bị hỏng, nhưng khác với việc có sẵn một standby được replicate để đảm nhận. Worker đơn lẻ cũng là một điểm hỏng cho công việc bất đồng bộ.
Hai Droplet bổ sung được giữ ở trạng thái tắt như năng lực khôi phục. Chúng có thể hỗ trợ quy trình khôi phục nhưng không phục vụ lưu lượng và không thể cung cấp automatic failover.
Một sự phân biệt hữu ích: Một JavaScript event loop có thể giới hạn CPU-heavy rendering, nhưng Node.js còn sử dụng worker pool và native operation. Việc chỉ có một container không chứng minh rằng bảy trong tám core đang nhàn rỗi. Số process phù hợp phải dựa trên profiling và load test.
Định nghĩa availability bằng một bài kiểm thử có thể chạy
Thay vì gắn nhãn “highly available” cho toàn bộ nền tảng, chúng tôi hỏi người dùng nên trải nghiệm như thế nào trong một tình huống hỏng cụ thể.
Web node hỏng: Các node vẫn ổn định tiếp tục phục vụ; node bị hỏng ngừng nhận lưu lượng mới.
Database hỏng: Một failover path đã được tài liệu hóa khôi phục dịch vụ, còn ứng dụng xử lý các kết nối gián đoạn tạm thời.
Deploy: Node thay thế sẵn sàng trước khi node cũ ngừng nhận lưu lượng; các request đang xử lý có thời gian hoàn tất.
Peak đã lên lịch: Năng lực đủ lớn phải ổn định trước sự kiện, đồng thời có headroom dự phòng cho lưu lượng không đều.
Availability và độ bền vững dữ liệu cần bằng chứng riêng biệt. Web node stateless giúp có thể thay thế; bản thân chúng không bảo đảm câu trả lời tồn tại. Điều đó còn phụ thuộc vào database commit, replication, cấu hình persistence, xử lý retry, backup và kiểm thử khôi phục. Thiết kế single-region cũng không bảo đảm khôi phục sau khi toàn bộ khu vực bị gián đoạn.
Ba phát hiện, ba cách ứng phó khác nhau
1. HTTP 429: bộ giới hạn đếm sai danh tính
Ngày 25 tháng 9, học viên dùng chung mạng trường hoặc nhà mạng di động đều nhận thông báo “too many requests”. API limiter sử dụng địa chỉ IP của họ vì không phân giải được danh tính đã xác thực dự kiến. Vì vậy, nhiều người dùng chung một hạn mức.
Sau khi sửa, hạn mức đã xác thực được gắn với tài khoản học viên hoặc giảng viên, đồng thời giữ phương án dự phòng theo IP cho khách. Thêm server sẽ không thay đổi quy tắc này. Giới hạn theo danh tính vẫn cần biện pháp chống lạm dụng riêng; đây không phải lý do để bỏ throttling.
2. Valkey connection timeout: một dependency dùng chung bị hỏng khi chịu tải
Bài kiểm thử ngày 6 tháng 10 ghi nhận 2.854 application error do Valkey connection timeout. Hồ sơ case mô tả việc tạo kết nối TLS mới làm tăng overhead và thay đổi cấu hình từ primary-and-standby 4 GB sang 8 GB cho mỗi node.
Sau khi thay đổi quy mô, một lần tăng tải từ từ từ 25–500 request/giây ghi nhận không có application error, nhưng có 143 load-balancer error trong khi CPU của backend bị bão hòa. Đây là bằng chứng cho thấy lỗi application timeout đã được loại bỏ trong lần chạy đó. Đây không phải một lượt kiểm thử end-to-end hoàn chỉnh ở tải cao nhất: các request vẫn thất bại.
Chỉ một timeout không đủ để kết luận thiếu bộ nhớ. Với một hệ thống khác, hãy điều tra connection churn, giới hạn, hành vi mạng và service metric trước khi giả định rằng gói lớn hơn là câu trả lời.
3. Backend CPU: năng lực trở thành ràng buộc tiếp theo
Với tổ hợp API được kiểm thử, một backend node 4 vCPU đạt khoảng 65–70 request/giây khi CPU đã hoạt động hết công suất. Đây là điểm bão hòa được quan sát, không phải mục tiêu vận hành an toàn hoặc benchmark có thể chuyển giao. Giảm tải cho CPU và tăng năng lực đều là các lựa chọn cần đánh giá.
Trong một bài kiểm thử, node autoscaled bổ sung đầu tiên xuất hiện khoảng bảy phút sau khi CPU đạt 99%. Độ trễ này mang tính đặc thù của cấu hình này. Với một kỳ thi đã lên lịch, cách ứng phó thực tế là pre-scale và xác minh khả năng sẵn sàng trước khi bắt đầu.
Giữ mức so sánh chi phí minh bạch
Ngân sách ban đầu của case ước tính web tier ở mức khoảng 416 USD/tháng, bao gồm 112 USD/tháng cho các Droplet đang tắt. Đây là số liệu lịch sử tháng 9–10 năm 2026; chúng không bao gồm database, Valkey và storage. Không nên so sánh chúng với hóa đơn full-stack sau này.
DigitalOcean vẫn tính phí các reserved CPU Droplet ngay cả khi chúng đang tắt. Năng lực dự phòng lạnh có đáng giá hay không phụ thuộc vào thời gian khôi phục mà nó thực sự mang lại. Hãy xác định tài nguyên này giải quyết lỗi gì, có thể hỗ trợ ra sao và quy trình đó được kiểm thử lần gần nhất khi nào.
Gói của provider cũng thay đổi. Tài liệu hiện hành của DigitalOcean thông báo các hạn chế đối với gói PostgreSQL và MySQL Standard Edition bắt đầu từ ngày 15 tháng 10 năm 2026 với các tài khoản chưa từng tạo PostgreSQL hoặc MySQL cluster và ngày 30 tháng 11 năm 2026 với mọi tài khoản. Hãy kiểm tra điều kiện sử dụng và giá của gói hiện hành trước khi tái tạo một cấu hình lịch sử.
Áp dụng cùng quy trình rà soát trước đợt peak tiếp theo
Với một kỳ thi, lần ra mắt sản phẩm hoặc đợt tăng checkout, hãy ghi lại critical request path. Xác định từng dependency dùng chung và hỏi điều gì xảy ra khi nó không khả dụng. Sau đó, kiểm thử workload dự kiến và đo successful response, tail latency cùng các lỗi trên toàn bộ đường đi.
Thay đổi lớp mà bằng chứng chỉ ra, rồi lặp lại bài kiểm thử. Mục tiêu là một dịch vụ có thể xử lý sự kiện kinh doanh trong failure và recovery budget đã xác định.
Cấu hình case, số lượng sự cố và kết quả quan sát trong kiểm thử đến từ hồ sơ dự án lịch sử. Các nguồn bên dưới hỗ trợ những giải thích chung, không phải các số đo riêng tư đó.
Đã rà soát ngày 6 tháng 11 năm 2026. Một câu trả lời được chấp nhận cần có biên nhận lưu bền vững rõ ràng, operation identifier và một retry path idempotent. Một job đã được đưa vào queue không phải bản sao duy nhất của câu trả lời. Standby, backup và một bài kiểm thử restore thành công giải quyết các vấn đề khác nhau; không riêng yếu tố nào chứng minh rằng không có dữ liệu nào bị mất. Số lượng sự cố lịch sử bên dưới được giữ nguyên từ hồ sơ case hiện có, không được đo lại độc lập trong lần rà soát biên tập này.