The Result Was Fast. Its Queue Was Not — NovaCommerce 4
A 0.34-second result job waited behind slow AI work. Separate lanes helped, but durable submissions, bounded retries and worker recovery still mattered.
Anichur Rahaman1 mese fa6min

A 26-minute database cutover looked complete until a legacy panel wrote to the old copy. The lesson is writer control, reconciliation and honest recovery.
Autore
Anichur Rahaman

Alle 22:59 del 5 ottobre 2026 è terminata la finestra pianificata per il database. Il sito è tornato online dopo 26 minuti. Alle 23:24 il team ha scoperto un vecchio pannello di amministrazione che continuava a scrivere sul database precedente. L’applicazione era stata migrata; non lo era stata l’intera popolazione dei suoi writer.
NovaCommerce è una piattaforma anonimizzata per corsi ed esami. La Parte 3 preserva la documentazione storica del progetto settembre–ottobre e corregge le indicazioni generali che la riguardano. Questi conteggi storici non sono nuove misurazioni di produzione verificate né benchmark di StoreConsole.
Il vecchio MySQL gestito era un unico nodo da 8 vCPU/32 GB senza standby. La nuova configurazione storica era MySQL 8.4 Standard, con 4 vCPU/16 GB per nodo, primary e standby, per circa 11 GB di dati. Questo ha affrontato il guasto di un singolo nodo; non ha dimostrato l’assenza di perdita dati, di ritardo nel failover o di necessità di ripristino regionale.
La coppia da circa 389 $/mese rappresentava il budget storico del caso, non un’offerta attuale. DigitalOcean documenta ora le restrizioni della Standard Edition dal 15 ottobre 2026 per i nuovi account idonei e dal 30 novembre per tutti gli account. Verifica l’idoneità di account, piano e standby prima di ricreare la configurazione. Uno standby replica le modifiche ai dati, incluse le eliminazioni accidentali; non è un backup.
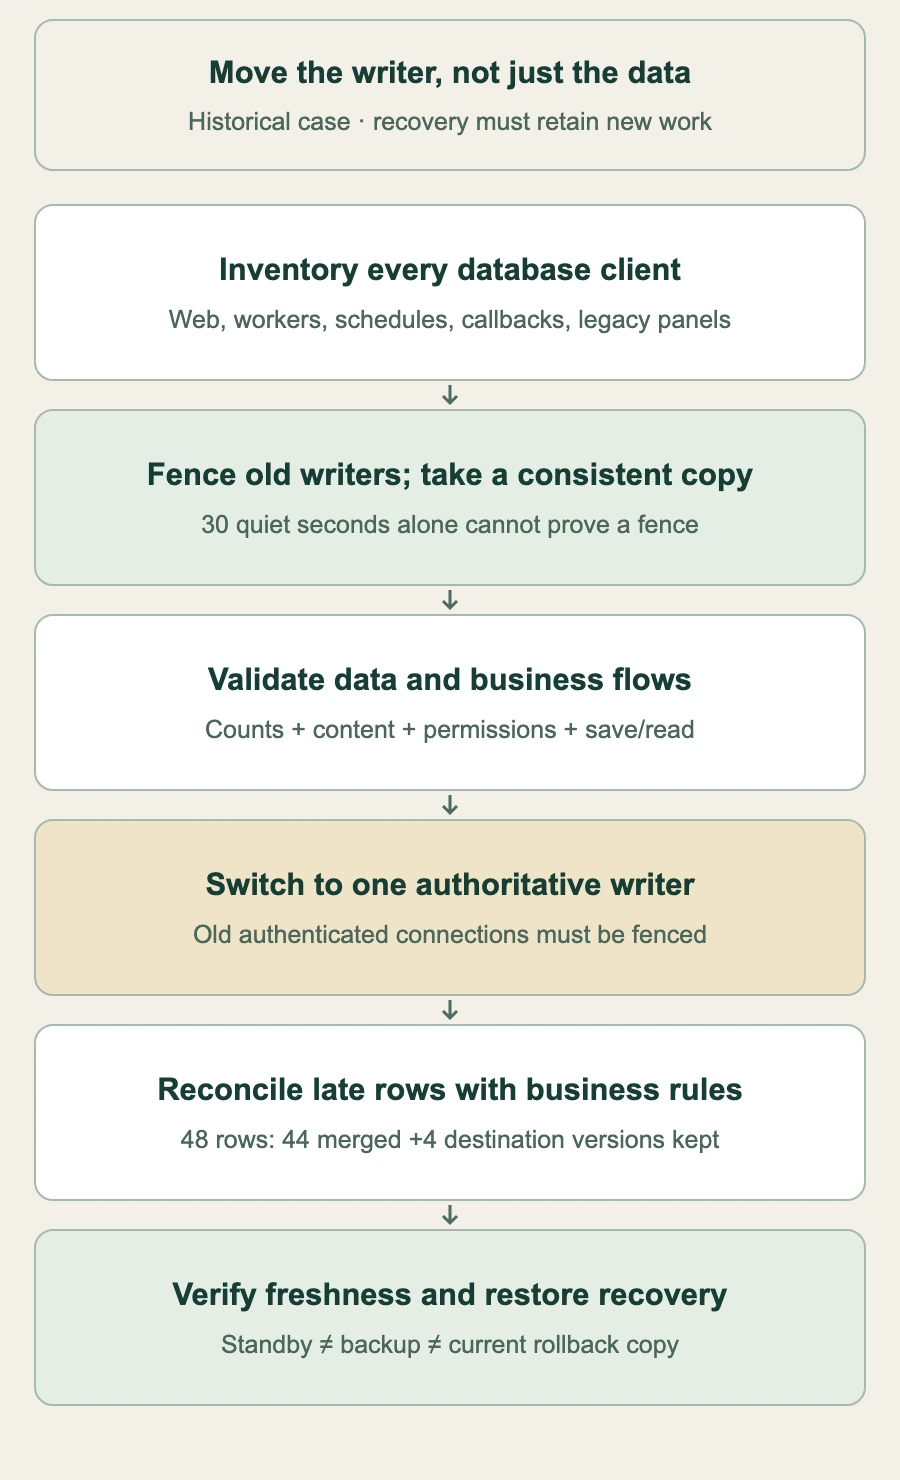
La documentazione descrive l’instradamento della manutenzione alle 22:33, lo svuotamento delle code, l’arresto delle attività pianificate, 30 secondi di osservazione senza scritture, una copia di circa dieci minuti, la validazione e le nuove immagini dell’applicazione prima delle 22:59. Una finestra di osservazione tranquilla non è una barriera: un client dimenticato può scrivere in un momento successivo. Occorre inventariare client web, worker, scheduler, callback, importazioni e pannelli esterni, quindi bloccare tutte le vecchie scritture prima di effettuare una copia coerente.
Il caso riporta totali di tabelle e righe coincidenti, verifiche successive del contenuto delle tabelle e un confronto dettagliato di un’ampia tabella dei risultati. Mantieni le prove di ciò che è stato confrontato, del relativo snapshot e del metodo utilizzato. I soli conteggi non dimostrano che i contenuti siano uguali e i confronti successivi al cutover richiedono un confine di riconciliazione esplicito. Verifica anche ruoli, schema, routine ed eventi ove utilizzati, set di caratteri e reali flussi di salvataggio e lettura delle risposte. Il mysqldump standard non è un motore di dump parallelo; non considerare reproducible per la coerenza un wrapper multi-stream non documentato.
| Osservazione storica | Valore registrato | Che cosa non dimostra |
|---|---|---|
| Totali delle copie | 341 tabelle; 18.727.244 righe | Conteggi uguali ≠ stato aziendale uguale |
| Confronto della tabella dei risultati più ampia | Circa 2,76 milioni di righe | L’ambito e il metodo devono essere conservati |
| Primi quattro minuti dopo la riapertura | Circa 2.900 richieste; 0 errori 5xx | Non tutti i flussi o writer successivi |
| Scritture legacy tardive | 48 = 44 accorporati + 4 conservati | Non è una policy di merge generica |
| Stima delle connessioni solo web | 10 × 80 = 800 | Lettura/scrittura, worker e sovrapposizione esclusi |
Il vecchio pannello ha aggiunto 48 righe al lato precedente. La riparazione storica ne ha accorpate 44 e ha conservato quattro versioni più recenti sul lato di destinazione, poi ha spostato quel pannello e cambiato le vecchie credenziali di accesso. Questa imputazione 44+4=48 descrive questo incidente, non un algoritmo generico e sicuro basato sul criterio “l’orario più recente vince”. Orologi, eliminazioni, righe dipendenti e modifiche concorrenti richiedono una riconciliazione consapevole delle regole aziendali e una pista di audit.
Interrompi i writer non intercettati e termina o in altro modo isola le connessioni esistenti; cambiare soltanto una password potrebbe non chiudere una sessione già autenticata. Verifica che le vecchie scritture siano respinte. Secondo quanto documentato, il vecchio cluster è stato mantenuto congelato per 48 ore. Una volta che il nuovo lato accetta il lavoro, la vecchia copia diventa materiale di ripristino, non una destinazione di rollback immediatamente aggiornata. Tornare a essa senza riconciliare le nuove risposte può far perdere lavoro già accettato. La conservazione deve seguire procedure di ripristino testate e obblighi di conformità, non una regola universale di 48 ore.
Nel caso, standby e primary sono stati usati come host di lettura, con scritture sul solo primary e letture dal primary per il worker. Un endpoint supportato per le letture dallo standby può riutilizzare capacità a pagamento, ma condivide anche risorse di guasto e ripristino. Verifica il supporto del provider, il ritardo e il comportamento in caso di guasto; un reader dedicato non è sempre uno spreco.
Laravel sticky=true instrada le letture successive alla connessione di scrittura dopo una scrittura effettuata nella stessa richiesta. Da solo non protegge la richiesta successiva né ogni sessione utente. La freschezza tra richieste richiede un meccanismo esplicito e testato oppure letture dal primary per risposte authoritative. Più host di lettura non garantiscono un failover universale di due secondi né la riproduzione sicura di query arbitrarie. Testa separatamente il fallimento di una connessione rispetto a una query che è già stata eseguita.
La precedente stima di 10 nodi × 80 figli PHP-FPM = 800 conta soltanto una connessione per figlio. Un figlio può aprire connessioni di lettura e scrittura; due per figlio danno 1.600 prima di considerare il worker, le sessioni di amministrazione o la sovrapposizione durante il rolling deployment, rispetto al limite storico di 1.601. Prevedi ogni origine di connessione e ogni generazione di nodi. Il tetto di connessioni non garantisce il throughput.
Un’istanza PostgreSQL 17/pgvector separata conteneva gli embedding dell’AI, storicamente con 2 vCPU/4 GB. Una prova con 1 vCPU/2 GB è stata annullata quando il suo carico di lavoro ha richiesto maggiori risorse. Le istanze separate consentono di definire budget di CPU e memoria; pool applicativi condivisi, rete o provider possono comunque耦合are i guasti. Si tratta di una scelta relativa al carico di lavoro, non dell’affermazione che ogni offerta MySQL sia priva di funzionalità vettoriali.
La sera dell’esame del 7 ottobre, la documentazione riporta MySQL con CPU massima del 24,5%, media del 13,4%, al massimo cinque query in esecuzione e zero attese di lock osservate. Questi dati supportano soltanto la conclusione più ristretta che la finestra misurata non aveva saturato tali segnali. Non dimostrano un limite di 450 richieste/s né una capacità sei volte superiore: mix di query, contesa in scrittura, I/O e failover modificano il risultato.
Mantieni separate le credenziali applicative a privilegio minimo dai diritti di migrazione, limita l’accesso al database e testa il ripristino dei backup con controlli applicativi e obiettivi di ripristino misurati. Uno standby configurato, una copia riuscita e un ripristino riuscito sono tre prove diverse. La Parte 4 prosegue con le code e il worker che collegano ancora questo parco.
Revisionato il 6 novembre 2026. Anichur Rahaman, fondatore di StoreConsole. I dati del caso e i prezzi restano storici; le fonti primarie attuali supportano le precisazioni tecniche.
Informazioni sull'autore
Anichur Rahaman
Continua a leggere