The Result Was Fast. Its Queue Was Not — NovaCommerce 4
A 0.34-second result job waited behind slow AI work. Separate lanes helped, but durable submissions, bounded retries and worker recovery still mattered.
Anichur Rahaman1개월 전6분

실제 시험 두 번, 스케일 축소 실수 한 번, 유용한 계획 모델 하나. 최종 검토에서 관측 결과, 추정치, 운영 비용과 남은 복구 테스트를 구분합니다.
작성자
Anichur Rahaman
5개 중 5번째 파트
From One Server to Exam-Day Ready2026년 10월 7일에는 두 시험이 연달아 진행됐습니다. 사례 기록상 한 시험은 시작 661회, 제출 638회였고 다른 시험은 시작 439회, 제출 425회였습니다. 이후 시험 도중 풀의 최소값이 낮아졌습니다. 예상한 drain 없이 serving node 하나가 사라져 약 2분 동안 360건의 요청이 실패했습니다. 정상 동작한 서비스와 해당 실패 모두 결과에 포함해야 합니다.
NovaCommerce는 개인정보를 익명화한 과정·시험 플랫폼입니다. 마지막 편에서는 기존 9~10월 관찰 내용을 유지하고, 공개된 산술 계산을 다시 검증하며, 아직 입증되지 않은 부분을 명시합니다. 새로 반복한 부하 테스트나 StoreConsole 벤치마크가 아닙니다.
조사에서는 9월 25일의 IP 기반 제한기, 10월 6일 실행에서의 Valkey 연결 실패, 시험한 요청 구성에서 발생한 backend CPU 포화가 확인됐습니다. 원인마다 필요한 변경이 달랐습니다. ‘서버 추가’는 일부 용량 압박에 적합했지만, 올바른 ID 처리나 정상 작동하는 공유 서비스를 대신할 수는 없습니다.
기록에는 약 356 requests/s, p95 0.05 s, 오류 보고 0건인 frontend 실행이 포함돼 있습니다. 10월 5일에는 GET 기반 autoscaling 실행이 약 750 requests/s에 도달했으며, server 오류나 timeout은 보고되지 않았지만 HTTP 429가 약 4% 발생했습니다. 25~500의 ramp에서는 application 오류가 0건이었고 load-balancer 오류는 143건이었습니다. 각 실행의 요청 구성과 범위가 서로 다르므로, 가장 좋은 수치를 합쳐 성공적인 처리량 주장으로 만들면 안 됩니다.
이후 진행한 guarded rollout에서는 2초마다 219개의 probe를 실행했고 오류는 없었습니다. 이는 표본으로 수집한 유용한 증거일 뿐, 모든 요청·쓰기·장시간 연결이 무사했다는 증거는 아닙니다. 전체 업무 흐름 테스트에서는 단순한 HTTP status나 빠르게 캐시된 홈페이지를 넘어 인증된 정답 접수, 영속적인 receipt, 안전한 retry, 최종 결과를 검증해야 합니다.
638/661은 96.5%, 425/439는 96.8%로 반올림됩니다. 이는 제출 비율이지 가용성 비율이 아닙니다. 미제출에는 여러 원인이 있을 수 있습니다. 수치만으로 누락된 모든 제출을 기술적 실패로 단정하거나 데이터 손실이 전혀 없었다고 결론 내릴 수는 없습니다.
사례 보고서의 분 단위 로그에서는 backend peak가 약 69 requests/s였고, provider의 2분 집계값은 63 requests/s였습니다. 보고된 평균 기준으로 pool CPU는 47%에서 정점을 찍었지만, 한 node는 1분 동안 86%에 도달했습니다. MySQL CPU max는 24.5%, 평균은 13.4%였고, worker max는 46%였으며 기록된 failed job은 0건이었습니다. 집계 구간과 분모를 계속 드러내야 합니다. Failed job이 0건이라는 사실만으로 pending이나 lost work가 없다는 뜻은 아닙니다.
기존 CPU 추정치는 약 59 ms/request였습니다. 63 requests/s에서는 3.717 CPU-seconds/s이므로, 8 vCPU로 나누면 약 46.5%입니다. 47%와 가깝다는 점은 해당 가정 아래에서의 일관성 검사일 뿐, 인과관계나 선형 확장성을 증명하지 않습니다. scale-in 사건은 readiness, node별 부하, retirement에 각각 별도의 근거가 필요하다는 점을 보여줬습니다. 시험 시간대 runbook은 사람이 관리하는 통제 수단이었으며, 자동으로 강제된 금지가 아니었습니다.
과거의 planning model은 node당 backend 50 requests/s, 기본 트래픽 30 requests/s, 1.3의 imbalance factor, 학생당 시작 시점 요청 15건, 재실 학생당 0.025 requests/s를 가정했습니다. 50은 동일한 요청 구성과 합의된 latency target을 전제로 한 가설이지, 보편적으로 안전한 한계가 입증된 값이 아닙니다.
정상 node가 N개일 때 학생 허용량은 N×50÷1.3−30 requests/s입니다. 600초 join window에서는 학생 한 명당 15÷600+0.025=0.05 requests/s가 발생합니다. 120초라면 0.15입니다. Node 4개 기준 (4×50÷1.3−30)÷0.05≈2,477이며, 교육용 표에서는 2,400으로 내림합니다. 이는 유동적인 평균 모델로, burst, 불균등한 도착, 중단, 상관관계로 인해 여전히 한도를 초과할 수 있습니다.
1.3의 나눗값은 planning factor일 뿐, 30% idle capacity나 node 장애 자동 대응을 주장하는 값이 아닙니다. Node 하나를 잃는 시나리오는 별도로 모델링해야 합니다. 관찰된 소수 node 테스트보다 큰 행은 외삽값이며, 인증된 학생 수용 인원이 아닙니다. PDF 업로드, worker queue, database contention, provider limit은 이 backend 모델의 범위 밖에 있습니다. Database CPU가 낮다는 사실만으로 450 requests/s 상한이나 6배의 headroom을 입증할 수는 없습니다.
| 정상 backend node | 모델 허용 requests/s | 600초 join: 반올림한 학생 수 | 120초 join: 반올림한 학생 수 |
|---|---|---|---|
| 2 | ≈77 | 900 | 300 |
| 4 | ≈154 | 2,400 | 800 |
| 6 | ≈231 | 4,000 | 1,300 |
과거 설계는 독립적인 frontend/backend pool을 각각 최소 2개, 최대 10개로 운영했고, primary/standby MySQL, 공유 Valkey, 별도 PostgreSQL/pgvector, object storage, OpenSearch의 backend log를 사용했습니다. 하나의 고정 worker가 queue, scheduling, WebSockets, SMS를 모두 담당했습니다. 이 worker는 계속 single point of failure였고, frontend log shipping과 worker standby는 계획만 되어 있었습니다.
복제된 database, stateless web node, image는 특정 recovery path를 개선합니다. 하지만 모든 dependency를 redundant하게 만들거나 regional failure, 잘못된 deployment, unauthorized access, 잘못된 삭제를 방지하지는 못합니다. Write fencing과 restore는 별도로 테스트해야 합니다. 오래된 frozen data는 새로운 write 이후의 현재 rollback 상태가 아니며, image rollback에는 호환되는 schema, session, queued payload도 필요합니다.
제시된 과거 월간 web 항목의 합계는 $272입니다. backend $112 + frontend $56 + worker $56 + load balancer 2개 $48입니다. Data와 log의 합계는 $709입니다. MySQL $389 + Valkey $240 + PostgreSQL $60 + OpenSearch $20입니다. Snapshot $5와 Spaces base $5를 더하면 variable usage 전 $991입니다. 기존 ‘약 $990’은 반올림한 값이지 정확한 invoice가 아닙니다.
이전의 $416은 power-off 상태의 recovery Droplet까지 포함한 web tier 비용으로, 당시 full-stack 총비용은 아닙니다. 범위와 service assumption이 동일한지 확인한 뒤에야 $416과 $272를 비교해야 하며, 새로 합산한 $991과는 비교할 수 없습니다. 이 목록에는 인력, support, 세금, provider AI/SMS, overage, 임시 rollout/peak capacity가 제외돼 있습니다. Total cost of ownership나 현재 quotation이 아닙니다.
현재 provider plan과 계정 eligibility를 확인해야 합니다. 3부에서 설명한 MySQL Standard 변경 사항 때문에 과거의 두 대 구성을 2026년 구매 레시피로 검증 없이 적용하기에는 부적절합니다. 더 큰 reliability budget이 가치 있을 수는 있지만, 비교 가능한 service와 완전한 operating model이 뒷받침할 때만 절감 효과를 주장할 수 있습니다.
| 과거 월간 그룹 | 제시된 소계 | 범위 |
|---|---|---|
| Web tier | $272 | backend 2개 +frontend 2개 +worker +load balancer 2개 |
| Data와 log | $709 | MySQL +Valkey +PostgreSQL +OpenSearch |
| Snapshot과 storage base | $10 | $5 +$5, usage 별도 |
| 제시된 combined base | $991 | usage, 인력, 세금, 기타 service 제외 |
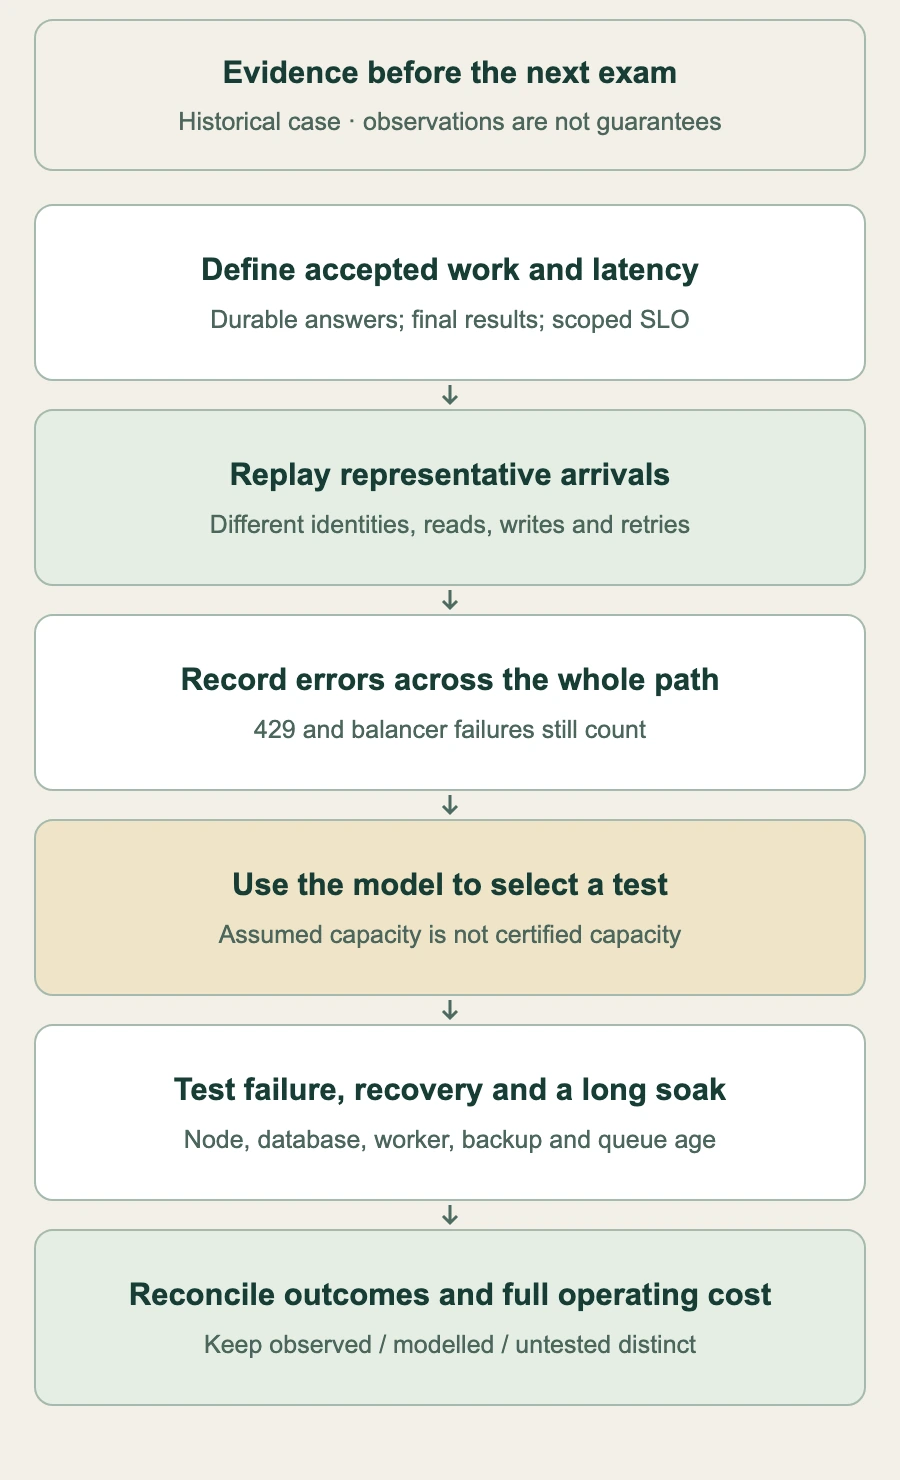
기록에는 공식 다시간 soak과 전체 혼합 write-path 부하 테스트가 계속 계획된 것으로 남아 있습니다. 2시간 시험 관찰은 통제된 soak 테스트가 아니었습니다. 24시간 동안 local write가 없었다는 관찰만으로 memory leak, connection 증가, queue 증가를 배제할 수는 없습니다. 이러한 공백을 조용히 ‘passed’로 바꾸지 마세요.
다음 대규모 행사 전에는 정답 접수 성공 기준과 latency threshold를 합의하고, 대표성 있는 ID와 도착 형태를 사용하며, 중복 제출과 마감 시점 동작을 테스트해야 합니다. Memory, connection, storage, oldest-job age를 관찰할 만큼 충분히 지속하고, node failure, 안전한 scale-in, database 재연결/failover, worker recovery, backup restoration을 포함해야 합니다. Tool version, script, resource setting, error, 접수된 작업의 대조를 기록해야 합니다. 방해가 되는 테스트는 격리된 대표 환경이나 중지 기준이 승인된 시간대에 실행해야 합니다.
시리즈는 활용 가능한 decision loop으로 끝납니다. 업무 결과를 측정하고, constraint를 찾고, 관련 layer를 바꾼 뒤, 결과와 recovery를 다시 테스트합니다. 가장 가치 있는 산출물은 ‘관찰됨’, ‘모델링됨’, ‘아직 테스트되지 않음’을 혼동하지 않고 구분해 기록할 수 있는 evidence register입니다.
2026년 11월 6일 검토. Anichur Rahaman, StoreConsole founder. 과거 관찰 내용은 유지하고 산술은 검증했으며, 외삽값과 계획된 테스트는 명시적으로 구분했습니다.
작성자 소개
Anichur Rahaman
계속 읽기