The Result Was Fast. Its Queue Was Not — NovaCommerce 4
A 0.34-second result job waited behind slow AI work. Separate lanes helped, but durable submissions, bounded retries and worker recovery still mattered.
Anichur Rahamanför 1 månad sedan6min

Två riktiga prov, ett misstag när kapaciteten skalades ned och en användbar planeringsmodell. Genomgången skiljer observationer, extrapoleringar, driftskostnader och återställningstester som återstår.
Författare
Anichur Rahaman
Den 7 oktober 2026 hölls två prov i följd. Ärendeposten visar 661 starter och 638 inlämnningar i det ena provet samt 439 starter och 425 inlämnningar i det andra. Därefter sänktes minimipoolen mitt under provet: en serveringsnod försvann utan den förväntade avlastningen, och cirka 360 förfrågningar misslyckades på två minuter. Både den fungerande tjänsten och felet hör till resultatet.
NovaCommerce är en anonymiserad plattform för kurser och prov. Den här slutdelen behåller befintliga observationer från september–oktober, beräknar om den publicerade aritmetiken och anger vad som fortfarande inte är bevisat. Det är varken ett nytt upprept lastningstest eller en StoreConsole-benchmark.
Undersökningen hittade en IP-baserad begränsare den 25 september, problem med Valkey-anslutningar i en körning den 6 oktober och CPU-mättnad i backend för den testade blandningen av förfrågningar. Olika orsaker krävde olika åtgärder. ”Fler servrar” passade för viss kapacitetsbelastning men ersatte varken korrekt identitetshantering eller en fungerande delad tjänst.
Underlaget omfattar en frontend-körning med cirka 356 förfrågningar/s, p95 0,05 s och noll rapporterade fel; en GET-baserad autoskaleringskörning den 5 oktober som nådde cirka 750 förfrågningar/s, inga rapporterade serverfel eller timeouts men cirka 4 % HTTP 429; samt en ramp mellan 25 och 500 med noll applikationsfel men 143 fel från lastbalanseraren. De här körningarna har olika blandningar och omfattningar. Kombinera inte deras bästa värden till ett enda påstående om framgångsrik genomströmning.
Den skyddade driftsättningen hade senare 219 kontroller, varannann sekund, med noll fel. Det är användbart stickprov som bevis, men inte ett bevis för att varje förfrågning, skrivning eller lång koppling överlevde. Ett fullständigt test av affärsflödet måste validera mottagandet av autentiserade svar, beständiga kvittenser, säkra försök på nytt och slutresultat, inte bara HTTP-status eller en snabbt cagrad startsida.
638/661 blir 96,5 %; 425/439 blir 96,8 %. Detta är andelar inlämnade svar, inte tillgänglighetsprocent. Att svar inte lämnades in kan ha flera orsaker; antalen bevisar inte att varje utebliven inlämning beror på ett tekniskt fel eller att inga data gick förlorade.
Ärendet rapporterar en topp i backend på cirka 69 förfrågningar/s utifrån minutsloggarna, jämfört med 63 i leverantörens tvåminutersaggregering. Poolens CPU toppade vid 47 % i den rapporterade genomsnittliga nivån, medan en nod nådde 86 % under en minut. MySQL:s CPU var som mest 24,5 % i genomsnitt 13,4 %; workern som mest 46 %, med noll registrerade misslyckade jobb. Håll aggregeringsfönster och nämnare synliga. Noll misslyckade jobb betyder inte att inget arbete väntade eller förlorades.
Den gamla CPU-uppskattningen var cirka 59 ms/förfrågning. Vid 63 förfrågningar/s blir det 3,717 CPU-sekunder/s; delat med åtta vCPU blir det cirka 46,5 %. Att värdet ligger nära 47 % är en konsistenskontroll under dessa antaganden, inte ett bevis för orsakssamband eller linjär skalning. Incidenten vid nedskalning visade varför beredskapskontroll, belastning per nod och utfasning kräver var sitt underlag. Runbooken för provtider var en mänsklig kontroll, inte ett upprätthållande förbud.
Den historiska planeringsmodellen antog 50 backend-förfrågningar/s per nod, en baslinjep trafik på 30 förfrågningar/s, en obalansfaktor på 1,3, 15 öppningsförfrågningar per student och 0,025 förfrågningar/s per närvarande student. Behandla 50 som en hypotes för samma blandning av förfrågningar och ett överenskommet latenstidsmål, inte som en bevisat universellt säker gräns.
För N friska noder är studentbudgeten N×50÷1,3−30 förfrågningar/s. Med ett 600-sekunders anslutningsfönster bidrar varje student med 15÷600+0,025=0,05 förfrågningar/s. Med 120 sekunder blir det 0,15. För fyra noder blir resultatet (4×50÷1,3−30)÷0,05≈2 477; undervisningstabellen avrundar nedåt till 2 400. Det här är en flytande genomsnittsmodel: toppar, ojämn ankomst, pauser och samvariation kan fortfarande överskrida den.
Divisorn 1,3 är planeringsfaktorn och innebär inte ett påstående om 30 % outnyttjad kapacitet eller automatisk täckning av nodfel. Modellera förlusten av en nod separat. Rader ovanför de observerade testerna med få noder är extrapolationer, inte certifierad studentkapacitet. PDF-uppladdningar, worker-köer, databaskonkurrens och leverantörens gränser ligger utanför den här backendmodellen. Låg databas-CPU bevisar inte en gräns på 450 förfrågningar/s eller sexfaldig marginal.
| Friska backendnoder | Modellerad budget, förfrågningar/s | 600-sekunders anslutning: avrundade studenter | 120-sekunders anslutning: avrundade studenter |
|---|---|---|---|
| 2 | ≈77 | 900 | 300 |
| 4 | ≈154 | 2 400 | 800 |
| 6 | ≈231 | 4 000 | 1 300 |
Den historiska designen hade oberoende pooler för frontend och backend, med två som minimum och tio som maximum för vardera; primär/backup-MySQL; delad Valkey; separat PostgreSQL/pgvector; objektlagring; och backendloggar i OpenSearch. En fast worker hanterade fortfarande köer, schemaläggning, WebSockets och SMS. Workern förblev en enda felpunkt; loggöverföring från frontend och backup för workern var planerad.
En replikerad databas, tillståndslösa webbnoder och containerbilder förbättrar vissa återställningsvägar. De gör inte varje beroende redundant och skyddar inte mot ett regionalt fel, en felaktig driftsättning, obehörig åtkomst eller felaktig borttagning. Testa skrivspärr och återställning separat. Gammal fryst data är inte en aktuell återrullning efter nya skrivningar; återrullning av containerbilder kräver också kompatibla schema, sessioner och köade payloads.
De historiska månatliga webbposterna uppgår till $272: backend $112 + frontend $56 + worker $56 + två lastbalanserare $48. Data och loggar uppgår till $709: MySQL $389 + Valkey $240 + PostgreSQL $60 + OpenSearch $20. Genom att lägga till ögonblicksbilder $5 och Spaces-bas $5 blir summan $991 innan variabel förbrukning. Den gamla uppskattningen på ”cirka $990” var avrundad, inte en exakt faktura.
Den tidigare siffran på $416 beskrev webbnivån inklusive avstängda återställnings-Droplets; den var inte den gamla fullstackkostnaden. Jämför $416 med $272 först när identiskt omfång och samma tjänsteantaganden har bekräftats, inte med den nya sammanlagda siffran på $991. Listan utesluter personal, support, skatter, leverantörens AI/SMS, överförbrukning och tillfällig kapacitet för driftsättning eller toppar; den är inte den totala ägandekostnaden eller en aktuell offert.
Kontrollera leverantörens aktuella planer och kontots behörighet. Ändringarna av MySQL Standard som beskrivs i del 3 gör det historiska paret olämpligt som en okontrollerad inköpsplan för 2026. En större budget för tillförlitlighet kan vara motiverad, men ett besparing påstående kräver jämförbara tjänster och en fullständig driftmodell.
| Historisk månadskostnad per grupp | Angiven delsumma | Omfattning |
|---|---|---|
| Webbnivå | $272 | 2 backend +2 frontend +worker +2 lastbalanserare |
| Data och loggar | $709 | MySQL +Valkey +PostgreSQL +OpenSearch |
| Ögonblicksbilder och lagringsbas | $10 | $5 +$5; förbrukning tillkommer |
| Angiven sammanlagd bas | $991 | Före förbrukning, personal, skatter och övriga tjänster |
I ärendeposten fanns fortfarande planer på ett formellt flertimmes-longt soak-test och ett fullständigt lastningstest av alla skrivvägar. Den två timmar långa provobservationen var inte ett kontrollerat soak-test. En 24-timmarsobservation utan lokala skrivningar utesluter inte minnesläckor, ökande antal anslutningar eller växande köer. Beteckna inte de här luckorna som ”godkända” i smyg.
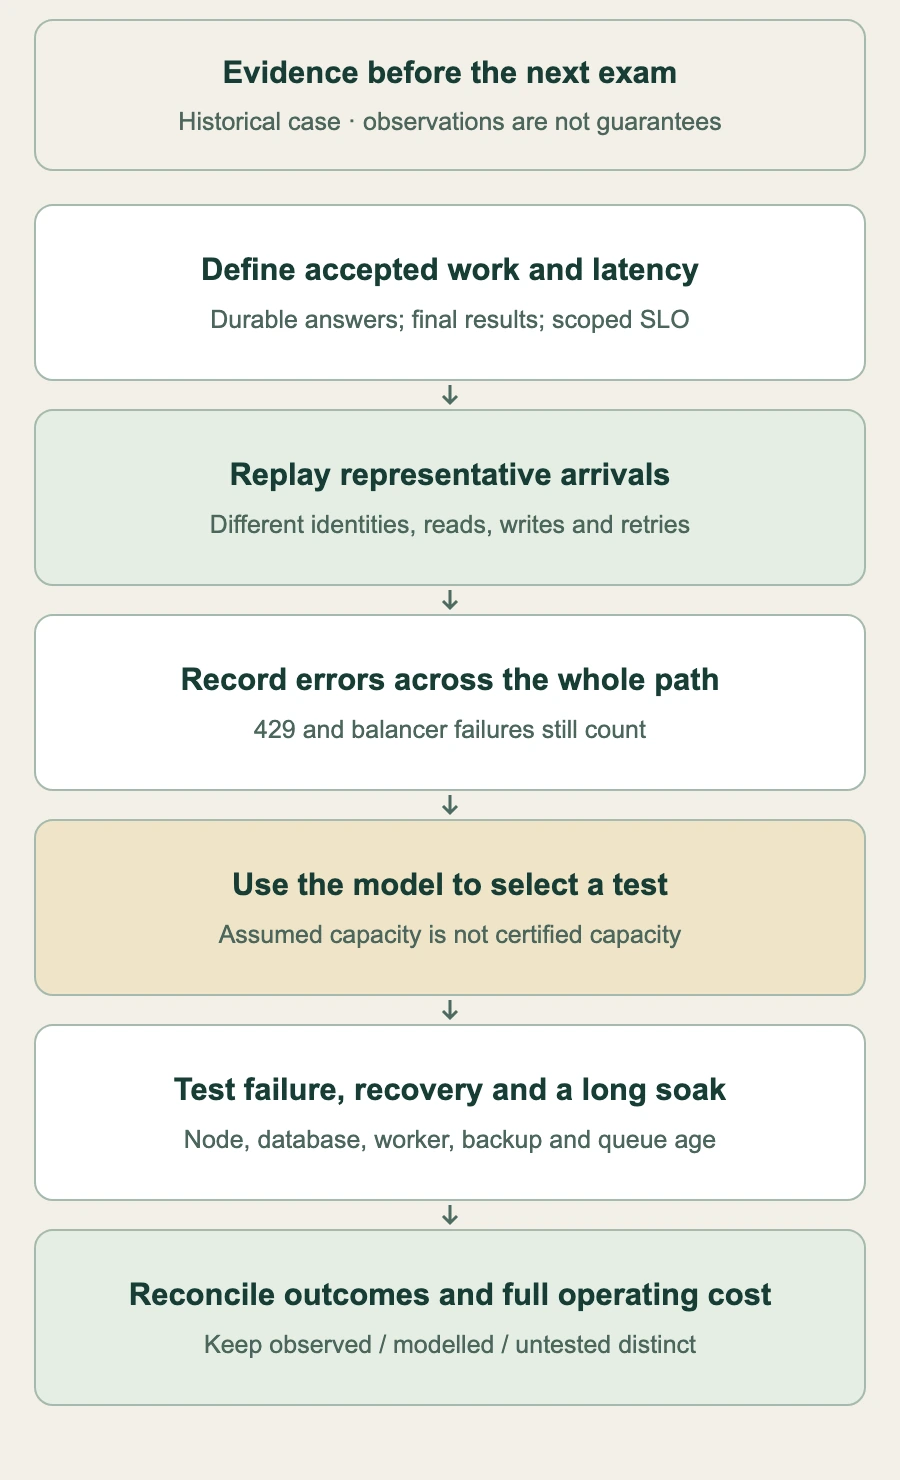
Före nästa större evenemang, kom överens om gränser för godkända svar och latenstid; använd representativa identiteter och en realistisk ankomstprofil; testa dubbla inlämnningar och beteende vid deadlines; kör tillräckligt länge för att observera minne, anslutningar, lagring och ålder på det äldsta jobbet. Ta med nodfel, säker nedskalning, återanslutning/överkoppling av databasen, återställning av worker och återställning från backup. Dokumentera verktygsversioner, skript, resursinställningar, fel och avstämning av godkänt arbete. Kör disruptive tester i en isolerad, representativ miljö eller under ett godkänt fönster med stoppkriterier.
Serien slutar med en användbar beslutscykel: mät affärsutfallet, lokalisera begränsningen, ändra relevant lager och testa sedan om både utfallet och återställningen. Dess mest värdefulla artefakt är ett evidensregister som kan ange ”observerat”, ”modellerat” eller ”inte än testat” utan att blanda ihop dem.
Granskad den 6 november 2026. Anichur Rahaman, grundare av StoreConsole. Historiska observationer bevarade; aritmetiken kontrollerad; extrapolationer och planerade tester uttryckligen åtskilda.
Om författaren
Anichur Rahaman
Fortsätt läsa