The Result Was Fast. Its Queue Was Not — NovaCommerce 4
A 0.34-second result job waited behind slow AI work. Separate lanes helped, but durable submissions, bounded retries and worker recovery still mattered.
Anichur Rahaman1 เดือนที่แล้ว6นาที

A 26-minute database cutover looked complete until a legacy panel wrote to the old copy. The lesson is writer control, reconciliation and honest recovery.
ผู้เขียน
Anichur Rahaman

ส่วนที่ 3 จาก 5
From One Server to Exam-Day Readyเมื่อเวลา 22:59 น. ของวันที่ 5 ตุลาคม 2026 ช่วงฐานข้อมูลตามแผนสิ้นสุด เว็บไซต์กลับมาใช้งานได้หลังจาก 26 นาที เมื่อเวลา 23:24 น. ทีมพบว่าแผงผู้ดูแลระบบเก่ายังเขียนข้อมูลไปยังฐานข้อมูลเดิม แอปพลิเคชันย้ายแล้ว แต่ writer ทุกตัวยังย้ายไม่ครบ
NovaCommerce คือแพลตฟอร์มเรียนและสอบที่ใช้ข้อมูลนิรนาม ส่วนที่ 3 รักษาบันทึกโครงการเดิมช่วงเดือนกันยายน–ตุลาคมไว้ และปรับแก้คำแนะนำทั่วไปรอบโครงการดังกล่าว ตัวเลขเชิงประวัติศาสตร์เหล่านี้ไม่ใช่ผลวัดจากระบบ production ที่ตรวจสอบใหม่หรือ benchmark ของ StoreConsole
MySQL แบบ managed เดิมเป็น node เดียวขนาด 8 vCPU/32 GB และไม่มี standby ระบบใหม่ตามบันทึกเชิงประวัติศาสตร์คือ MySQL 8.4 Standard แบบ 4 vCPU/16 GB ต่อ node ประกอบด้วย primary และ standby สำหรับข้อมูลประมาณ 11 GB การตั้งค่านี้แก้ปัญหาเส้นทางที่ระบบล่มจาก node เดียว แต่ไม่ได้พิสูจน์ว่าไม่มีการสูญเสียข้อมูล ไม่มีความล่าช้าในการ failover หรือกู้คืนข้ามภูมิภาค
คู่เครื่องราคาประมาณ $389/เดือนเป็นงบของเคสในอดีต ไม่ใช่ข้อเสนอราคาปัจจุบัน ปัจจุบัน DigitalOcean ระบุข้อจำกัดของ Standard Edition สำหรับบัญชีที่มีสิทธิ์เข้าใช้ใหม่ตั้งแต่วันที่ 15 ตุลาคม 2026 และสำหรับทุกบัญชีตั้งแต่วันที่ 30 พฤศจิกายน ตรวจสอบสิทธิ์ของบัญชี แพ็กเกจ และ standby ก่อนทำระบบให้เหมือนเดิม ต้องจำไว้ว่า standby จะตามการเปลี่ยนแปลงข้อมูล รวมถึงการลบโดยไม่ตั้งใจ จึงไม่ใช่ backup
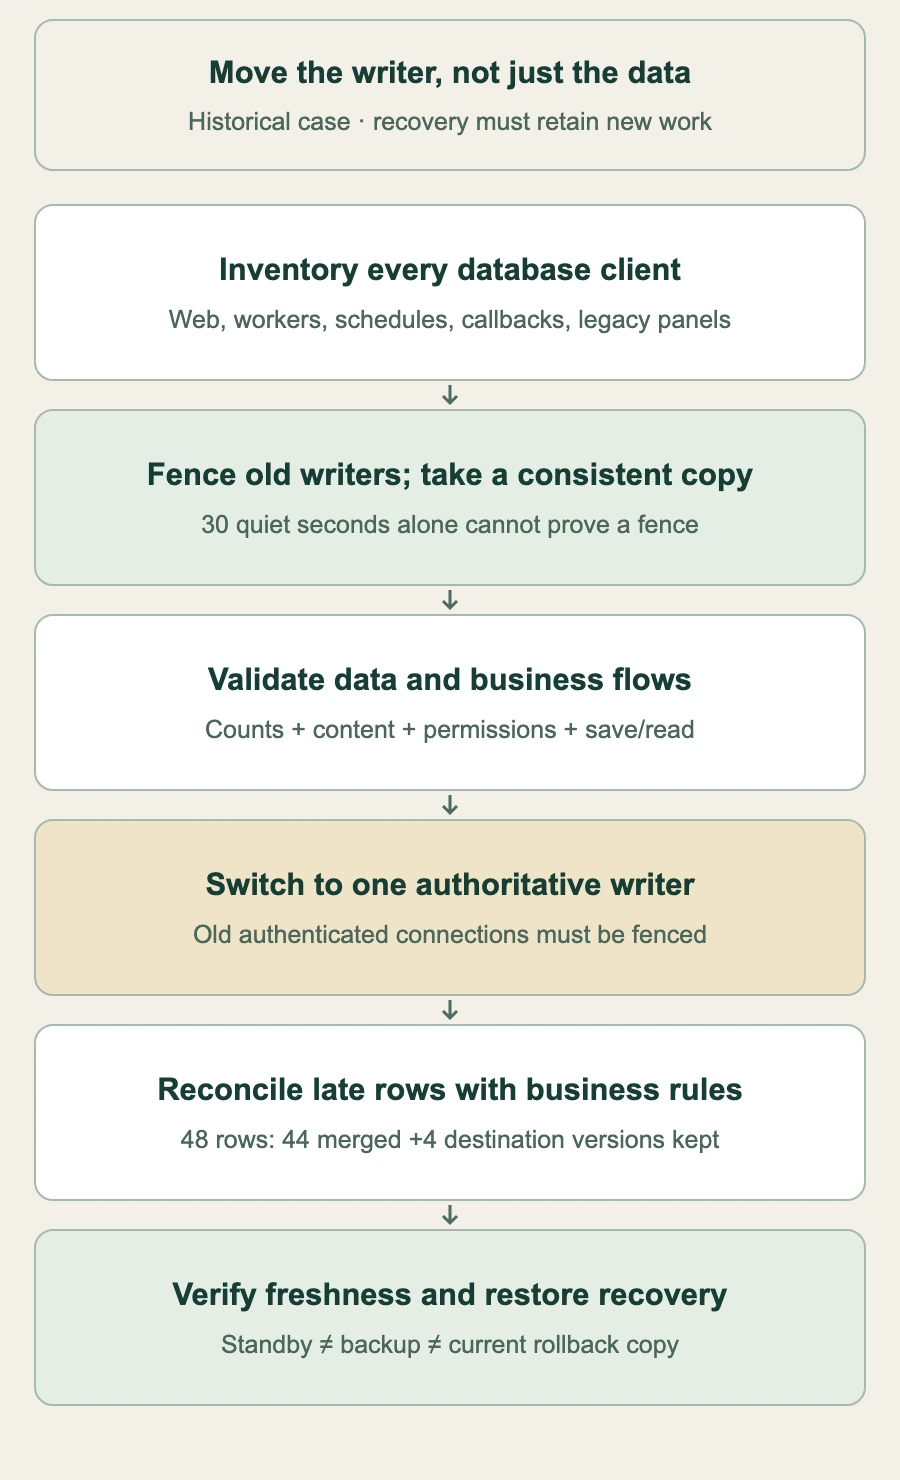
บันทึกระบุถึงการจัดเส้นทางการบำรุงรักษาเมื่อเวลา 22:33 น. การ drain queue การหยุดงานตามตาราง การสังเกตว่าไม่มีการเขียนข้อมูลติดต่อกัน 30 วินาที การคัดลอกข้อมูลประมาณ 10 นาที การตรวจสอบ และการสร้างแอป image ใหม่ก่อนเวลา 22:59 น. ช่วงที่ไม่มีการเขียนข้อมูลไม่ใช่ fence เพราะ client ที่ถูกลืมอาจเขียนข้อมูลในภายหลัง ต้องสำรวจ inventory web, worker, scheduler, callback, import และแผงภายนอก แล้วบล็อกการเขียนข้อมูลทั้งหมดของระบบเก่าก่อนถ่ายสำเนาที่สอดคล้องกัน
เคสรายงานจำนวนตารางและแถวที่ตรงกัน การตรวจสอบเนื้อหาในตารางภายหลัง และการเปรียบเทียบอย่างละเอียดของตารางผลลัพธ์ขนาดใหญ่ ต้องเก็บหลักฐานว่าเปรียบเทียบอะไร ณ snapshot ใด และด้วยวิธีใด ตัวเลขเพียงอย่างเดียวไม่พิสูจน์ว่าเนื้อหาเท่ากัน และการเปรียบเทียบหลัง cutover ต้องมีขอบเขตการ reconcile ที่ระบุชัดเจน ตรวจสอบ role, schema, routine/event ในส่วนที่มีใช้งาน, character set และ flow การบันทึกและอ่านคำตอบจริงด้วย mysqldump มาตรฐานไม่ใช่เครื่องมือสำหรับ parallel dump อย่างไรก็ตาม อย่าถือว่า multi-stream wrapper ที่ไม่มีเอกสารเป็นสูตรสร้างความสอดคล้องที่ทำซ้ำได้
| ผลการสังเกตในอดีต | ค่าที่บันทึกไว้ | สิ่งที่ไม่ได้พิสูจน์ |
|---|---|---|
| จำนวนตารางและแถวที่คัดลอก | 341 ตาราง; 18,727,244 แถว | จำนวนเท่ากัน ≠ สถานะทางธุรกิจเท่ากัน |
| การเปรียบเทียบตารางผลลัพธ์ที่ใหญ่ที่สุด | ประมาณ 2.76 ล้านแถว | ต้องคง scope/method ไว้ |
| 4 นาทีแรกหลังเปิดใช้งานอีกครั้ง | ประมาณ 2,900 requests; 0 รายการที่ได้ 5xx | ไม่ครอบคลุมทุก flow หรือ writer ที่เกิดขึ้นภายหลัง |
| การเขียนข้อมูลของระบบเก่าที่ล่าช้า | 48 = 44 ที่รวม + 4 ที่คงไว้ | ไม่ใช่นโยบาย merge แบบทั่วไป |
| การประมาณจำนวน connection สำหรับ web เท่านั้น | 10 × 80 = 800 | ไม่รวม read/write, worker และช่วงเวลาที่ระบบเก่าและใหม่ทำงานซ้อนกัน |
แผงระบบเก่าเพิ่มข้อมูล 48 แถวในฝั่งเก่า การซ่อมแซมตามบันทึกเชิงประวัติศาสตร์รวม 44 แถวและคงเวอร์ชันใหม่กว่า 4 แถวในปลายทางไว้ จากนั้นย้ายแผงดังกล่าวและเปลี่ยน access credential ของระบบเก่า บัญชี 44+4=48 นี้อธิบายเหตุการณ์ครั้งนี้เท่านั้น ไม่ใช่อัลกอริทึม “timestamp ล่าสุดชนะ” ที่ปลอดภัยสำหรับกรณีทั่วไป เวลาในระบบ, การลบ, แถวที่มี dependency และการแก้ไขพร้อมกัน ต้องใช้การ reconcile ที่เข้าใจธุรกิจและมี audit trail
หยุด writer ที่พลาด และปิดการเชื่อมต่อที่มีอยู่ด้วยการ terminate หรือวิธี fence อื่น เพราะการเปลี่ยนเฉพาะรหัสผ่านอาจไม่ปิด session ที่ยืนยันตัวตนแล้ว ต้องตรวจสอบว่าไม่มีการเขียนข้อมูลของระบบเก่า มีรายงานว่า cluster เก่าถูกแช่แข็งไว้ 48 ชั่วโมง เมื่อฝั่งใหม่เริ่มรับงาน สำเนาฝั่งเก่าจะเป็นข้อมูลสำหรับ recovery ไม่ใช่ปลายทาง rollback ที่พร้อมใช้งานทันที การย้อนกลับโดยไม่ reconcile คำตอบใหม่อาจทำให้งานที่รับไว้แล้วสูญหาย ระยะเวลาเก็บรักษาควรพิจารณาจากการกู้คืนที่ทดสอบแล้วและข้อผูกพันที่เกี่ยวข้อง ไม่ใช่กฎ 48 ชั่วโมงแบบทั่วไป
เคสนี้ใช้ standby และ primary เป็น read host โดยเขียนไปยัง primary และให้ worker อ่านจาก primary endpoint ของ standby ที่รองรับการอ่านสามารถใช้ capacity ที่จ่ายเงินไว้ซ้ำได้ แต่ก็ใช้ทรัพยากรสำหรับ failure/recovery ร่วมกัน ต้องตรวจสอบการรองรับของ provider, lag และพฤติกรรมเมื่อเกิด failure เพราะ reader แยกเฉพาะไม่ได้หมายความว่าสิ้นเปลืองเสมอไป
Laravel sticky=true จะส่งการอ่านหลังจากมีการเขียนใน request เดียวกันไปยัง write connection แต่เพียงอย่างเดียวไม่ได้คุ้มครอง request ถัดไปหรือทุก user session การรับประกันความสดข้อมูลข้าม request ต้องมีกลไกที่ทดสอบแล้วและชัดเจน หรืออ่านจาก primary เพื่อให้ได้คำตอบที่เป็นข้อมูลอ้างอิงหลัก หลาย read host ไม่ได้ทำให้เกิด failover ภายใน 2 วินาทีแบบทั่วไป หรือ replay query ใด ๆ ได้อย่างปลอดภัย ต้องทดสอบ connection failure แยกจาก query ที่ทำงานเสร็จแล้ว
การประมาณเดิม 10 nodes × 80 PHP-FPM children = 800 นับเพียง connection 1 ตัวต่อ child แต่ child แต่ละตัวอาจเปิด read และ write connection ได้ หากมี 2 ตัวต่อ child จะเป็น 1,600 ก่อนนับ worker, admin session หรือช่วง rolling overlap และเกินขีดจำกัดเดิม 1,601 ต้องคำนวณงบจากทุกแหล่งของ connection และทุก generation ของ node เพราะเพดาน connection ไม่ใช่การรับประกัน throughput
instance แยกของ PostgreSQL 17/pgvector ใช้เก็บ AI embedding โดยในอดีตใช้ทรัพยากร 2 vCPU/4 GB การทดลอง 1 vCPU/2 GB ถูกย้อนกลับเมื่อ workload ต้องการทรัพยากรมากกว่านั้น instance แยกช่วยแยกงบ CPU/หน่วยความจำ แต่ application pool, network หรือ provider ที่ใช้ร่วมกันยังอาจเชื่อมโยงความล้มเหลวได้ นี่เป็นทางเลือกด้าน workload ไม่ใช่ข้อยืนยันว่า MySQL ทุกแบบไม่มีความสามารถด้าน vector
เมื่อเวลา 21:00 น. ของวันที่ 7 ตุลาคมในค่ำคืนวันสอบ บันทึกระบุว่า CPU สูงสุดของ MySQL อยู่ที่ 24.5% เฉลี่ย 13.4% มี query ที่กำลังทำงานสูงสุด 5 รายการ และไม่พบ lock wait ผลเหล่านี้สนับสนุนข้อสรุปที่แคบกว่าว่า ช่วงที่วัดไม่ได้ทำให้สัญญาณเหล่านี้อิ่มตัว แต่ไม่ได้พิสูจน์เพดาน 450 requests/s หรือ capacity 6 เท่า เพราะ query mix, write contention, I/O และ failover ส่งผลต่อค่าที่ได้
แยก credential ของแอปตาม least privilege ออกจากสิทธิ์ migration จำกัดการเข้าถึงฐานข้อมูล และทดสอบการกู้คืน backup พร้อม application check และ recovery objective ที่วัดได้ การตั้งค่า standby, การคัดลอกสำเร็จ และการกู้คืนสำเร็จ เป็นหลักฐาน 3 ส่วนที่แตกต่างกัน ส่วนที่ 4 จะติดตาม queue และ worker ที่ยังเชื่อมต่ออยู่กับ fleet นี้
ตรวจทานเมื่อวันที่ 6 พฤศจิกายน 2026 Anichur Rahaman ผู้ก่อตั้ง StoreConsole ตัวเลขและราคาในเคสยังคงเป็นข้อมูลเชิงประวัติศาสตร์ แหล่งข้อมูลหลักในปัจจุบันสนับสนุนข้อจำกัดด้านเทคนิคเหล่านี้
ข้อมูลผู้เขียน
Anichur Rahaman
อ่านต่อ