The Result Was Fast. Its Queue Was Not — NovaCommerce 4
A 0.34-second result job waited behind slow AI work. Separate lanes helped, but durable submissions, bounded retries and worker recovery still mattered.
Anichur Rahaman1 ماہ قبل6منٹ

A 26-minute database cutover looked complete until a legacy panel wrote to the old copy. The lesson is writer control, reconciliation and honest recovery.
مصنف
Anichur Rahaman

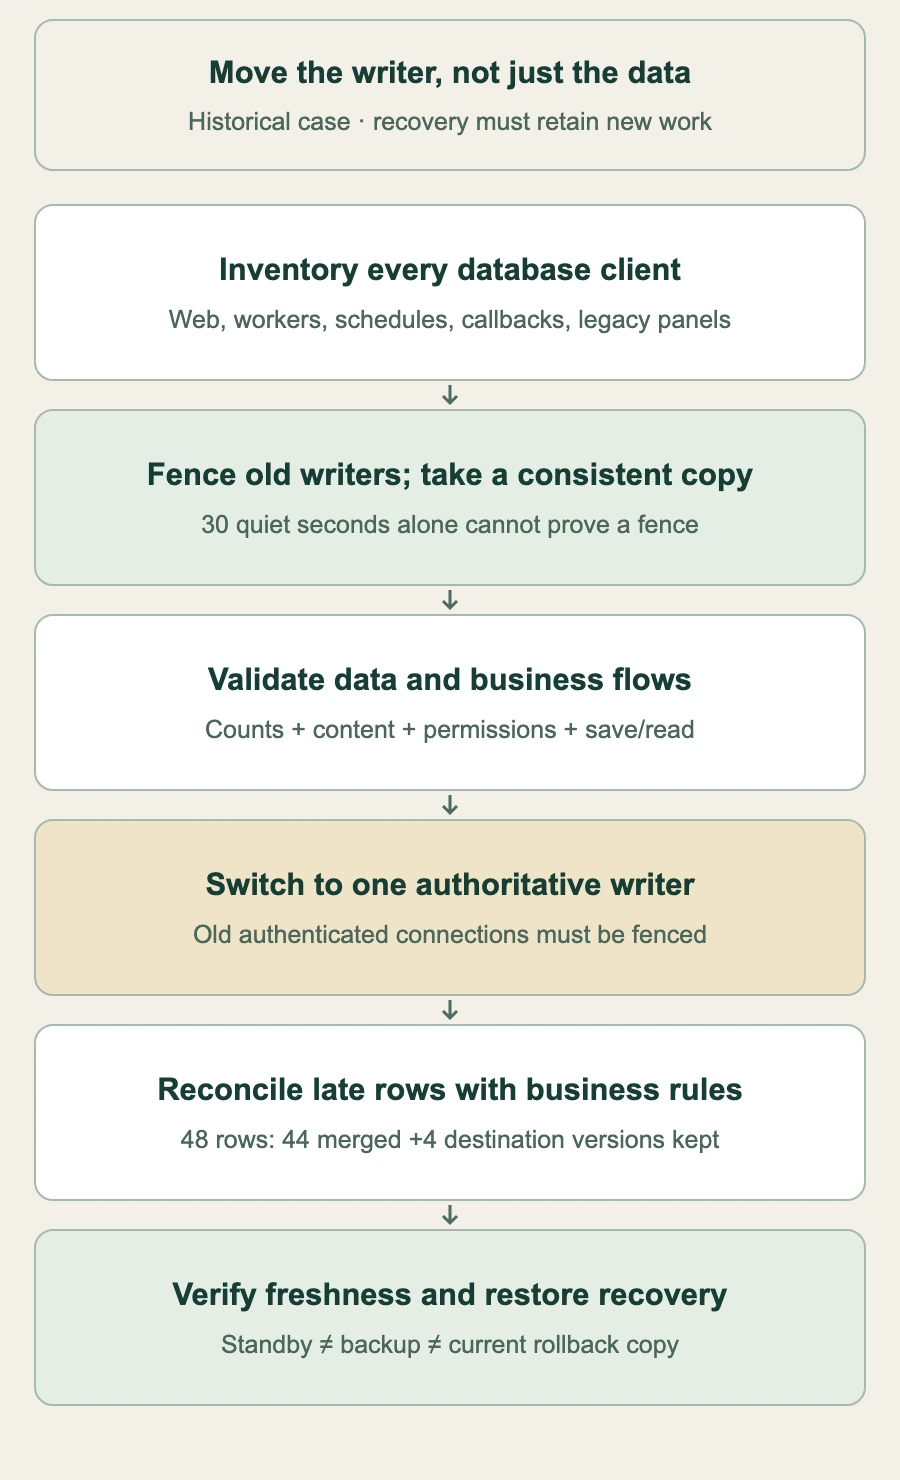
5 اکتوبر 2026 کو رات 22:59 پر منصوبہ بند database window ختم ہوا۔ سائٹ 26 منٹ بعد بحال ہو گئی۔ 23:24 پر ٹیم کو پتا چلا کہ ایک پرانا admin panel اب بھی پرانے ڈیٹابیس میں لکھ رہا تھا۔ application منتقل ہو چکا تھا، لیکن اس کے تمام writers نہیں منتقل ہوئے تھے۔
NovaCommerce ایک anonymised course-and-exam platform ہے۔ حصہ 3 موجود ستمبر–اکتوبر منصوبے کی ریکارڈ برقرار رکھتا ہے اور اس کے اردگرد کی عمومی رہنمائی درست کرتا ہے۔ یہ تاریخی اعداد و شمار نئے طور پر audit شدہ production measurements یا StoreConsole benchmarks نہیں ہیں۔
پرانا managed MySQL ایک 8 vCPU/32 GB node تھا جس کے ساتھ کوئی standby نہیں تھا۔ نئی تاریخی setup MySQL 8.4 Standard تھی، ہر node پر 4 vCPU/16 GB، primary کے ساتھ standby، تقریباً 11 GB data کے لیے۔ اس سے single-node failure کا راستہ حل ہوا؛ مگر اس نے zero data loss، zero failover delay یا regional recovery کی تصدیق نہیں کی۔
تقریباً $389/month والا pair ایک تاریخی case budget تھا، موجودہ offer نہیں۔ DigitalOcean اب نئے eligible accounts کے لیے 15 اکتوبر 2026 اور تمام accounts کے لیے 30 نومبر سے Standard Edition کی restrictions دستیاب کراتا ہے۔ Setup دہرانے سے پہلے account، plan اور standby کی eligibility جانچیں۔ standby data changes کو follow کرتا ہے، جن میں accidental deletion بھی شامل ہے؛ یہ backup نہیں ہے۔
ریکارڈ میں 22:33 پر maintenance routing، queues کو drain کرنا، scheduled work روکنا، 30 سیکنڈ کے لیے کوئی write نہ ہونا، تقریباً دس منٹ کا copy، validation اور 22:59 سے پہلے نئے application images شامل ہیں۔ خاموش observation window ایک fence نہیں ہوتا: کوئی بھولے ہوئے client بعد میں بھی write کر سکتا ہے۔ Inventory web، workers، schedulers، callbacks، imports اور external panels کو inventories کریں، پھر consistent copy لینے سے پہلے تمام پرانے writes بلاک کریں۔
Case میں مطابقت رکھنے والے table/row totals، اس کے بعد table contents کے checks اور ایک بڑے results table کی تفصیلی comparison رپورٹ ہوئی۔ کیا موازنہ کیا گیا، کس snapshot پر اور کس طریقے سے ہوا، اس کا evidence محفوظ رکھیں۔ صرف counts برابر contents کی تصدیق نہیں کرتے، اور cutover کے بعد کی comparisons کے لیے واضح reconciliation boundary درکار ہے۔ Roles، schema، جہاں استعمال ہو routines/events، character sets اور اصل answer-save/read flows بھی جانچیں۔ معیاری mysqldump parallel-dump engine نہیں ہے؛ غیر دستاویز multi-stream wrapper کو reproducible consistency recipe نہ سمجھیں۔
| تاریخی observation | درج شدہ قدر | یہ کیا ثابت نہیں کرتا |
|---|---|---|
| Copy کے totals | 341 tables؛ 18,727,244 rows | برابر counts ≠ برابر business state |
| سب سے بڑے results کی comparison | تقریباً 2.76 million rows | Scope/method برقرار رکھنا ہوگا |
| دوبارہ کھلنے کے بعد پہلے چار منٹ | تقریباً 2,900 requests؛ 0 5xx | ہر بعد کا flow یا writer نہیں |
| دیر سے آنے والے پرانے writes | 48 = 44 merged + 4 retained | کوئی عمومی merge policy نہیں |
| صرف web connection کا تخمینہ | 10 × 80 = 800 | Read/write، worker اور overlap شامل نہیں |
پرانے panel نے پرانی طرف میں 48 rows شامل کیے۔ تاریخی repair نے 44 merge کیے اور چار نئیں destination versions محفوظ رکھے، پھر اس panel کو منتقل کیا اور پرانے access credentials تبدیل کیے۔ یہ 44+4=48 کا حساب اس incident کو بیان کرتا ہے، کسی محفوظ عامیت کے “latest timestamp wins” algorithm کو نہیں۔ Clocks، deletes، dependent rows اور concurrent edits کے لیے business-aware reconciliation اور audit trail درکار ہے۔
چھوڑے گئے writers کو روکیں اور موجودہ connections ختم کریں یا کسی اور طریقے سے fence کریں؛ صرف password تبدیل کرنے سے پہلے سے authenticated session بند نہیں ہو سکتا۔ تصدیق کریں کہ پرانے writesDenied ہیں۔ رپورٹ کے مطابق پرانا cluster 48 گھنٹے کے لیے frozen رکھا گیا تھا۔ نئی طرف کام قبول کرنے کے بعد پرانی copy recovery material ہے، فوراً current rollback destination نہیں۔ نئی answers کی reconciliation کے بغیر اس پر واپس جانا accepted work کو کھو سکتا ہے۔ Retention کو tested recovery اور obligations کے مطابق رکھیں، کسی universal 48-hour rule کے مطابق نہیں۔
Case میں standby اور primary کو read hosts استعمال کیا گیا، writes primary-only تھیں اور worker کے لیے reads primary سے لیے جاتے تھے۔ Supported standby-read endpoint paid capacity کو دوبارہ استعمال کر سکتا ہے، لیکن failure/recovery resources بھی شیئر کرتا ہے۔ Provider support، lag اور failure behaviour جانچیں؛ dedicated reader ہمیشہ waste نہیں ہوتا۔
Laravel کا sticky=true ایک request میں write کے بعد آنے والے reads کو write connection پر route کرتا ہے۔ یہ اکیلے اگلے request یا ہر user session کی حفاظت نہیں کرتا۔ Cross-request freshness کے لیے واضح اور test شدہ mechanism یا authoritative answers کے لیے primary reads درکار ہیں۔ متعدد read hosts کسی universal two-second failover یا arbitrary queries کے محفوظ replay کی تصدیق نہیں کرتے۔ Connection failure کو query کی execution سے الگ جانچیں۔
پرانے 10 nodes × 80 PHP-FPM children = 800 کا تخمینہ صرف ہر child کے ایک connection کو شمار کرتا ہے۔ ایک child read اور write connections دونوں کھول سکتا ہے؛ ہر child کے دو connections ہونے پر worker، admin sessions یا rolling overlap سے پہلے تعداد 1,600 ہو جاتی ہے، جو تاریخی 1,601 limit کے خلاف ہے۔ ہر connection source اور node generation کا budget بنائیں۔ Connection ceiling throughput guarantee نہیں ہے۔
ایک الگ PostgreSQL 17/pgvector instance میں AI embeddings تھیں، جو تاریخی طور پر 2 vCPU/4 GB پر چل رہی تھیں۔ 1 vCPU/2 GB کا trial واپس لے لیا گیا جب workload کو مزید resources کی ضرورت پڑی۔ الگ instances CPU/memory کے لیے الگ budgets فراہم کرتے ہیں؛ مشترکہ application pools، network یا providers پھر بھی failures کو آپس میں منسلک کر سکتے ہیں۔ یہ workload کا انتخاب ہے، اور یہ دعویٰ نہیں کہ ہر MySQL offering میں vector capabilities نہیں ہیں۔
7 اکتوبر کی امتحان کی رات، ریکارڈ کے مطابق MySQL CPU زیادہ سے زیادہ 24.5%، اوسط 13.4%، زیادہ سے زیادہ پانچ running queries اور صفر lock waits کے مشاہدے شامل ہیں۔ یہ اس تنگ نتیجے کی support کرتے ہیں کہ پیمائش شدہ window میں ان signals کی capacity پوری نہیں ہوئی۔ یہ 450 requests/s کی ceiling یا sixfold capacity ثابت نہیں کرتے: query mix، write contention، I/O اور failover نتیجہ بدل سکتے ہیں۔
Least-privilege application credentials کو migration rights سے الگ رکھیں، database access محدود کریں اور application checks اور پیمائش شدہ recovery objectives کے ساتھ backups restore کرنے کی جانچ کریں۔ Configured standby، successful copy اور successful restore تین مختلف شکل کے evidence ہیں۔ حصہ 4 queues اور worker کا پیچھا کرتا ہے جو اب بھی اس fleet سے جڑے ہیں۔
6 نومبر 2026 پر نظرثانیہ شدہ۔ Anichur Rahaman، StoreConsole founder۔ Case figures اور prices تاریخی رہے ہیں؛ موجودہ primary sources technical qualifications کی تصدیق کرتے ہیں۔
مصنف کے بارے میں
Anichur Rahaman
مطالعہ جاری رکھیں