The Result Was Fast. Its Queue Was Not — NovaCommerce 4
A 0.34-second result job waited behind slow AI work. Separate lanes helped, but durable submissions, bounded retries and worker recovery still mattered.
Anichur Rahaman1 ماہ قبل6منٹ

دو حقیقی امتحانات، اسکیل کم کرنے کی ایک غلطی اور منصوبہ بندی کا مفید ماڈل۔ آخری جائزہ مشاہدات، اندازوں، آپریٹنگ اخراجات اور باقی ٹیسٹوں کو الگ کرتا ہے۔
مصنف
Anichur Rahaman
7 اکتوبر 2026 کو دو امتحانیں لگاتار چلے۔ کیس ریکارڈ میں ایک میں 661 آغاز اور 638 جمع کرائے گئے جوابات، دوسرے میں 439 آغاز اور 425 جمع کرائے گئے جوابات درج ہیں۔ پھر امتحان کے دوران pool کا کم از کم سائز کم کر دیا گیا: ایک serving node متوقع drain کے بغیر غائب ہو گیا اور تقریباً 360 requests دو منٹ میں ناکام رہے۔ فعال سروس اور یہ خرابی، دونوں نتیجے کا حصہ ہیں۔
NovaCommerce ایک نام ظاہر نہیں کیا گیا course-and-exam platform ہے۔ اس آخری حصے میں ستمبر–اکتوبر کے موجودہ مشاہدے برقرار رکھے گئے ہیں، شائع شدہ حساب دوبارہ check کیا گیا ہے اور بتایا گیا ہے کہ کون سی باتیں اب بھی ثابت نہیں ہیں۔ یہ دوبارہ کیا گیا load test یا StoreConsole benchmark نہیں ہے۔
تحقیقات میں 25 ستمبر کو IP کے مطابق بننے والا limiter، 6 اکتوبر کی ایک run میں Valkey connection failures اور آزمائے گئے request mix کے لیے backend CPU saturation پایا گیا۔ مختلف وجوہات کے لیے مختلف تبدیلیاں درکار تھیں۔ کچھ capacity pressure کے لیے “مزید servers” مناسب تھے، مگر اس سے درست شناخت یا کام کرتی مشترکہ سروس کی جگہ نہیں لی جا سکتی تھی۔
ریکارڈز میں frontend کی تقریباً 356 requests/s کی ایک run شامل ہے جس میں p95 0.05 s اور کوئی reported errors نہیں تھے؛ 5 اکتوبر کی GET-based autoscale run تقریباً 750 requests/s تک پہنچی، جس میں کوئی reported server errors/timeouts نہیں تھے مگر تقریباً 4% HTTP 429 تھے؛ اور 25–500 کی ramp میں zero application errors تھے مگر 143 load-balancer errors تھے۔ ان runs کے mixes اور scopes مختلف ہیں۔ ان کی بہترین اعداد و اقوام کو ایک کامیاب throughput کے دعوے میں یہ نہ کریں۔
Guarded rollout میں بعد میں 219 probes ہوئے، ہر دو سیکنڈ، اور zero errors رہے۔ یہ sample کا شدہ ثبوت ہے، مگر یہ ثابت نہیں کرتا کہ ہر request، write یا لمبی connection محفوظ رہی۔ ایک مکمل business-flow test کو authenticated answer acceptance، durable receipts، safe retries اور final results کی تصدیق کرنی چاہیے، نہ کہ صرف HTTP status یا تیز cached ہوم پیج کی۔
638/661 = 96.5%؛ 425/439 = 96.8%۔ یہ submission کے proportions ہیں، availability کے percentages نہیں۔ Submission نہ کرنے کی کئی وجوہات ہو سکتی ہیں؛ ان counts سے ہر غائب submission کی وجہ technical failure کو نہیں کہا جا سکتا، نہ ہی zero data loss ثابت ہوتا ہے۔
کیس رپورٹس میں minute logs کے مطابق backend کا peak تقریباً 63 requests/s تھا، جبکہ provider کی دو منٹ کی aggregation میں یہ 63 تھا۔ Pool کا CPU reported average پر 47% تک پہنچا، جبکہ ایک node ایک منٹ کے لیے 86% تک گیا۔ MySQL CPU کا maximum 24.5% اور average 13.4% تھا؛ worker کا maximum 46% تھا اور zero failed jobs record ہوئے۔ Aggregation windows اور denominators کو نظر آغیز رکھیں۔ Zero failed jobs کا مطلب یہ نہیں کہ کوئی pending یا lost work نہیں تھا۔
پرانی CPU estimate تقریباً 59 ms/request تھی۔ 63 requests/s پر یہ 3.717 CPU-seconds/s ہے؛ آٹھ vCPU پر تقسیم کرنے پر تقریباً 46.5%۔ اس کا 47% سے قریب ہونا ان مفروضات کے تحت ایک consistency check ہے، causation یا linear scale کا ثبوت نہیں۔ Scale-in incident نے دکھایا کہ readiness، per-node load اور retirement کے لیے الگ الگ شواہ درکار ہیں۔ امتحان اوقات کی runbook ایک human control تھی، enforced prohibition نہیں۔
تاریخی planning model نے ہر node کے لیے 50 backend requests/s، baseline traffic کے طور پر 30 requests/s، 1.3 imbalance factor، 15 opening requests/student اور ہر موجود student کے لیے 0.025 requests/s کا فرض کیا تھا۔ 50 کو ایک hypothesis سمجھیں جو اُسی request mix اور agreed latency target کے لیے ہے، universally safe limit کا ثابت شدہ نہیں۔
N صحت مند nodes کے لیے student budget ہے N×50÷1.3−30 requests/s۔ 600 سیکنڈ کے join window میں ہر student کا حصہ 15÷600+0.025=0.05 requests/s ہے۔ 120 سیکنڈ پر یہ 0.15 ہے۔ چار nodes کے لیے، (4×50÷1.3−30)÷0.05≈2,477؛ تدریسی جدول اسے 2,400 پر round down کرتا ہے۔ یہ fluid average model ہے: bursts، uneven arrival، pauses اور correlations اب بھی اس سے تجاوز کر سکتے ہیں۔
1.3 divisor یہ planning factor ہے، 30% idle capacity یا automatic node-failure coverage کا دعویٰ نہیں۔ کسی node کی lost capacity کا الگ سے model کریں۔ مشاہدے شدہ few-node tests سے اوپر کی قطاریں extrapolations ہیں، certified student capacity نہیں۔ PDF uploads، worker queues، database contention اور provider limits اس backend model سے باہر ہیں۔ Database CPU کا کم ہونا 450 requests/s کی ceiling یا sixfold headroom ثابت نہیں کرتا۔
| صحت مند backend nodes | Model budget requests/s | 600 سیکنڈ کا join: rounded students | 120 سیکنڈ کا join: rounded students |
|---|---|---|---|
| 2 | ≈77 | 900 | 300 |
| 4 | ≈154 | 2,400 | 800 |
| 6 | ≈231 | 4,000 | 1,300 |
تاریخی design میں frontend/backend کے independent pools، ہر ایک کا minimum دو اور maximum ten؛ primary/standby MySQL؛ shared Valkey؛ الگ PostgreSQL/pgvector؛ object storage؛ اور OpenSearch میں backend logs شامل تھے۔ ایک fixed worker اب بھی queues، scheduling، WebSockets اور SMS host کر رہا تھا۔ یہ worker single point of failure باقی رہا؛ frontend log shipping اور worker standby منصوبہ بند تھے۔
Replicated database، stateless web nodes اور images کچھ مخصوص recovery paths بہتر بناتے ہیں۔ یہ ہر dependency کو redundant نہیں بناتے اور نہ regional failure، bad deployment، unauthorised access یا erroneous deletion سے بچاتے ہیں۔ Write fencing اور restore کا الگ سے test کریں۔ پرانے frozen data نئی writes کے بعد موجودہ rollback نہیں ہے؛ image rollback کے لیے بھی compatible schema، sessions اور queued payloads درکار ہیں۔
درج شدہ تاریخی ماہانہ web items کا مجموعی $272 ہے: backend $112 + frontend $56 + worker $56 + دو balancers $48۔ ڈیٹا اور logs کا مجموعی $709 ہے: MySQL $389 + Valkey $240 + PostgreSQL $60 + OpenSearch $20۔ Snapshots $5 اور Spaces base $5 شامل کرنے پر variable usage سے پہلے $991 ہو جاتا ہے۔ پرانا “تقریباً $990” rounded تھا، exact invoice نہیں۔
پچھلا $416 web tier کو describe کرتا تھا جس میں powered-off recovery Droplets شامل تھے؛ یہ پرانا full-stack cost نہیں تھا۔ $416 کا موازنہ $272 سے صرف اُس وقت کریں جب scope اور service assumptions بالکل یکساں ہیں، نہ کہ نئے مجموعی $991 سے۔ اس فہرست میں staffing، support، taxes، provider AI/SMS، overages اور temporary rollout/peak capacity شامل نہیں؛ یہ total cost of ownership یا موجودہ quote نہیں ہے۔
موجودہ provider plans اور account eligibility check کریں۔ حصہ 3 میں بیان شدہ MySQL Standard کی تبدیلیوں کے سبب تاریخی pair کو 2026 کے لیے بغیر check کیے خریداری recipe کے طور پر unsuitable کہنا مناسب ہے۔ زیادہ reliability budget فائدہ مند ہو سکتا ہے، مگر savings کا دعویٰ صرف comparable service اور مکمل operating model کی بنیاد پر کیا جا سکتا ہے۔
| تاریخی ماہانہ group | درج شدہ subtotal | اسکوپ |
|---|---|---|
| Web tier | $272 | 2 backend +2 frontend +worker +2 balancers |
| ڈیٹا اور logs | $709 | MySQL +Valkey +PostgreSQL +OpenSearch |
| Snapshots اور storage base | $10 | $5 +$5؛ usage اضافی |
| درج شدہ مجموعی base | $991 | usage، staffing، taxes اور دیگر services سے پہلے |
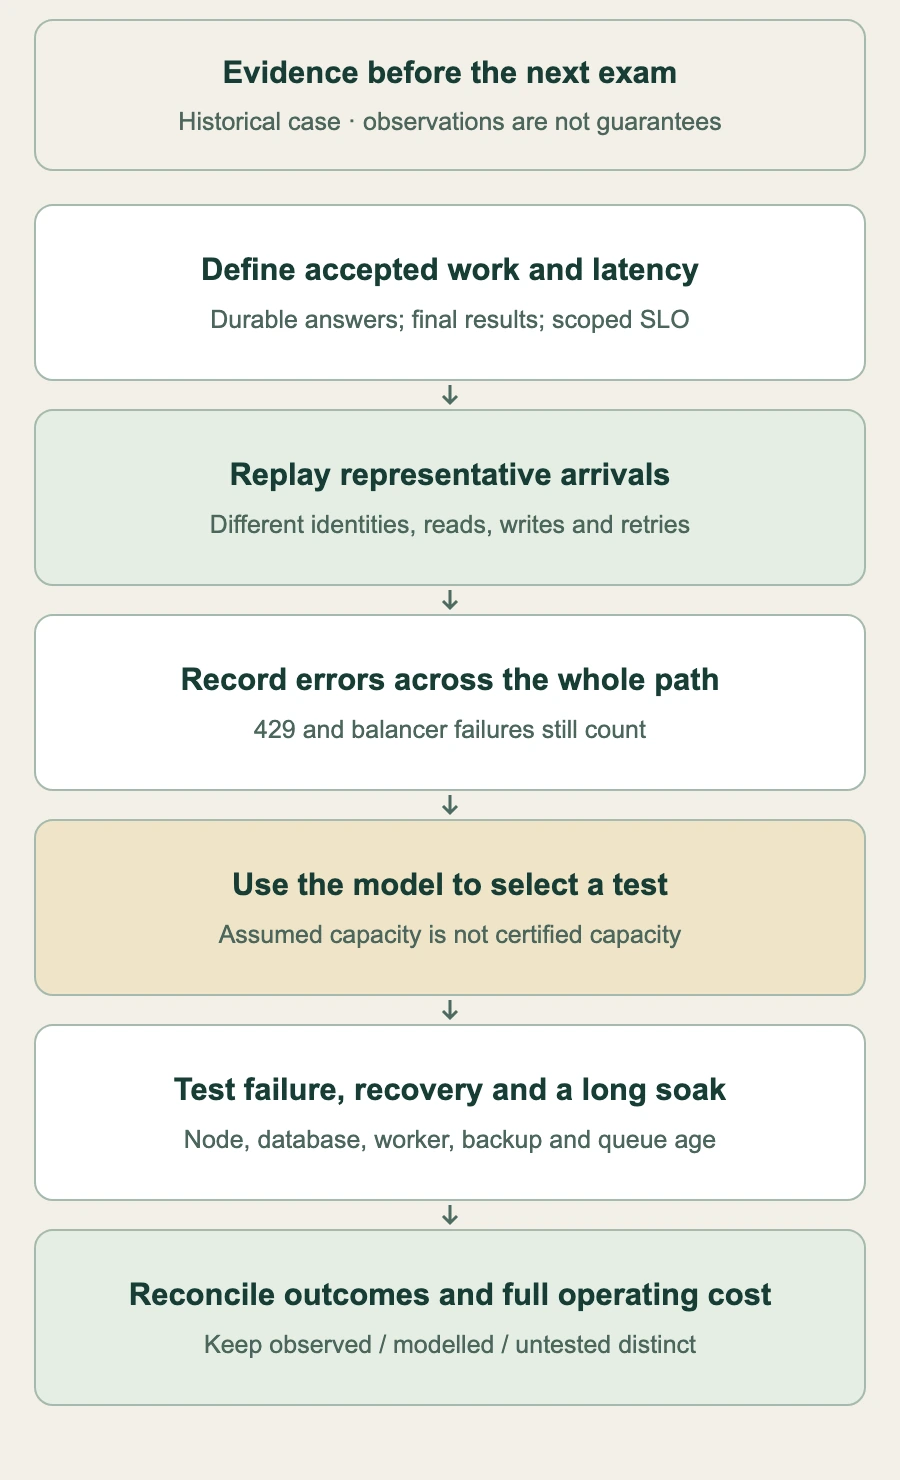
ریکارڈ میں formal multi-hour soak اور full mixed write-path load test منصوبہ بند تھے۔ دو گھنٹے کا امتحان observation controlled soak نہیں تھا۔ 24 گھنٹے کا no-local-write observation memory leaks، connection growth یا بڑھتے ہوئے queues کو خارج نہیں کرتا۔ ان خالی جگہوں کو خاموشی سے “pass” کہہ دیں۔
اگلے بڑے event سے پہلے کامیاب جوابات اور latency کی thresholds پر_mutہیق کریں؛ representative identities اور arrival shape استعمال کریں؛ duplicate submissions اور deadline behaviour test کریں؛ اتنی دیر برقرار رکھیں کہ memory، connections، storage اور oldest-job age کو مشاہدہ کر سکیں۔ Node failure، safe scale-in، database reconnect/failover، worker recovery اور backup restoration شامل کریں۔ Tool versions، scripts، resource settings، errors اور accepted-work reconciliation capture کریں۔ Disruptive tests الگ representative environment یا stop criteria کے ساتھ approved window میں چلائیں۔
اس سلسلے کا اختتام ایک قابلِ استعمال فیصلے کے loop پر ہوتا ہے: کاروباری نتیجہ ناپیں، constraint تلاش کریں، متعلقہ layer تبدیل کریں، پھر نتیجہ اور recovery دوبارہ test کریں۔ اس سب سے قیمتی artifact وہ evidence register ہے جو “مشاہدہ شدہ”, “modelled” یا “ابھی test نہیں ہوا” کہے سکے، انہیں آپس میں ملا دے بغیر۔
6 نومبر 2026 کو جائزہ لیا گیا۔ Anichur Rahaman، StoreConsole founder۔ تاریخی مشاہدے برقرار رکھے گئے؛ حساب check کیا گیا؛ extrapolations اور planned tests واضح طور پر الگ کر دیے گئے۔
مصنف کے بارے میں
Anichur Rahaman
مطالعہ جاری رکھیں