
 软件架构
考试之夜提供了证据,不是容量保证——NovaCommerce 第五篇
两场真实考试、一次缩容失误和一个规划模型。最后一篇把观察、外推、运维成本与尚欠测试分清楚。
Anichur Rahaman1 个月前6分钟

在增加服务器之前,如何识别故障点、定义可用性,并验证预定流量高峰:一份实用案例。
作者
Anichur Rahaman

第 1 部分,共 5 部分
从单服务器到考试日就绪考试在固定时间开始。学生同时进入,计时不会暂停,平台必须持续接收答案。购买更大的服务器并不能回答关键问题:节点故障、共享服务变慢,或部署中断正在处理的请求时,会发生什么?
这组五篇案例记录了一家课程与在线考试平台如何为预定流量高峰做准备。第一篇先介绍风险识别,再讨论基础设施选择。
案例说明:NovaCommerce 是用于匿名化的化名。下文配置和测量来自 2026 年 9—10 月的项目记录,只代表该平台及其工作负载,并非 Store Console 的性能基准。通用技术说明于 2026 年 11 月 3 日复核。
全天平均流量无法反映考试所需容量。真正困难的是开考第一分钟:学生集中加载题目、检查会话并进入考试。我们把这一场景转化为四项要求:
这些是设计要求,不代表所有故障场景都已完成验证。
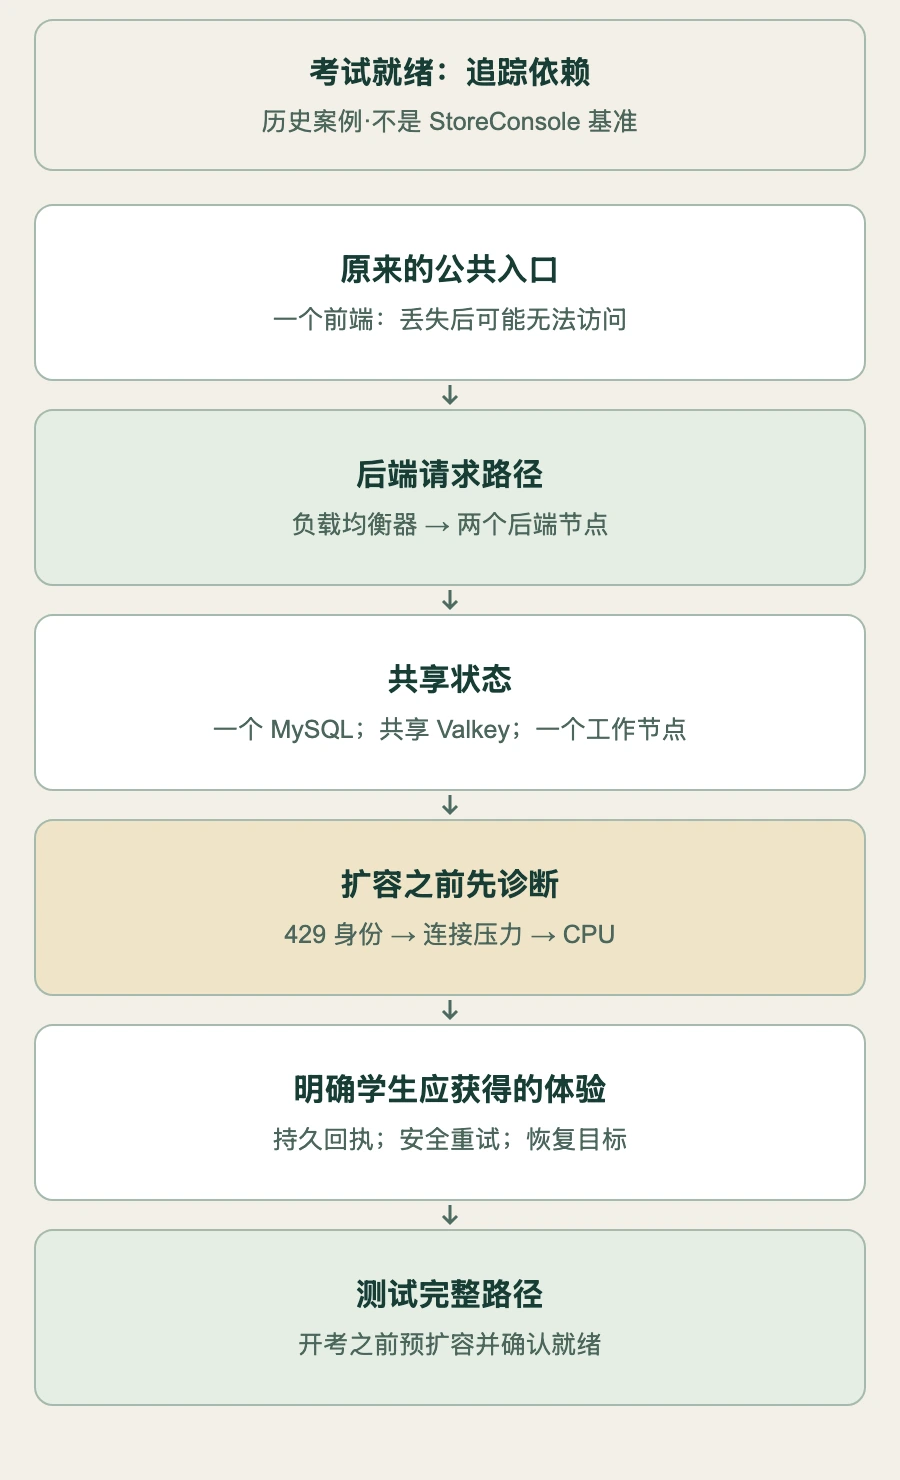
前端在一台 8 vCPU、16 GB 的 Droplet 上运行一个 Next.js 容器,前面没有负载均衡器。失去这个节点,公开网站就可能不可用。后端由两台各 4 vCPU、8 GB 的节点通过 nginx 和 PHP-FPM 运行 Laravel。后台任务、调度器及 WebSocket 位于单独的 worker 上。
后端负载均衡器绑定固定的 Droplet ID。新增服务器后需要注册;这个配置不会自动发现新容量。会话、缓存和队列已经放在托管 Valkey 中,因此替换 Web 节点比较容易。
MySQL 只有一个 8 vCPU、32 GB 的托管节点,没有配置备用节点。托管服务能够替换故障节点,但这不同于已有复制就绪的备用节点可供提升。唯一的 worker 也是异步任务的故障点。
另外两台 Droplet 关机作为恢复资源。它们可以属于恢复流程,但当时不处理流量,也不能提供自动故障切换。
准确理解 Node.js:单个 JavaScript 事件循环可能限制 CPU 密集型渲染,但 Node.js 也使用工作线程池和原生操作。仅凭一个容器,不能证明八个核心中有七个闲置。应通过性能分析与负载测试决定进程数量。
与其笼统称整个平台“高可用”,不如明确每种故障下用户应获得怎样的体验:
可用性与数据持久性需要分别举证。无状态 Web 节点有利于替换,但本身不能保证答案不丢失。这还取决于数据库提交、复制与持久化设置、避免重复的重试、备份及恢复测试。单区域架构也不能证明能够从整个区域中断中恢复。
9 月 25 日,共用学校或运营商网络的学生收到“请求过多”。因为认证身份没有正确解析,API 限流器按 IP 计算,许多人因此共享同一额度。
修正后,已认证请求按学生或教师账户限流,访客保留 IP 回退。增加服务器不会改变这条规则。身份限流仍需要独立的滥用防护,并不意味着应该取消限流。
10 月 6 日的测试记录了 2,854 个应用错误,均涉及 Valkey 连接超时。案例记录描述了不断建立新 TLS 连接的开销,以及把主节点和备用节点从每台 4 GB 调整至 8 GB 的操作。
调整后,从每秒 25 次逐步增加到 500 次请求的测试得到零应用错误,但仍有 143 个负载均衡器错误,当时后端 CPU 已饱和。这说明该次测试中的应用超时故障消失,不代表最高负载下端到端成功。仍有请求失败。
超时本身不能证明内存不足。面对其他系统,应该先调查连接频繁建立与销毁、连接限制、网络情况及服务指标,再判断是否需要更大套餐。
在测试的 API 请求组合下,一个 4 vCPU 后端节点在 CPU 满载时达到约每秒 65—70 次请求。这是观察到的饱和点,不是安全运行目标,也不是可直接用于其他系统的基准。减少 CPU 工作量与增加容量都应评估。
一次测试中,CPU 达到 99% 后约七分钟,首个额外自动扩容节点才加入。这是该配置的具体结果。对于已知时间的考试,实际做法是提前扩容并在开考前确认就绪。
原有预算中,Web 层约为每月 416 美元,其中两台关机 Droplet 占每月 112 美元。这些是 2026 年 9—10 月的历史数据,不包括数据库、Valkey 和存储,不能直接与后来的整套系统账单比较。
DigitalOcean 对保留 CPU 资源的 Droplet 在关机时仍收费。冷备容量是否值得,要看它实际提供的恢复时间:覆盖哪类故障、多久能投入使用、流程上次何时测试?
供应商套餐也会变化。DigitalOcean 当前文档宣布,PostgreSQL 与 MySQL Standard Edition 的限制从 2026 年 10 月 15 日起适用于从未创建 PostgreSQL 或 MySQL 集群的账户,11 月 30 日起适用于所有账户。复制历史配置前,请核对当前可用套餐和价格。
无论是考试、产品发布还是结账高峰,都应先写出关键请求路径,列出共享依赖,并说明它们不可用时会发生什么。用预期工作负载测试整个路径,测量成功响应、尾延迟和错误。根据证据修改相应层,再次测试。
下一篇:第二篇介绍前后端节点池、提前扩容和部署顺序。如果您正在为关键业务评估 Store Console,请从部署要求开始,并验证自己的流量模式。
案例数字来自历史项目记录。以下来源支持通用说明,并不独立验证项目的私有测量。
审核日期:2026年11月6日。 必须明确“已接受答案”的含义:持久保存回执、操作标识和幂等重试路径。队列任务不能是答案的唯一副本。备用节点、备份和通过验证的恢复测试分别解决不同问题,任何一项都不能单独证明零数据丢失。下文保留现有案例记录的历史事件计数;本次编辑审核未独立重新测量。
作者简介
Anichur Rahaman
继续阅读

