

 软件架构
考试之夜提供了证据,不是容量保证——NovaCommerce 第五篇
两场真实考试、一次缩容失误和一个规划模型。最后一篇把观察、外推、运维成本与尚欠测试分清楚。
Anichur Rahaman1 个月前6分钟
绿色服务器图可能掩盖订单延迟。把业务结果与指标、受保护日志和追踪连接起来,让每个告警都有行动与负责人。
作者
Anichur Rahaman
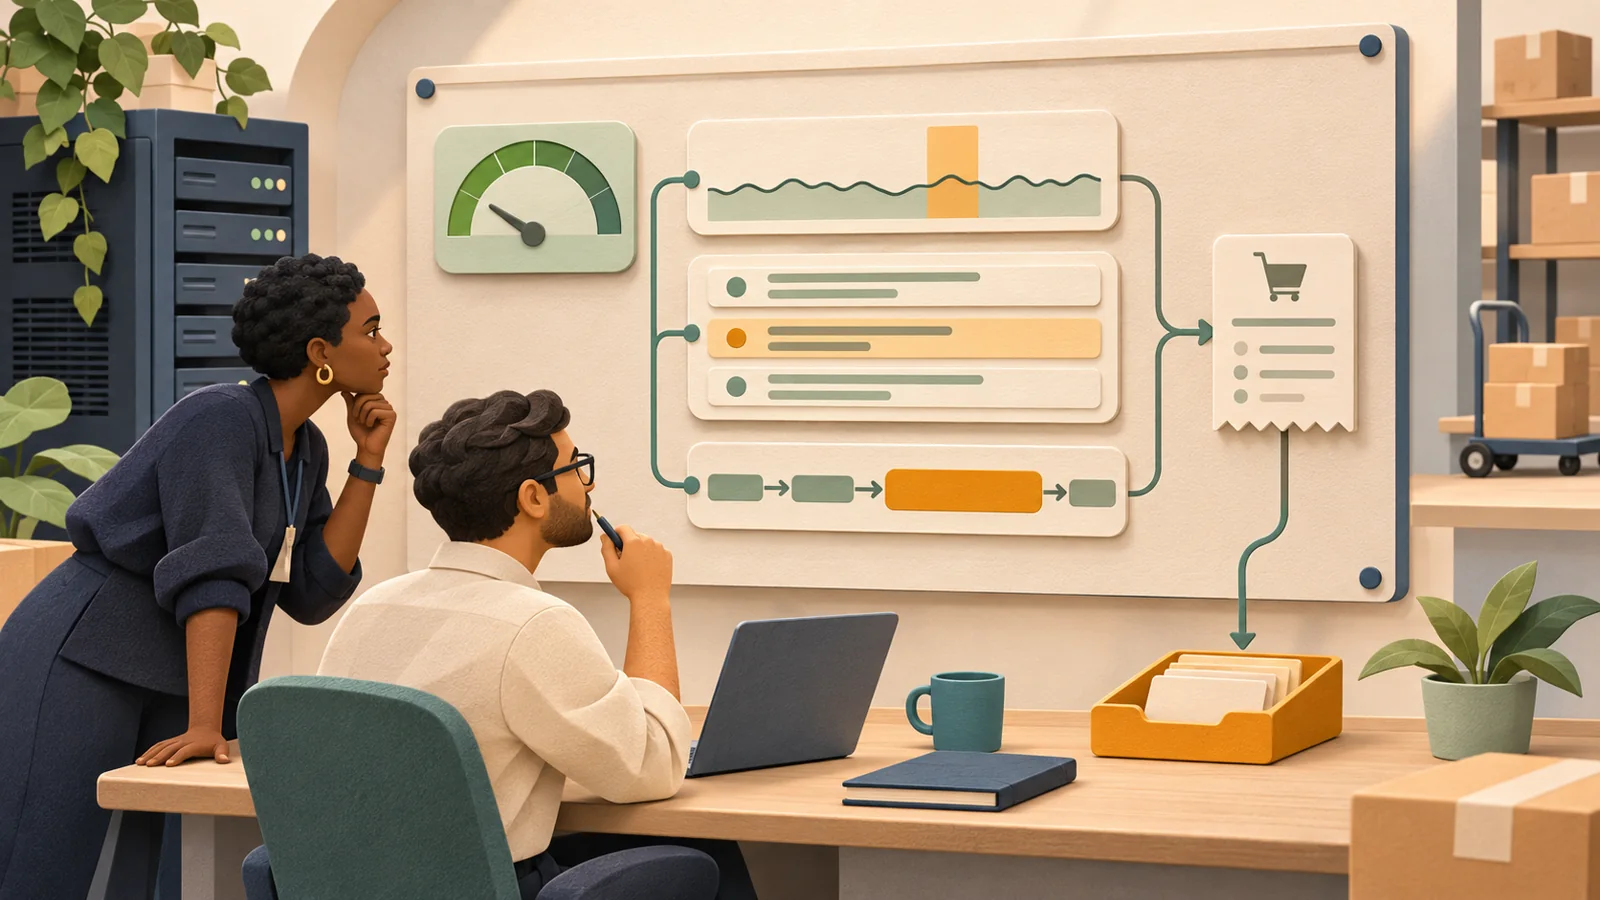
10:01,客服说:“结账卡住了。”CPU只有40%,首页也能打开。在这个教学场景里,关键不是服务器是否绿色,而是客户是否得到正确结果,未完成工作在哪里等待。
“高并发系统工程”第4篇建立一条小型证据链:业务结果、聚合信号、具体操作、受控响应。不声称真实事故、个人基准或保证诊断时长。
HTTP 200、队列任务结束或付款页打开,不证明订单已付款。定义合格操作、正确结果、时间边界和排除项。拟议结账SLI可要求2秒内返回准确结果或耐久的待处理回执。付款和履约完成另需新鲜度目标,否则“待处理”可以永远绿色。
以下假设30天目标99%好事件,计划范围3,000,000次合格尝试。坏事件是错误、失败或过慢结果的并集:同一次既失败又慢,也只记一次。这是教学假设,不是StoreConsole实测SLO。
| 教学计算 | 结果 |
|---|---|
| 计划合格尝试/30天 | 3,000,000 |
| 允许坏比例:1−99% | 1% |
| 计划坏事件预算 | 30,000 |
| 高峰:440×600 | 264,000 |
| 坏事件:264,000×2% | 5,280 |
| 计划预算消耗:5,280÷30,000 | 17.6% |
每秒440次合格尝试持续10分钟,共264,000次。若2%不好,5,280次消耗计划30,000预算的17.6%。坏率是允许1%的2倍,但换算耗尽时间需要流量假设。Google的SLO告警指导支持多窗口、影响导向的告警。固定2%不是通用呼叫阈值,流量、风险和紧迫性都重要。
OpenTelemetry信号连接聚合指标、事件日志和span追踪。把四个黄金信号——延迟、流量、错误、饱和度——与实际业务完成一起看。除了CPU,还看池/锁等待、已就绪合格队列年龄、最老未解决责任、存储和内存。明确安排在未来的任务并非已经超时。
| 证据 | 问题 | 边界 |
|---|---|---|
| 结果计数 | 正确结果是否按时交付? | 资格定义;每次尝试计一次 |
| 结构化日志 | 这次操作/尝试发生什么? | 范围权限;敏感字段最少化 |
| Trace | 已埋点时间花在哪里? | 覆盖、重叠及采样限制 |
| 审计/核对记录 | 实际存在什么耐久业务效果? | 独立权威、保留与恢复控制 |
Request ID标识一次请求,trace ID连接已埋点工作,业务operation ID贯穿相关重试,每次attempt仍可区分。后台工作以后可能用链接trace继续。W 3 C Trace Context提供传播规范,不是身份认证。校验并限制不可信入站ID,适当生成安全内部关联,不要向伙伴无差别转发敏感上下文。
Span是已埋点时间的证据,不自动等于根因。嵌套和并行span会重叠,逐个相加会重复计算。统一时间戳与单位,可靠测量时长,标记发布和配置变更。相邻发布是假设,不证明回退安全。
按成功/失败人群观察延迟分布、计数和速率。均值可用于容量计划,却会隐藏长尾。Prometheus直方图指导解释聚合:各节点p95求平均不是全局p95。应在已知窗口使用兼容分布/桶或其他正确方法。
结构化日志应包括时间、服务/环境/版本、规范化路由、结果/原因、时长/单位及调查必要的范围内关联。没有query的原始路径也可能含个人资料。内部ID仍可能敏感,应最小化并限权。OWASP日志指导涵盖秘密排除、访问、完整性、保留及日志注入风险。不要复制卡片资料、密码、令牌或客户文档。
必要的request/order/user ID进入受保护可检索上下文,不作为无界指标维度。Prometheus标签指导警示高基数序列;Loki标签指导也区分stream标签与细节字段。每个标签带客户ID,即使中等流量也可能耗尽小后端。
保留期按目的和适用要求决定,包括删除与法律保全。按实测量设计接入、索引、查询和恢复,没有通用2 GB日志节点或30天标准。监控collector丢弃、exporter失败、缓冲、磁盘及告警投递。限制退避/重试和缓冲,防止遥测失败卡住结账。必须耐久的审计证据应有独立政策,不能静默采样或丢弃。
OpenTelemetry采样指导区分早期head和稍后tail决策。Head不能保证保留后来每个错误。Tail可偏向错误/慢trace,但需要容量、等待窗口及一致路由,无法恢复上游已丢span。记录丢失/覆盖率,为SLI保留合适的未采样结果计数。核验实际SDK/埋点版本,不要笼统声称所有集成都稳定。
第一屏显示关键旅程好/坏数量与延迟,再显示等待工作和资源上限,可按范围下钻。要适合值班实际设备。外部/合成检查及供应商证据补充内部指标;没有遥测不是零错误。
呼叫需要负责人、影响范围、证据、runbook和升级路径。结合适当长短窗口、有意义时的最小流量及严重性。安全、数据损坏或即将耗尽容量,可能在用户错误率升高前就需行动。低流量资金不符可能比嘈杂CPU更紧急。
核实受影响服务和业务状态,保存证据,选择可逆缓解。不要自动重启数据库或回退最近15分钟所有发布。检查schema/API兼容、进行中付款及已接受工作。外部结果未知,先查原参考号再重复资金动作。缓解后核对实际结果和恢复积压;错误图下降不是结案。

在隔离或明确受控压测中使用代表性请求组合、冷缓存及依赖行为。记录发起/完成工作、生成器限制、测试范围与停止条件。CPU守卫不能保证永不造成事故。供应商与应用图表可能因窗口、分母、单位或范围不同而不同,应先核对定义再判断谁错。
注入慢依赖、入队失败、回调延迟和exporter中断。验证告警到负责人,关联记录能解释未完成工作且不泄露另一实体数据。随变更保留结果、决策和限制。10:01时,证据应缩小等待范围、保护恢复,而不是用平静CPU承诺客户一切正常。
审核日期:2026年11月6日。Anichur Rahaman,StoreConsole创建者。SLO、流量与预算是教学示例,不代表实测服务结果。
系列
高并发系统工程作者简介
Anichur Rahaman
继续阅读

