Le soir de l’examen était une preuve, pas une garantie de capacité — NovaCommerce 5
Deux examens réels, une erreur de réduction de capacité et un modèle de planification utile. La révision finale du cas distingue les observations, les extrapolations, les coûts d’exploitation et les tests encore à réaliser.
Le 7 octobre 2026, deux examens se sont déroulés à la suite. Le dossier du cas indique 661 démarrages et 638 soumissions pour le premier, ainsi que 439 démarrages et 425 soumissions pour le second. Le minimum du pool a ensuite été réduit pendant un examen : un nœud de service a disparu sans le drainage attendu et environ 360 requêtes ont échoué en deux minutes. Le fonctionnement du service et cette défaillance doivent tous deux être consignés dans les résultats.
NovaCommerce est une plateforme anonymisée de cours et d’examens. Cette partie finale conserve les observations existantes de septembre à octobre, recalcule les calculs publiés et précise ce qui reste non démontré. Il ne s’agit ni d’un nouveau test de charge répété ni d’un test de performance StoreConsole.
Interprétez les tests selon ce qu’ils ont réellement couvert
L’enquête a identifié un limiteur indexé par IP le 25 septembre, des échecs de connexion à Valkey lors d’une exécution en octobre 6 et une saturation du CPU backend pour la combinaison de requêtes testée. Des causes différentes ont nécessité des changements différents. « Plus de serveurs » conviendrait à certaines pressions sur la capacité, mais ne remplace ni une identification correcte ni un service partagé opérationnel.
Les essais comprennent un essai du frontend d’environ 356 requêtes/s, avec un p95 de 0.05 s et aucune erreur signalée ; un essai d’autoscaling fondé sur GET le 5 octobre, atteignant environ 750 requêtes/s, sans erreur serveur ni délai d’attente signalés, mais avec environ 4 % de réponses HTTP 429 ; et une montée en charge de 25 à 500, sans erreur applicative mais avec 143 erreurs de l’équilibreur de charge. Ces essais ont des mélanges et des périmètres différents. Ne combinez pas leurs meilleurs chiffres en une seule déclaration de débit validé.
Le déploiement progressif protégé a ensuite comporté 219 sondes, toutes les deux secondes, sans erreur. Il s’agit d’un échantillon utile, pas d’une preuve que chaque requête, écriture ou connexion longue a survécu. Un test complet du parcours métier doit valider la prise en compte des réponses authentifiées, la conservation durable des justificatifs, les reprises sûres et les résultats finaux, et pas seulement les codes HTTP ou le temps de chargement d’une page d’accueil en cache.
Un vrai soir a révélé une autre défaillance
Le ratio 638/661 s’arrondit à 96.5 % ; celui de 425/439, à 96.8 %. Il s’agit de proportions de soumission, pas de pourcentages de disponibilité. L’absence de soumission peut avoir plusieurs causes ; les comptages n’attribuent pas chaque soumission manquante à une défaillance technique ni n’établissent l’absence de perte de données.
L’étude de cas fait état d’un pic backend d’environ 69 requêtes/s d’après les journaux minute par minute, contre 63 selon l’agrégation de deux minutes du fournisseur. Le CPU du pool a atteint un pic de 47 % selon la moyenne signalée, tandis qu’un nœud a atteint 86 % pendant une minute. Le CPU maximal de MySQL était de 24.5 %, avec une moyenne de 13.4 % ; le worker a atteint 46 %, sans tâche échouée enregistrée. Gardez visibles les fenêtres d’agrégation et les dénominateurs. Zéro tâche échouée ne signifie pas qu’aucun travail n’est en attente ou n’a été perdu.
L’ancienne estimation du CPU était d’environ 59 ms/requête. À 63 requêtes/s, cela représente 3.717 secondes CPU/s ; divisé par huit vCPU, environ 46.5 %. Le fait que cette valeur soit proche de 47 % constitue un contrôle de cohérence dans ces hypothèses, pas une preuve de causalité ni de mise à l’échelle linéaire. L’incident de réduction de capacité a montré pourquoi la préparation, la charge par nœud et le retrait des nœuds nécessitent des preuves distinctes. Le runbook pendant les heures d’examen était un contrôle humain, pas une interdiction imposée.
Utilisez un modèle pour choisir le prochain test
Le modèle de planification historique supposait 50 requêtes/s backend par nœud, un trafic de base de 30 requêtes/s, un facteur de déséquilibre de 1.3, 15 requêtes d’ouverture par étudiant et 0.025 requêtes/s par étudiant présent. Considérez 50 comme une hypothèse applicable au même mélange de requêtes et à un objectif de latence convenu, et non comme une limite universellement sûre et prouvée.
Pour N nœuds sains, le budget d’étudiants est N×50÷1.3−30 requêtes/s. Avec une fenêtre de connexion de 600 secondes, chaque étudiant contribue 15÷600+0.025=0.05 requêtes/s. Avec 120 secondes, il est de 0.15. Pour quatre nœuds, (4×50÷1.3−30)÷0.05≈2,477 ; le tableau pédagogique arrondit à la baisse à 2,400. Il s’agit d’un modèle de moyenne fluide : les rafales, les arrivées irrégulières, les pauses et les corrélations peuvent toujours faire dépasser cette valeur.
Le 1.3 diviseur est ce facteur de planification, pas une affirmation de 30 % de capacité inactive ou de couverture automatique en cas de défaillance d’un nœud. Modélisez séparément la perte d’un nœud. Les lignes supérieures aux essais observés sur quelques nœuds sont des extrapolations, et non une capacité d’étudiants certifiée. Les téléversements de PDF, les files du worker, la contention de la base de données et les limites du fournisseur ne font pas partie de ce modèle backend. Un faible CPU de la base de données n’établit ni un plafond de 450 requêtes/s ni une réserve de capacité sextuple.
Nœuds backend sains
Budget de requêtes/s du modèle
Fenêtre de connexion de 600 seconde : nombre d’étudiants arrondi
Fenêtre de connexion de 120 seconde : nombre d’étudiants arrondi
2
≈77
900
300
4
≈154
2,400
800
6
≈231
4,000
1,300
Décrivez l’architecture avec ses risques non résolus
L’architecture historique comportait des pools frontend et backend indépendants, avec un minimum de deux et un maximum de dix pour chacun ; un MySQL principal/de secours ; un Valkey partagé ; un PostgreSQL/pgvector distinct ; un stockage objet ; et des journaux backend dans OpenSearch. Un worker unique hébergeait encore les files, la planification, les WebSockets et les SMS. Ce worker demeurait un point de défaillance unique ; l’envoi des journaux frontend et un worker de secours étaient prévus.
Une base de données répliquée, des nœuds web sans état et des images améliorent certains parcours de reprise. Elles ne rendent pas chaque dépendance redondante et ne protègent pas contre une panne régionale, un mauvais déploiement, un accès non autorisé ou une suppression erronée. Testez séparément le fencing des écritures et la restauration. Des données anciennes figées ne constituent pas un retour en arrière à l’état actuel après de nouvelles écritures ; le retour arrière d’une image nécessite également un schéma, des sessions et des charges utiles en file compatibles.
Ajoutez la facture avant de comparer
Les éléments web mensuels historiques indiqués totalisent 272 $US : backend 112 $US + frontend 56 $US + worker 56 $US + deux équilibreurs de charge 48 $US. Les données et journaux totalisent 709 $US : MySQL 389 $US + Valkey 240 $US + PostgreSQL 60 $US + OpenSearch 20 $US. En ajoutant les snapshots 5 $US et la base Spaces 5 $US, on obtient 991 $US avant l’utilisation variable. L’ancien montant « environ 990 $US » était arrondi, et ne correspondait pas à une facture exacte.
Le montant antérieur 416 $US décrivait le niveau web, y compris les Droplets de récupération hors tension ; il ne s’agissait pas de l’ancien coût de la stack complète. Comparez 416 $US à 272 $US uniquement après avoir confirmé un périmètre et des hypothèses de service identiques, et non au nouveau montant combiné 991 $US. Cette liste exclut le personnel, le support, les taxes, les services IA/SMS du fournisseur, les dépassements et la capacité temporaire de déploiement ou de pointe ; elle ne représente ni le coût total de possession ni un devis actuel.
Vérifiez les offres actuelles du fournisseur et l’éligibilité de votre compte. Les changements du MySQL Standard décrits dans la partie 3 rendent le couple historique inutilisable comme recette d’achat non vérifiée pour 2026. Un budget de fiabilité plus élevé peut être justifié, mais seule une prestation comparable et un modèle opérationnel complet permettent d’affirmer des économies.
Groupe mensuel historique
Sous-total indiqué
Périmètre
Niveau web
$272
2 backend +2 frontend + worker +2 équilibreurs de charge
Données et journaux
$709
MySQL + Valkey + PostgreSQL + OpenSearch
Snapshots et base de stockage
$10
5 $US +5 $US ; utilisation en supplément
Base combinée indiquée
$991
Avant les frais d’utilisation, de personnel, de taxes et d’autres services
Le prochain jalon d’acceptation reste un travail concret
Un soak test formel de plusieurs heures et un test de charge complet sur les chemins d’écriture mixtes étaient toujours prévus dans le dossier. L’observation de deux heures pendant l’examen ne constituait pas un soak test contrôlé. Une observation de 24 heure sans écriture locale n’exclut pas les fuites de mémoire, la croissance des connexions ou l’allongement des files. Ne qualifiez pas silencieusement ces lacunes de « réussites ».
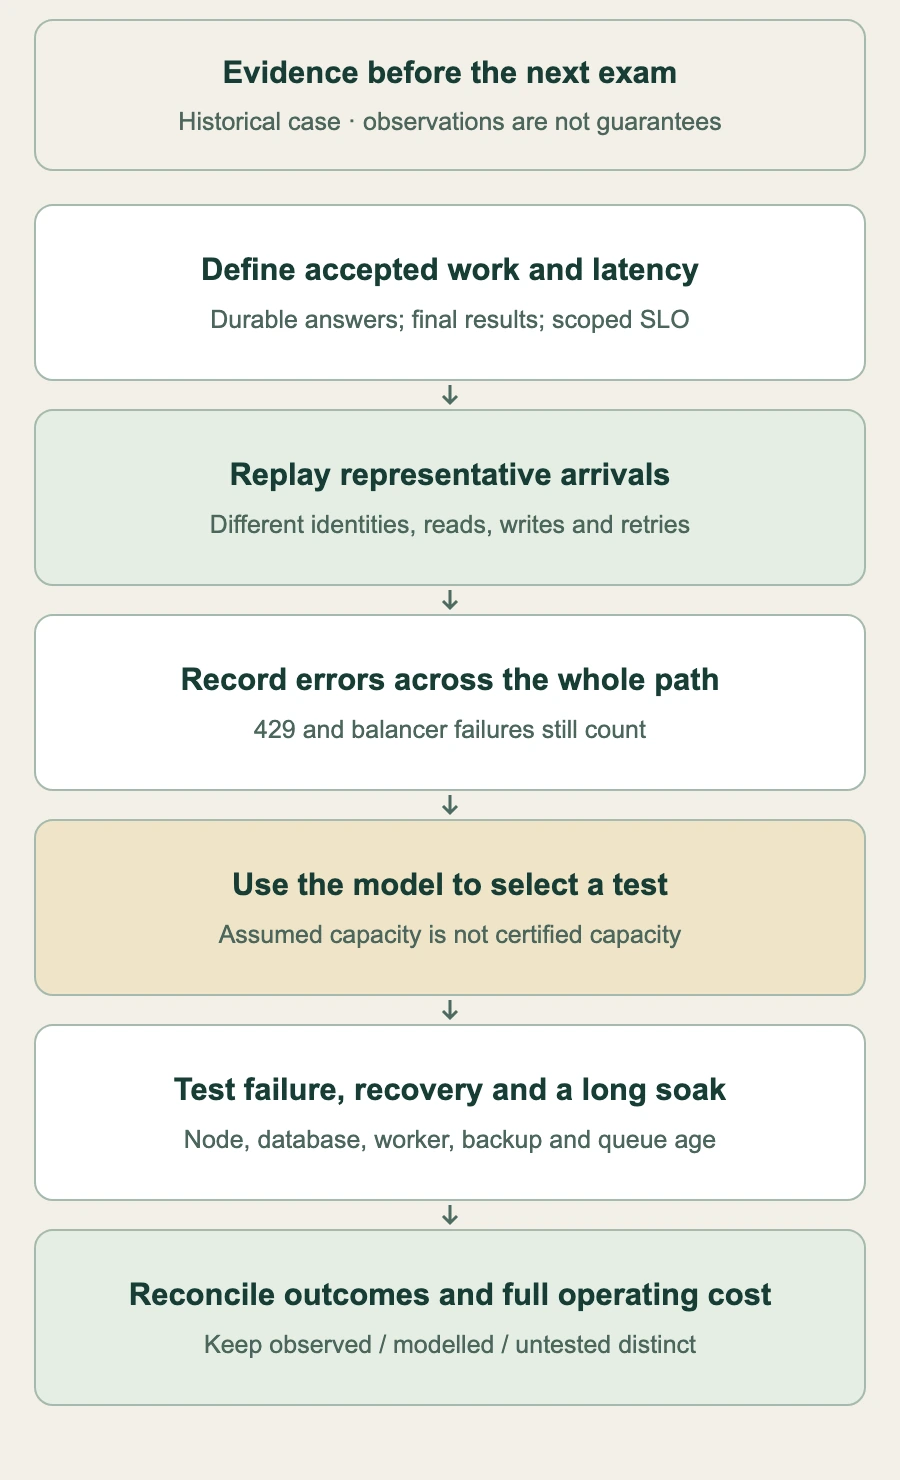
Avant un événement plus important, convenez des seuils de réussite des réponses et de latence ; utilisez des identités représentatives et un profil d’arrivée réaliste ; testez les soumissions en double et le comportement à l’échéance ; maintenez le test assez longtemps pour observer la mémoire, les connexions, le stockage et l’âge de la tâche la plus ancienne. Incluez la défaillance d’un nœud, la réduction de capacité sûre, la reconnexion ou le basculement de la base de données, la reprise du worker et la restauration des sauvegardes. Consignez les versions des outils, les scripts, les paramètres de ressources, les erreurs et le rapprochement des travaux acceptés. Exécutez les tests de perturbation dans un environnement représentatif isolé ou dans une fenêtre approuvée avec des critères d’arrêt.
La série se termine par une boucle de décision utilisable : mesurer le résultat métier, identifier la contrainte, modifier la couche concernée, puis retester le résultat et la reprise. Son artefact le plus précieux est un registre de preuves permettant de distinguer « observé », « modélisé » et « pas encore testé » sans les confondre.
Un plan pour obtenir les prochaines preuves, pas l’affirmation que ces tests ont déjà réussi. Les lignes de capacité sont des résultats de modèle ; le tableau des coûts représente les dépenses de base historiques.
Révisé le 6 novembre 2026. Anichur Rahaman, fondateur de StoreConsole. Les observations historiques sont conservées ; les calculs ont été vérifiés ; les extrapolations et les tests prévus sont explicitement distingués.