Prontos Antes da Prova: Escala e Substituição de Nós Web — NovaCommerce 2
Dois pools de aplicação ajudaram uma plataforma de provas cronometradas a crescer. O trabalho mais difícil foi comprovar a prontidão, drenar os nós antigos e manter uma única versão do serviço.
Uma hora após a alteração do DNS do frontend, o servidor antigo ainda recebia cerca de 36% do tráfego registrado. A equipe havia reduzido o TTL para 300 segundos e verificado a nova rota por meio de uma substituição no arquivo hosts. Ainda assim, a migração tinha duas entradas ativas. Manter a entrada antiga funcionando foi mais importante do que declarar a alteração do DNS concluída.
A NovaCommerce é uma plataforma de cursos e provas com os dados anonimizados. Esta segunda parte preserva as observações do caso de setembro a outubro de 2026; não são benchmarks do StoreConsole nem testes reexecutados de forma independente. A Parte 1 identificou a identidade usada no limite de taxa, a pressão nas conexões do Valkey e, depois, a CPU do backend como restrições diferentes. Esta parte acompanha a camada de aplicação.
Separe as camadas que exigem decisões diferentes
O design implementado usava um balanceador de carga e um pool de autoescalabilidade para o frontend, e outro par para o backend. Já existiam nomes DNS separados. As verificações de saúde independentes, os tamanhos dos nós e as políticas de substituição tornaram essa uma escolha razoável para esta implantação; dois balanceadores não são um requisito universal para todas as aplicações.
A descoberta do backend por tags substituiu uma lista fixa de IDs de Droplet. Novos nós com tags podiam entrar no pool previsto e ser incluídos nas regras do firewall. Uma tag é configuração, não prova de prontidão da aplicação nem de autorização. O orçamento histórico combinado dos balanceadores de carga era de US$ 48/mês, não uma cotação atual.
Conte a capacidade saudável, não as máquinas solicitadas
Os dois pools foram configurados para 2–10 nós. Os nós de frontend usavam nginx e dois contêineres Next.js em 2 vCPU/4 GB; os nós de backend usavam nginx/PHP-FPM em 4 vCPU/8 GB. Foram escolhas de implantação medidas. Um único event loop do Node.js não prova que todas as outras CPUs estejam ociosas: o pool de workers e o trabalho nativo também importam.
O teste histórico do frontend registrou cerca de 356 requisições/s, p95 de 0.05 s, zero erros relatados e 55–60% de CPU em dois nós. Isso apoiou um teste mais barato com CPU compartilhada; não estabelece a capacidade de todas as rotas, o comportamento sob interferência de processos vizinhos ou a capacidade do caminho de escrita. Os antigos valores mensais de US$ 28/US$ 56 por nó são dados históricos de planejamento.
Configuração histórica
Frontend
Backend
Faixa do pool
2–10 nós
2–10 nós
Por nó
2 vCPU / 4 GB; 2 contêineres Next.js
4 vCPU / 8 GB; PHP-FPM
Meta de CPU
70%
70%, depois 55%
Limite de saúde
Resposta do Next.js verificada
Somente nginx; prontidão da aplicação separada
Outro estado
O cache público exige coordenação
Um worker fixo fora dos pools
Pré-escale antes do horário previsto e diagnostique a mistura completa de respostas
A execução k6 de 5 de outubro, das 21:17–21:33, usou um replay com predominância de GET: 300–450 requisições/s e, depois, aproximadamente 750 por seis minutos. Frontend e backend cresceram de dois para três nós. Os erros e tempos limite relatados pelo servidor foram zero, mas cerca de 4% das respostas foram HTTP 429 de um IP de teste compartilhado. Uma solicitação rejeitada de um aluno continua sendo uma solicitação malsucedida; não foi uma execução bem-sucedida do fluxo de negócio e a gravação durável das respostas também não foi testada.
O p95 geral foi de 132–153 ms, enquanto o p95 da API foi de 320–705 ms. O caso registrou 5–8 minutos de atraso nas métricas e cerca de sete minutos entre 99% de CPU do backend e a chegada do primeiro nó adicional em outro teste. Essas são observações desta configuração, não uma garantia de tempo válida para todo o provedor. A equipe pré-escalou cerca de 45 minutos antes das provas e verificou a capacidade saudável. Kubernetes foi considerado, mas não implementado; ele também não garantiria capacidade de aplicação instantaneamente pronta.
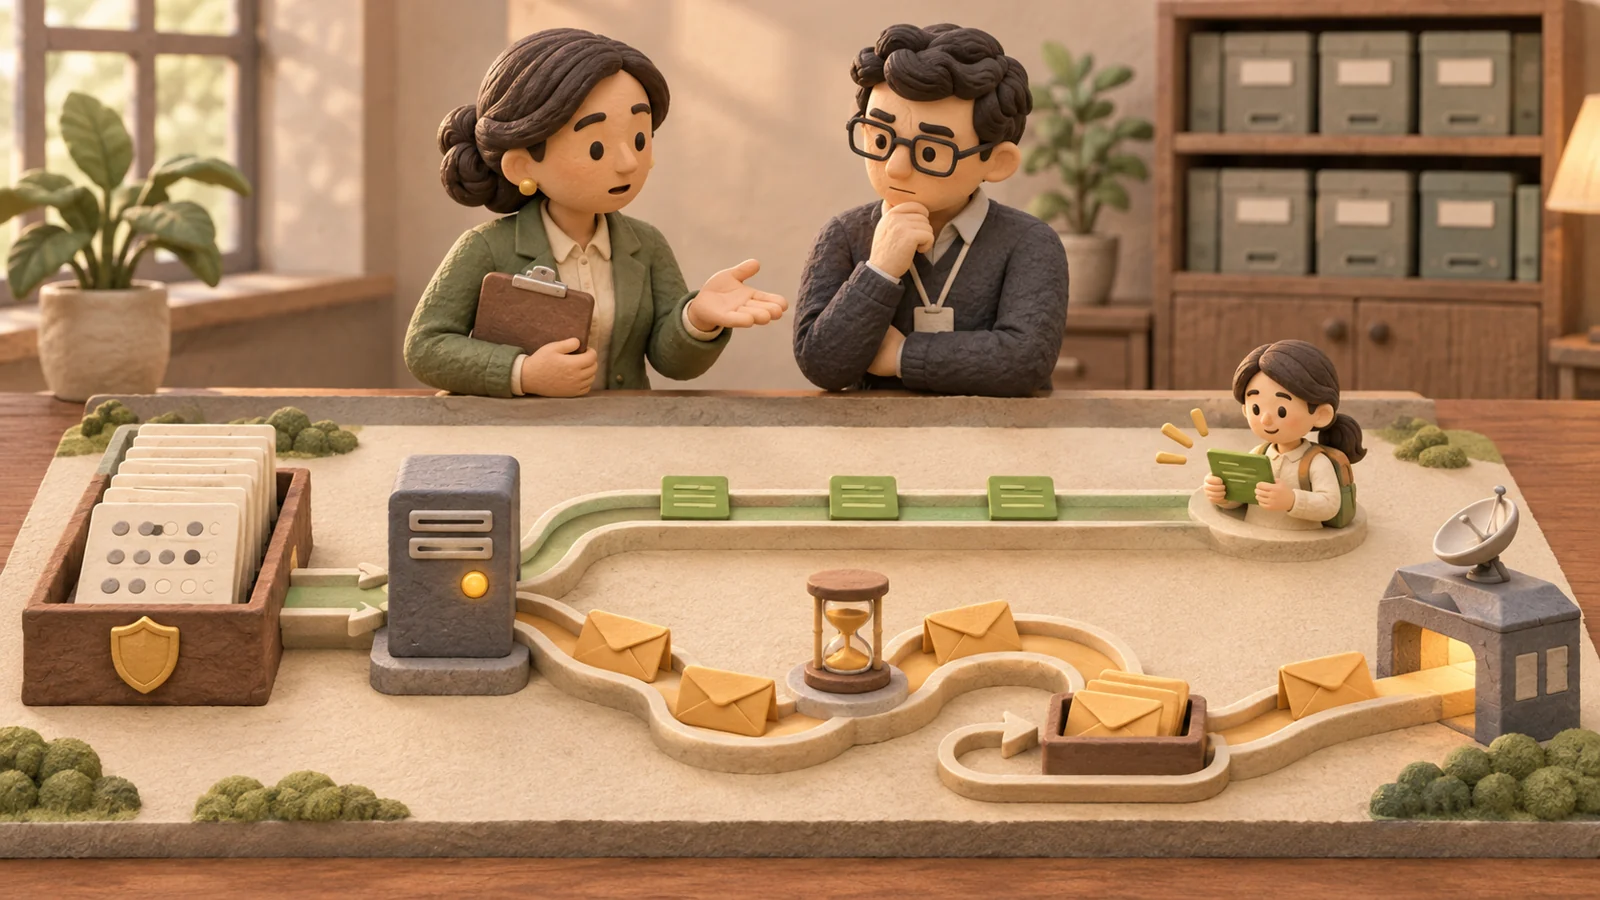
Uma visão didática do procedimento do caso. Prontidão e drenagem são etapas de validação; os tempos de espera históricos não são garantias universais.
Substitua um nó somente depois que seu sucessor puder executar o trabalho
A primeira implantação do template causou uma breve rajada de 503. Um procedimento posterior esperou pelas substituições, admitiu-as no balanceador e então drenou os nós antigos antes da exclusão. As esperas registradas de 30–40 segundos pertencem àquelas configurações de verificação de saúde; uma etapa segura de verificação confirma a inclusão efetiva no balanceador e o trabalho em andamento, em vez de se limitar ao tempo decorrido. Requisições longas, WebSockets e reduções de escala iniciadas pelo provedor exigem tratamento separado.
O endpoint /lb-health do backend verificava somente o nginx. Isso é útil para liveness e como chave de drenagem, mas não pode provar que uma rota dependente de PHP ou do banco de dados funciona. Combine-o com uma verificação de prontidão da aplicação com limite de tempo e sondas do caminho real, sem transformar cada verificação de saúde em uma consulta cara. A implantação posterior registrou 219 sondas a cada dois segundos, com zero erros; essa amostragem não comprova nenhuma interrupção para todos os usuários.
Mantenha imagens imutáveis e testadas, além de alterações compatíveis de banco de dados e filas. Para múltiplas instâncias do Next.js, coordene a compilação, as action keys aplicáveis, a invalidação do cache e as diferenças de versão entre componentes. Armazene em cache somente respostas públicas elegíveis; nunca compartilhe a sessão de um aluno ou uma página privada. Restrinja os cabeçalhos de proxies confiáveis ao ingress controlado. Um IP encaminhado não é a identidade nem a permissão de um aluno.
Nós descartáveis ainda exigem um plano de estado e recuperação
Sessões/cache foram externalizadas para Valkey, uploads para Spaces e logs do backend enviados para fora do nó. Uma observação de 24 hora sem gravações de arquivos no backend apoiou o projeto; isso não comprovou que todas as rotas futuras são sem estado nem tornou segura a exclusão abrupta. Filas e tarefas agendadas permaneceram em um único worker fixo, um ponto de falha conhecido; centralizá-las não garante, por si só, efeitos exatamente uma vez.
O frontend antigo precisava permanecer compatível enquanto as conexões existentes e os endereços em cache persistiam. Um TTL de 300 segundo não encerra conexões já estabelecidas, e a observação de 36% por si só não pode identificar todas as causas. A reversão do DNS não é um rollback instantâneo e não deve criar dois escritores no banco de dados. Após as novas gravações, a recuperação precisa preservá-las.
O resultado útil foi um procedimento repetível de preparação e drenagem, não a promessa de que ninguém jamais perceberá uma substituição. A seguir, a Parte 3 mostra a migração do banco de dados e o cliente legado que a equipe esqueceu.
Revisado em 6 de novembro de 2026. Anichur Rahaman, fundador da StoreConsole. As observações históricas do caso foram mantidas a partir dos registros existentes do projeto; as orientações gerais são sustentadas pelas principais referências, não por um novo teste ao vivo.