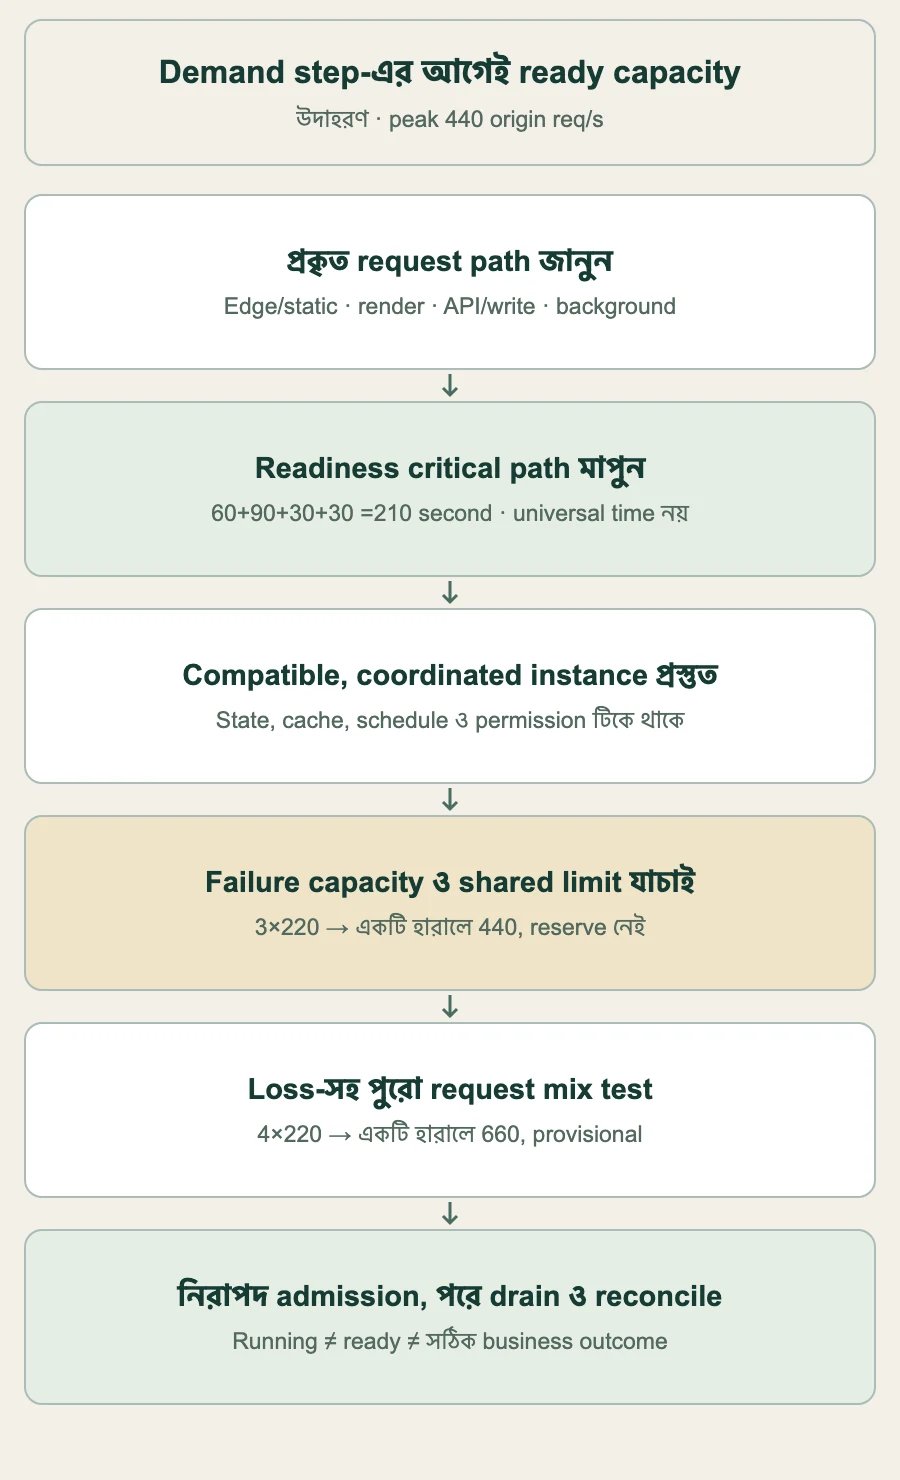
রাত বারোটায় scheduled promotion শুরু। Origin demand 20 থেকে 440 request/second-এ ওঠে; team scaling rule-এর নতুন capacity-এর অপেক্ষায়। Machine চালু হলেও image pull, app boot, registration ও cache warmup বাকি থাকতে পারে। “Running” মানেই কার্যকর checkout নয়। এটি উদাহরণ, reported incident বা StoreConsole benchmark নয়।
জানা demand প্রস্তুতির সময় দেয়; বেশি machine কাজে লাগবেই—এমন নিশ্চয়তা নয়। Arrival pattern, প্রকৃত request path, shared constraint ও ready হতে লাগা সময় এক plan-এ আনতে হবে। Engineering for High Volume-এর এই part 1 edge থেকে application পর্যন্ত পথ নিয়ে।
নতুন machine নয়, ব্যবহারযোগ্য capacity-এর সময় ধরুন
Reactive scaling একটি control loop: signal দেখা, মূল্যায়ন, capacity চাওয়া, workload চালু ও traffic নেওয়া। Warm pool বা হালকা process দ্রুত আসতে পারে; বড় image, quota ও cold dependency ধীর হতে পারে। সবার জন্য এক-থেকে-তিন মিনিটের minimum বা সব policy-তে একই cooldown নেই।
AWS step/simple scaling ও warmup আলাদা করে। Actual policy, metric period, evaluation ও scale-in rule পড়ুন। Simple scaling-এর default সব target-tracking scale-out-এর আগে অপেক্ষা নয়। নিজের পরিবেশে failed provisioning ও readiness-সহ critical path মাপুন।
শুধু planning example: ধারাবাহিক detection/control 60 second, provisioning 90, registration/health 30 ও warmup 30, মোট 210 second বা 3 minute 30 second। বাস্তবে ধাপ overlap করতে পারে। Observed slow case ও যুক্তিযুক্ত buffer ধরে আগে capacity schedule করুন; শুধু running VM গুনে readiness হয় না।
ধারাবাহিক example stage
Second
Cumulative second
Detection/control
60
60
Provisioning
90
150
Registration/health
30
180
Warmup
30
210
জানা event-এ scheduled/predictive preparation-এর সঙ্গে বাকি variation-এর reactive rule ও সর্বোচ্চ spend/capacity রাখুন। Pre-scaling-এর cost আছে, fail-ও হতে পারে। Quota, instance availability ও dependency যাচাই করুন। Tested capacity-এর বেশি demand-এ admission control বা সত্য waiting experience রাখুন।
কোন path সত্যি origin-এ যায় তা আঁকুন
Cached static asset, public-page hit, dynamic render, API, checkout write ও background job আলাদা করুন। Edge request, origin request, user ও order এক unit নয়। Next.js page API ডাকতে পারে; monolith internal SSR দিয়ে render করতে পারে; কিছু API SSR এড়ায়। সব request-কে বানানো এক chain-এ ফেলবেন না।
Host/locale/variant policy অনুযায়ী immutable asset ও সত্যিই shareable response cache করুন। Personal account, cart, permission-dependent content ও session-set করা response-এ যথাযথ bypass/private handling লাগবে। Public দেখালেও page personalised হতে পারে। Warm/cold cache, invalidation, stampede ও actual hit ratio test করুন।
WAF/rate control ও load balancer-এও connection, TLS, bandwidth, registration, quota ও health limit থাকে। Managed মানেই unlimited বা কখনো bottleneck নয়—এমন নয়। AWS ALB capacity reservation sudden event-এর provider-specific option; পুরনো doubling claim কপি না করে নিজের workload-এ estimate/verify করুন।
Health check যতটুকু test করে ততটুকুই প্রমাণ। Dependency-aware probe ও representative journey দিয়ে readiness দেখুন; shared dependency unhealthy বলে সব useful node সরিয়ে দেবেন না। Draining, propagation ও grace period test করুন। Draining disruption কমায়, invisible scaling বা failed request মেরামতের নিশ্চয়তা নয়।
State হারানো ছাড়া instance বদলযোগ্য করুন
Instance হারালেও session, upload, job ownership, lock ও mutable business state পাওয়া চাই। উপযুক্ত shared database/session store বা durable shared/object storage কাজে আসতে পারে। Redis/S 3 option, প্রত্যেক deployment-এর বাধ্যতামূলক উত্তর নয়। Local immutable cache বৈধ হতে পারে। Shared coordination/invalidation ও disposable local cache-এর consistency চাহিদা আলাদা।
Next.js self-hosting guidance multi-instance cache ও build/version বিষয় ব্যাখ্যা করে। Compatible artifact দিয়ে invalidation, identity/secrets ও generated asset coordinate করুন। শুধু shared cache store হলেই সব cache type, tag ও in-flight version নিরাপদ নয়।
Scheduled work coordinate ও duplicate business effect আটকান। Laravel scheduler documentation shared atomic-lock single-server scheduling ব্যাখ্যা করে। Lock, expiry/failover ও unique operation identity-তে failure test লাগবে; শুধু একটি node-এ cron চালানো সম্পূর্ণ exactly-once design নয়।
প্রকৃত proxy/app path-এ body/time limit ও upload behaviour মিলান; অপ্রাসঙ্গিক সব service-এ নয়। Node failure-এ accepted upload বা payment result হারানো ঠেকান। Authoritative service-এ tenant/record permission আবার যাচাই হবে; scale-out নতুন authority দেয় না।
SSR/FPM workload মাপুন, শুধু host CPU নয়
এক Node event loop-এ CPU-bound JavaScript saturate হতে পারে, host-এর অন্য core idle থাকলেও। তাই বলে Node process অন্য core ব্যবহার করতেই পারে না নয়: native work, runtime background ও worker thread বিষয় বদলায়। Process বাড়ানো, render/cache বদলানো বা code optimise করার আগে per-process CPU, event-loop delay, memory/GC, I/O ও backend wait মাপুন।
PHP-FPM-এর official pool setting concurrent request ও lifecycle সীমিত করে। আলাদা steady-state example-এ প্রতি second 200 request worker execution শুরু করে, mean worker-occupied time 0.15 second হলে গড়ে প্রায় 30 occupied worker। এটি 60 children, core বা DB connection নির্ধারণ করে না; এখানে mean-এর জায়গায় p95 নয়।
কাল্পনিক incremental/private-memory budget প্রতি worker 100 MiB হলে 60 worker-এর 6,000 MiB≈5.86 GiB লাগে; OS, shared-memory allowance ও অন্য service বাদে। Shared OPcache-কে বারবার private memory হিসেবে যোগ নয়। Actual peak ও downstream connection/CPU limit মাপুন। বেশি FPM concurrency useful throughput না বাড়িয়ে database overload করতে পারে।
উপযুক্ত process mode ও cache safe representative request দিয়ে warm করুন। OPcache timestamp check বন্ধ হলে serving process refresh করার release procedure চাই; একটি copied setting বা CLI reset সব ক্ষেত্রে safety নয়। Process/container-ও দেরিতে start/warm হতে পারে; seconds-level scaling মেপে বলতে হবে।
Failure-এর পর capacity গুনুন, shared ceiling-ও test করুন
শুধু এই planning table-এ ধরে নিন, comparable app instance representative mix-এ chosen service objective মেনে 220 origin request/second রাখতে পারে। Peak 440 । গুণফল provisional budget, measured linear scaling-এর দাবি নয়। এখানে একটি instance বাদ যায়, পুরো host বা availability zone নয়।
তিন instance-এ nominal 660, একটি হারালে 440—ঠিক peak, spare নেই। চারটিতে 880, একটি হারালে 660, target-এর 1.5 গুণ। একই machine-এ রাখলে চার independent failure domain হয় না। যে host/zone loss সামলাতে চান সেটি test করুন।
Instance
Nominal req/s
একটি হারালে req/s
440 peak-এর তুলনা
2
440
220
Loss-এর পরে 220, peak-এর নিচে
3
660
440
440 ঠিক peak, reserve নেই
4
880
660
660-তে provisional headroom
DB write, pool connection, cache/lock contention, payment/courier quota, network ও background work আগে system ceiling তৈরি করতে পারে। এক tier বাঁচাতে আরেকটি flood করবেন না। Backpressure, bounded work ও operation ownership রাখুন; deferred job-এরও freshness target ও recovery budget চাই।
NGINX least_conn active connection ও weight দেখে, সব business cost বোঝে না। Least-outstanding-request algorithm একই জিনিস নয়। Long connection, multiplexing, request mix ও upstream limit অনুযায়ী choice বদলায়। Real workload-এ তুলনা করুন; round robin নিজে থেকেই ভুল নয়।
প্রস্তুতি ও acceptance map, throughput guarantee নয়। Time-to-ready, surviving instance ও shared limit—সব actual request mix-এ pass করতে হবে।
Load সামলাতে গিয়ে ফলাফল নষ্ট করবেন না
প্রথম response হারালে upstream retry একই effect আবার করতে পারে। NGINX retry rule কখন আরেক attempt হবে তা সীমিত করে; method label/proxy setting application idempotency-এর বিকল্প নয়। Payment error-এ নির্বিচার POST retry নয়। Durable operation identity, unknown result query এবং অনুমোদিত retry-তে bounded backoff/jitter, age/attempt limit ও owner রাখুন।
Business promise রক্ষা হয় এমন জায়গায় admission/rate control, readable status ও নিরাপদ ফিরে আসার পথ দিন। Unbounded queue থেকে customer-কে failed বলার পরে দেরিতে success ঘটাবেন না। Queue age-এ eligible ready কাজ ধরুন, ইচ্ছাকৃত future schedule নয়। Accepted/pending/completed order, reservation, captured payment ও delivery আলাদা দেখান।
Arrival, active work, recovery backlog ও minimum failure capacity অনুমতি দিলে scale-in করুন। Drain ও termination supervise করুন; owned কাজ শেষ হওয়া পর্যন্ত অপেক্ষা বা নিরাপদ recovery করুন, reconciliation evidence রাখুন। Event শেষের timer মানে payment/fulfilment obligation শেষ নয়।
Arrival pattern rehearse করে প্রমাণে capacity ছাড়ুন
Test-এর আগে business success, error/timeout limit ও latency objective ঠিক করুন। Browse, search, variant, cart, login ও authorised checkout fixture বাস্তব proportion-এ নিন, সঙ্গে cache miss/retry। External effect নিয়ন্ত্রণ করুন, যাতে rehearsal real customer charge বা parcel dispatch না করে।
k6 open ও closed workload model আলাদা করে। Step-arrival test-এ slow response যেন চুপিসারে offered demand কমিয়ে না দেয়। একটি arrival-rate iteration-এ বহু request থাকতে পারে; actual sent/completed rate, dropped iteration ও generator capacity দেখুন, শুধু configured VU নয়।
Target step, sustained peak, যুক্তিযুক্ত higher scenario, cold/revalidation, instance loss ও safe scale-in test করুন। Tail latency, business outcome, admitted/rejected কাজ ও per-tier wait ধরুন। Agreed limit ও operator/kill path রাখুন; CPU guard একা duplicate charge দেখে না। একটি material constraint বদলে relevant scenario আবার test করুন।
Midnight example-এ প্রস্তুত team দেখাতে পারবে কোন instance আগে ready, failure-এর পরে কী থাকে ও overload কীভাবে সামলাবে। পুরো 440-request mix objective মানে কি না integrated test-ই বলে। StoreConsole-সহ supplier-কে actual offered version, enabled module ও deployment-এ প্রমাণ দেখাতে বলুন।
পর্যালোচনা 5 নভেম্বর 2026 । আনিছুর রহমান, StoreConsole-এর নির্মাতা। Traffic, timing, memory ও capacity planning example; করা test বা guaranteed product throughput নয়।


 সফটওয়্যার আর্কিটেকচার

