পরীক্ষা শুরু হয় নির্দিষ্ট সময়ে। শিক্ষার্থীরা একসঙ্গে প্রবেশ করে, আর সময় চলতে থাকলেও সিস্টেমকে তাদের উত্তর গ্রহণ করতে হয়। শুধু বড় সার্ভার কিনলে গুরুত্বপূর্ণ প্রশ্নগুলোর উত্তর মেলে না: একটি নোড বন্ধ হলে, কোনো যৌথ সার্ভিস ধীর হলে বা ডেপ্লয়মেন্টে চলমান অনুরোধ বাধাগ্রস্ত হলে কী হবে?
এই পাঁচ পর্বে একটি কোর্স ও অনলাইন পরীক্ষা প্ল্যাটফর্মের পুরোনো ব্যবস্থা থেকে নির্ধারিত ব্যস্ত সময়ের প্রস্তুতি পর্যন্ত যাত্রা দেখব। প্রথম পর্বে অবকাঠামো বাছাইয়ের আগে ঝুঁকি শনাক্ত করার পদ্ধতি আলোচনা করা হয়েছে।
কেসটির পরিচয়: NovaCommerce একটি ছদ্মনাম। নিচের কনফিগারেশন ও পরিমাপ সেপ্টেম্বর–অক্টোবর ২০২৬-এর প্রকল্পের নথি থেকে নেওয়া। এগুলো সেই প্ল্যাটফর্ম ও কাজের চাপের ফলাফল; Store Console-এর বেঞ্চমার্ক নয়। সাধারণ প্রযুক্তিগত ব্যাখ্যা ৩ নভেম্বর ২০২৬-এ যাচাই করা হয়েছে।
শুরু হোক ব্যবসার গুরুত্বপূর্ণ মুহূর্ত থেকে
সারা দিনের গড় ট্রাফিক দিয়ে পরীক্ষার সক্ষমতা বোঝা যাচ্ছিল না। চ্যালেঞ্জ ছিল শুরুর মিনিট: একসঙ্গে প্রশ্ন লোড করা, সেশন যাচাই করা ও পরীক্ষায় প্রবেশ করা। সেখান থেকে চারটি চাহিদা নির্ধারণ করা হয়েছিল:
শুরুর আগেই প্রস্তুত থাকা: শিক্ষার্থীরা আসার আগে পর্যাপ্ত সক্ষমতা চালু ও সুস্থ থাকতে হবে।
সংরক্ষিত বলে জানানো উত্তর সুরক্ষিত রাখা: কখন উত্তর স্থায়ীভাবে লেখা হয়েছে এবং পুনরায় পাঠালে কীভাবে নকল রেকর্ড এড়ানো হবে, তা নির্ধারণ করতে হবে।
চলমান কাজের মধ্যে পরিবর্তন নিরাপদ রাখা: ডেপ্লয়মেন্ট ও নোড সরানোর সময় health check এবং চলমান অনুরোধ শেষ করার ব্যবস্থা দরকার।
খরচের কারণ ব্যাখ্যা করতে পারা: প্রতিটি নিয়মিত খরচের সঙ্গে পরিমাপ করা চাপ বা নির্দিষ্ট ব্যর্থতার সম্পর্ক থাকতে হবে।
এগুলো ছিল চাহিদা; সব ধরনের ব্যর্থতা ইতিমধ্যে পরীক্ষা করা হয়েছে, এমন দাবি নয়।
পুরোনো আর্কিটেকচারের দুর্বলতা
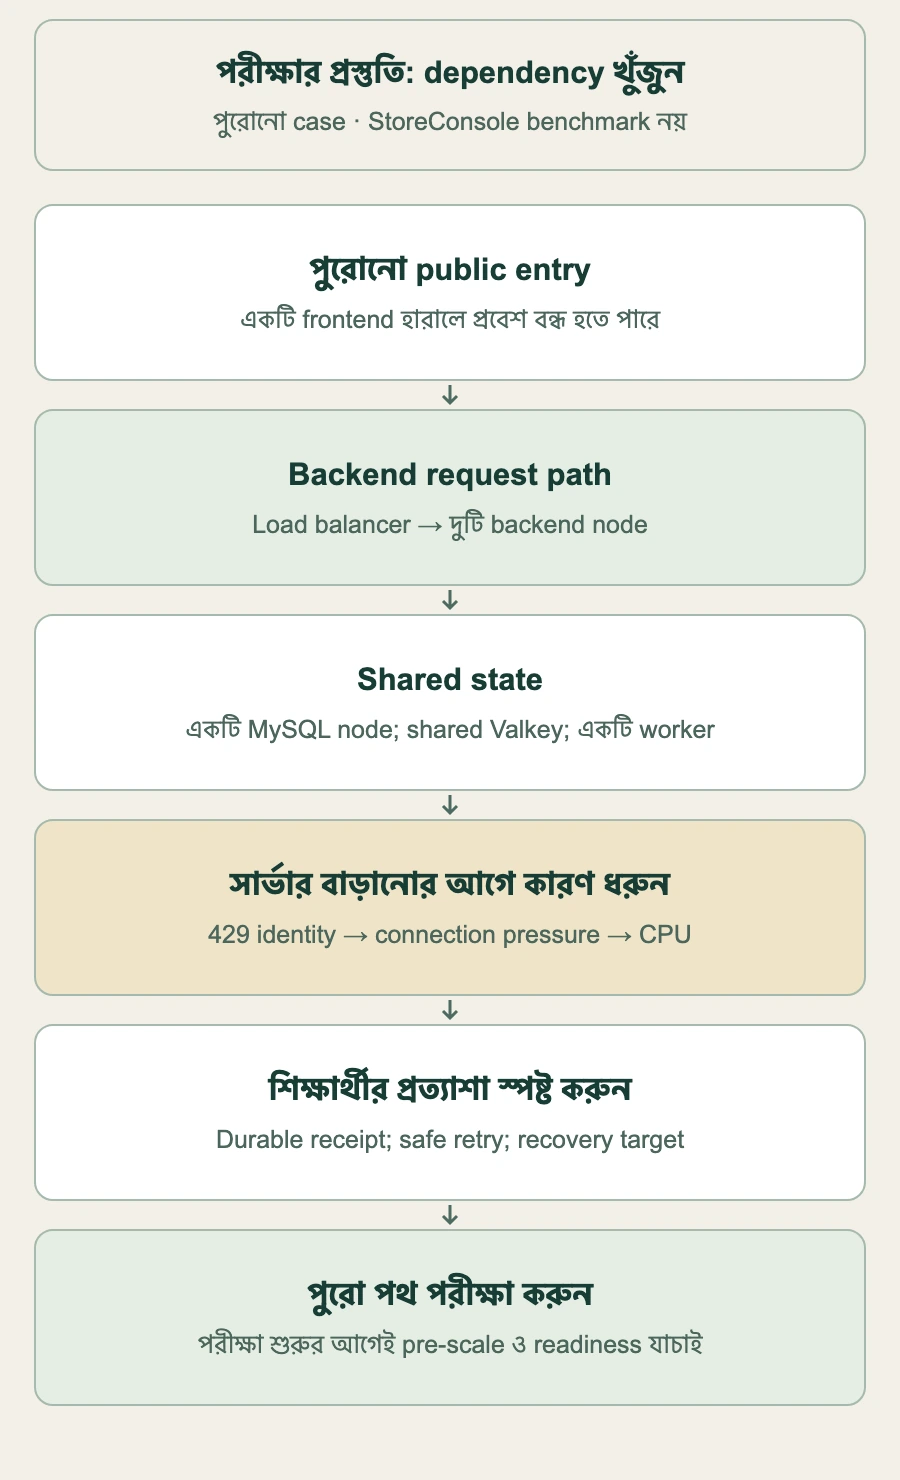
পুরোনো failure point থেকে পরীক্ষার আগে প্রয়োজনীয় প্রমাণের পথ। এটি case-এর শিক্ষামূলক মানচিত্র, availability guarantee নয়।
একটি 8 vCPU ও 16 GB Droplet-এ একটি Next.js container চলত; সামনে load balancer ছিল না। এই নোড হারালে পাবলিক সাইট বন্ধ হতে পারত। Backend-এ দুটি 4 vCPU ও 8 GB নোড nginx ও PHP-FPM দিয়ে Laravel চালাত। Background job, scheduler ও WebSocket আলাদা worker-এ চলত।
Backend load balancer নির্দিষ্ট Droplet ID ধরে ট্রাফিক পাঠাত। নতুন সার্ভার যোগ করলে সেটিকে নিবন্ধন করতে হতো; স্বয়ংক্রিয়ভাবে নতুন সক্ষমতা খুঁজে নিত না। Session, cache ও queue managed Valkey-তে থাকায় web node বদলানো তুলনামূলক সহজ ছিল।
MySQL-এর একটি 8 vCPU ও 32 GB managed node ছিল, configured standby ছিল না। Managed service ব্যর্থ নোড প্রতিস্থাপন করতে পারে; কিন্তু সেটি প্রস্তুত replicated standby-কে primary করার সমান নয়। একমাত্র worker-ও asynchronous কাজের একটি failure point ছিল।
আরও দুটি Droplet recovery-র জন্য বন্ধ রাখা হয়েছিল। Recovery procedure-এ এগুলো কাজে লাগতে পারে, কিন্তু তখন ট্রাফিক সেবা দিত না এবং automatic failover দিত না।
Node.js সম্পর্কে সতর্কতা: একটি JavaScript event loop CPU-নির্ভর rendering-এর সীমা হতে পারে। তবে Node.js worker pool ও native operation-ও ব্যবহার করে। শুধু একটি container আছে বলে আটটির মধ্যে সাতটি core অলস ছিল বলা যায় না। Process সংখ্যা নির্ধারণে profiling ও load test দরকার।
Availability-কে পরীক্ষাযোগ্য করুন
পুরো প্ল্যাটফর্মকে শুধু “highly available” বলার বদলে প্রতিটি ব্যর্থতায় ব্যবহারকারীর অভিজ্ঞতা নির্ধারণ করা হয়েছিল:
Web node বন্ধ হলে: সুস্থ নোড সেবা দেবে; অসুস্থ নোডে নতুন ট্রাফিক যাবে না।
Database বন্ধ হলে: নথিভুক্ত failover পদ্ধতি সেবা ফিরিয়ে আনবে; application সাময়িক disconnection সামলাবে।
ডেপ্লয়মেন্টে: পুরোনো নোড বন্ধ করার আগে নতুনটি প্রস্তুত হবে; চলমান অনুরোধ শেষ করার সময় পাবে।
নির্ধারিত ব্যস্ত সময়ে: আগে থেকেই পর্যাপ্ত সক্ষমতা এবং অসম ট্রাফিক সামলানোর বাড়তি জায়গা থাকবে।
Availability ও data durability-র প্রমাণ আলাদা। Stateless web node প্রতিস্থাপন সহজ করে; নিজে থেকে উত্তর হারাবে না, এমন নিশ্চয়তা দেয় না। Database commit, replication ও persistence settings, duplicate-safe retry, backup এবং recovery test-ও দরকার। একটি region-এর ব্যবস্থা দিয়ে regional outage থেকে recovery প্রমাণ হয় না।
তিনটি সমস্যা, তিন ধরনের প্রতিক্রিয়া
১. HTTP 429: ভুল পরিচয় ধরে সীমা গণনা
২৫ সেপ্টেম্বর একই স্কুল বা carrier network-এর শিক্ষার্থীরা “too many requests” পাচ্ছিল। Authenticated identity ঠিকমতো resolve না হওয়ায় API limiter IP address ধরছিল। ফলে অনেকে একই allowance ভাগ করছিল।
Authenticated limit শিক্ষার্থী বা শিক্ষকের account ধরে গণনা করা হয়; guest-এর জন্য IP fallback থাকে। সার্ভার বাড়ালে এই নিয়ম বদলাত না। Account-ভিত্তিক limit-এর পাশেও abuse protection দরকার; throttling তুলে দেওয়া সমাধান নয়।
২. Valkey timeout: যৌথ নির্ভরতার ব্যর্থতা
৬ অক্টোবরের পরীক্ষায় Valkey connection timeout-সহ 2,854 application error ধরা পড়ে। নথিতে প্রতি অনুরোধে নতুন TLS connection-এর overhead এবং primary ও standby-র প্রতিটি নোড 4 GB থেকে 8 GB করার কথা আছে।
এরপর 25–500 requests/second ধাপে বাড়ানো পরীক্ষায় application error শূন্য হলেও load balancer-এ 143 error ছিল, যখন backend CPU পূর্ণ হয়ে যায়। ওই পরীক্ষায় application timeout সমস্যা দূর হওয়ার প্রমাণ আছে; সর্বোচ্চ চাপে পুরো request path সফল ছিল, এমন প্রমাণ নেই। অনুরোধ তখনও ব্যর্থ হয়েছে।
শুধু timeout থেকে RAM কম ছিল বলা যায় না। অন্য সিস্টেমে বড় plan নেওয়ার আগে connection churn, limit, network ও service metrics পরীক্ষা করুন।
৩. Backend CPU: পরবর্তী সীমা
পরীক্ষিত API mix-এ একটি 4 vCPU backend node পূর্ণ CPU-তে প্রায় 65–70 requests/second দিয়েছিল। এটি saturation point; নিরাপদ operating target বা অন্য সিস্টেমের benchmark নয়। CPU-র কাজ কমানো এবং সক্ষমতা বাড়ানো—দুটিই মূল্যায়নযোগ্য।
এক পরীক্ষায় CPU 99% হওয়ার প্রায় সাত মিনিট পর প্রথম অতিরিক্ত autoscaled node আসে। এটি ওই ব্যবস্থার ফলাফল। নির্ধারিত পরীক্ষার জন্য আগেই scale করা এবং শুরুর আগে readiness যাচাই করা ছিল ব্যবহারিক সিদ্ধান্ত।
খরচ তুলনায় একই সীমা রাখুন
পুরোনো নথিতে web tier প্রায় $416/month; এর মধ্যে বন্ধ Droplet দুটির জন্য $112/month। এগুলো সেপ্টেম্বর–অক্টোবর ২০২৬-এর ঐতিহাসিক হিসাব; database, Valkey ও storage এতে নেই। পরবর্তী পুরো stack-এর বিলের সঙ্গে সরাসরি তুলনা করা যাবে না।
DigitalOcean-এ reserved CPU Droplet বন্ধ থাকলেও বিল হয়। Cold capacity মূল্যবান কি না, তা নির্ভর করে সত্যিই কত দ্রুত recovery দিতে পারে তার ওপর। কোন ব্যর্থতা সামলাবে, কত সময় লাগবে, আর সর্বশেষ কখন পদ্ধতিটি পরীক্ষা হয়েছে—এগুলো জিজ্ঞেস করুন।
Provider plan-ও বদলায়। বর্তমান DigitalOcean নথিতে PostgreSQL ও MySQL Standard Edition-এর সীমাবদ্ধতা আগে কখনো PostgreSQL বা MySQL cluster তৈরি না করা account-এর জন্য ১৫ অক্টোবর ২০২৬ এবং সব account-এর জন্য ৩০ নভেম্বর ২০২৬ থেকে প্রযোজ্য হওয়ার ঘোষণা আছে। পুরোনো কনফিগারেশন অনুসরণ করার আগে বর্তমান eligibility ও দাম যাচাই করুন।
নিজের পরবর্তী peak-এর আগে একই পর্যালোচনা করুন
পরীক্ষা, product launch বা checkout surge-এর critical request path লিখুন। Shared dependency ব্যর্থ হলে কী হবে তা নির্ধারণ করুন। এরপর প্রত্যাশিত workload-এ পুরো path-এর successful response, tail latency ও failure মাপুন। প্রমাণ যে layer নির্দেশ করে, সেটি বদলে আবার পরীক্ষা করুন।
পর্যালোচনা: ৬ নভেম্বর ২০২৬। উত্তর গ্রহণের অর্থ স্পষ্ট করুন: durable save-এর receipt, operation ID এবং একই কাজের safe retry দরকার। Queue job যেন উত্তরের একমাত্র কপি না হয়। Standby, backup ও সফল restore test আলাদা সমস্যা সমাধান করে; একটি থাকলেই zero data loss প্রমাণ হয় না। নিচের পুরোনো incident সংখ্যা বিদ্যমান case record থেকে রাখা হয়েছে; এই editorial review-তে নতুন করে স্বাধীনভাবে মাপা হয়নি।



 সফটওয়্যার আর্কিটেকচার

