যে Queue কাজ শেষ করে: Capacity, দায়িত্ব ও নিরাপদ Recovery
দ্রুত response-এর পেছনে business work বাকি থাকতে পারে। Arrival ও backlog ধরে worker pool মাপুন, accepted record রাখুন এবং retry-এর দায়িত্ব নির্ধারণ করুন।
সকাল 9 টায় exam platform 1,000 টি answer স্থায়ীভাবে গ্রহণ করেছে, grading বাকি। Student দেখবেন “received; grading pending”, বানানো result নয়। ERP-তে invoice তৈরি বা order-এর shipping label-এও একই বিষয়: request গ্রহণ ও background obligation শেষ আলাদা ঘটনা। এটি শেখানোর উদাহরণ।
Queue অসম arrival সামলায়; processing capacity তৈরি বা business action শেষ হওয়ার প্রমাণ দেয় না। Engineering for High Volume-এর part 2-তে authoritative record থেকে bounded worker pool, অনিশ্চিত external result ও controlled recovery পর্যন্ত সেই দায়িত্ব অনুসরণ করব। ব্যক্তিগত test বা customer result দাবি নয়।
Success বলার আগে accepted fact সংরক্ষণ করুন
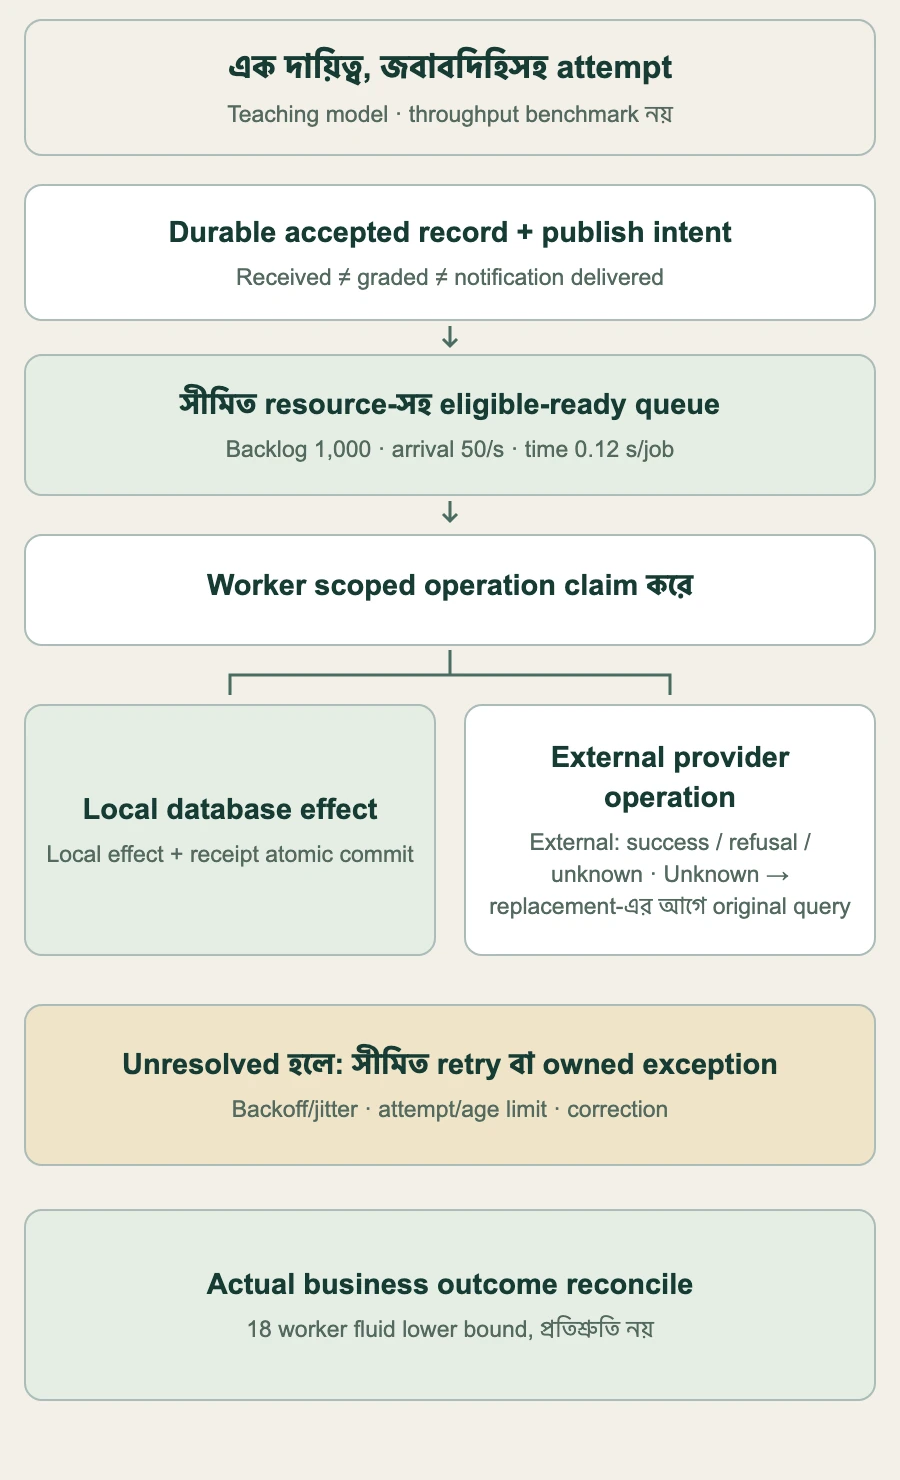
Interface “received” বলার আগে validated submission টিকে থাকতে হবে। Answer, order বা approval-এর একমাত্র কপি expendable queue-তে নয়। কী accepted, কে authorise করেছেন ও কী কাজ বাকি রাখুন; grading, notification ও external delivery আলাদা state।
Laravel queue documentation commit-এর পরে dispatch ব্যাখ্যা করে। এতে uncommitted record পড়ে কাজ করা বা rollback-এর পরও job থেকে যাওয়া এড়ানো যায়। তবে business record commit ও অন্য queue-তে publish আলাদা write হলে commit-এর পর crash-এ message না-ও হতে পারে।
Critical obligation-এ উপযুক্ত atomic queue/database design বা owned change-এর সঙ্গে publication intent রাখা transactional outbox ব্যবহার করুন। Recoverable relay publish করবে। Duplicate, retention ও operational failure-এর control তবুও লাগে; শুধু “after commit” no-loss guarantee নয়।
কাজের শ্রেণি আলাদা করে প্রয়োজনীয় resource রাখুন
প্রতি কাজের completion/freshness objective দিন। Submission, payment reconciliation, notification, image processing ও report-এর urgency, cost ও failure আলাদা হতে পারে। আলাদা queue routing সাহায্য করে; নিজে থেকে CPU, memory, DB capacity বা provider quota reserve করে না।
স্বাধীন capacity লাগলে explicit supervisor/pool budget রাখুন। এক worker-এ high queue আগে লিখলেও একসঙ্গে এক job-ই চলে, পরের queue starve হতে পারে। Dedicated capacity চলমান long job-কে pre-empt করে না; low-priority কাজও একই DB-তে contention করতে পারে।
Web ও worker compute আলাদা করলে resource budget রক্ষা হতে পারে। Container/cgroup বা separate node—দুটিই উপযুক্ত হতে পারে। Shared DB/cache/network failure দুদিকেই লাগে; worker সরালেই page কখনো ভুগবে না—এমন প্রতিশ্রুতি ঠিক নয়।
Backlog-এর পাশাপাশি নতুন arrival গুনুন
এক মুহূর্তে ready backlog B=1,000 job, mean worker-occupied time s=0.12 second/job ধরা হয়েছে; প্রাসঙ্গিক I/O wait-সহ। মোট 120 worker-second। নতুন কাজ না এলে নিখুঁত balanced 12 worker-এর fluid lower bound 10 second। এমনকি একই indivisible job-এ 84 wave×0.12=10.08 second লাগবে; dispatch, skew, retry ও contention আরও যোগ হয়।
এবার প্রতি second 50 নতুন ready job আসতে থাকে। w worker-এ ideal throughput w÷0.12 । এটি 50 ছাড়ালেই backlog কমে; ideal drain time B÷(w÷s−50)। Table planning model, measured benchmark বা deadline guarantee নয়।
এই arrival-এ 10 second drain target-এর fluid lower bound w≥s×(50+B÷10)=18 । Variability, failure ও dependency-এর tested headroom লাগবে। Job count-কে runtime দিয়ে ভাগ করে worker count বলবেন না; unit ও target horizon জরুরি।
Worker
Ideal throughput job/s
Net backlog drain job/s
1,000-এর fluid drain
6
50
0
Net drain নেই
12
100
50
20 second
18
150
100
10 second
আরও worker একসময় shared bottleneck-এ লাগে। Useful completion, oldest eligible-ready age, occupied-time distribution, DB wait, lock contention ও provider limit মাপুন। ছোট ready queue-তেও reserved/stuck job অনেক হতে পারে; future delayed কাজ ready alert বাড়াবে না।
যে deployment চলে তার process বা replica scale করুন
বর্তমান Laravel 13 Horizon guidance simple-এ worker process ভাগ, auto allocation এবং ordered-queue false mode আলাদা করে; false-এও process count scale হতে পারে। Auto-তে array order strict priority নয়। “false মানে সব সময় fixed pool” না ধরে installed version দেখুন।
Horizon Redis queue worker supervise করে; বর্তমান docs-এ Redis Cluster support নেই। অনেক compute node-এ চলতে পারে, কিন্তু node provision নিজে করে না। Queue, supervisor ও replica মিলিয়ে minimum, maximum ও resource cap যোগ করুন। একটি supervisor-এর auto limit পুরো deployment-এর global limit নয়।
KEDA 2.21 Kubernetes workload-এ event-driven scaling signal দিতে পারে, HPA replica বদলায়। Available compute, polling/metric freshness, activation, image startup, readiness ও scale-down actual reaction ঠিক করে। Pod বা local process-এর universal seconds/minutes guarantee নেই; resource/operation cost-ও যায় না।
Actual driver-এর সঙ্গে signal মেলান। Redis list length ready entry ধরতে পারে, reserved/delayed বাদ যেতে পারে। জানা burst-এ যুক্তিযুক্ত minimum আগে প্রস্তুত রাখুন; reactive capacity tested limit-এর মধ্যে রাখুন। দুটি scaling loop-কে পরস্পর লড়তে দেবেন না।
Timeout, reservation expiry ও retry delay আলাদা ঘড়ি
কাল্পনিক Horizon/Redis budget: external-call deadline 10 second, job timeout 45, supervisor timeout 60, connection retry_after 90 । Shipped setting নয়। Horizon timeout job-এর বেশি ও retry_after boundary থেকে নিরাপদে কম হতে হবে; actual driver, runtime extension ও termination test করুন।
retry_after application retry-এর মধ্যের delay নয়। Reserved job ঠিকভাবে complete/release না হলে কখন আবার eligible হবে তা নিয়ন্ত্রণ করে। প্রথম worker তখনও চললে দ্বিতীয় worker একই job নিয়ে duplicate effect করতে পারে। SQS visibility ও অন্য driver-এর contract আলাদা।
উদাহরণ boundary
Second
উদ্দেশ্য
External call
10
Actual call সীমিত
Job timeout
45
এক job execution সীমিত
Horizon supervisor timeout
60
Job-এর বেশি; reservation expiry-এর কম
Redis retry_after
90
Reservation eligibility, retry backoff নয়
Attempt ও total-age limit, exception/release behaviour এবং প্রযোজ্য backoff/jitter দিন। Invalid permission বা bad data সংশোধন চায়, অনন্ত retry নয়। Failed-job store-এ alert, owner ও reviewed retry/cancel route লাগবে; শুধু row লেখা recovery নয়। কিছু middleware release-এ attempt খরচ হয়, actual semantics দেখুন।
Effect-এর সীমানায় duplicate attempt নিরাপদ করুন
শুরুতে “already done” দেখলে concurrent worker-এর সঙ্গে race বা receipt-এর আগে crash হতে পারে। Local DB effect-এ scoped unique operation claim, mutation ও processing result একই atomic transaction-এ রাখুন। Queue uniqueness/overlap lock দিয়ে external payment/email একবার হয়েছে প্রমাণ হয় না।
Provider call-এ durable business reference এবং supported idempotency/status lookup রাখুন। Stripe idempotency contract দেখায় key scope, parameter ও retention কেন গুরুত্বপূর্ণ। Unknown result-এ original operation query/reconcile করে তবে আরেকটি ভাবুন; নতুন key নতুন charge করতে পারে।
Paid invoice-এর PDF fail হলে document recover করুন, collection নয়। Email request acknowledged মানে inbox delivery নয়। Task attempt, provider result ও business completion আলাদা থাকুক; replay-এ approved current state মানুন, সব dedupe key মুছবেন না।
Queue হলো বাকি কাজের পরিবহন। Retry-তে business operation টিকে থাকবে; unknown provider result দৃশ্যমান থাকবে।
Memory, privacy ও deploy recovery একসঙ্গে বাজেট করুন
Resident worker/runtime overhead, retained memory, heavy-job peak ও shared/container base ধরুন। উদাহরণে 10 worker×128 MiB private/incremental allowance=1,280 MiB=1.25 GiB, অন্য overhead/headroom-এর আগে। এতে 2 GiB container যথেষ্ট প্রমাণ হয় না। Mixed pool-এ প্রত্যেকের worker×memory budget যোগ করে একসঙ্গে peak test করুন।
Streaming/chunking memory কমাতে পারে, কিন্তু library buffer করতে পারে; job ভাগ করলে order/recovery বদলায়। বানানো 288→128 MiB saving নয়, before/after মাপুন। প্রয়োজনমতো long-lived worker recycle করুন; evidence ছাড়া RAM/worker বাড়ালেও bottleneck থাকতে পারে।
ন্যূনতম scoped data দিন; ID মানে স্থায়ী fetch permission নয়। Owning service-এ authority ও state recheck করুন। Broker transport/storage, payload, failed record, dashboard ও export রক্ষা করুন। Payload encryption সব metadata/general log রক্ষা করে না। OWASP logging guidance secret বা salary/customer document না ঢেলে useful evidence রাখার ভিত্তি দেয়।
Compatible code/schema/payload deploy ও supervised long-running worker graceful replace করুন। পুরো queue খালি করতে হয় না। Tested termination/visibility limit-এ current কাজ শেষ বা নিরাপদ recovery করুন; পুরনো কাজ সামলানো পর্যন্ত compatibility রাখুন। Scheduler শেষে start করাই incompatible job বা duplicate schedule ঠিক করে না।
Queue-কে দৃশ্যমান দায় হিসেবে চালান
Laravel scheduler guidance shared atomic lock দিয়ে coordinated single-server কাজের পথ দেয়; fixed cron node-ই একমাত্র topology নয়। Expiry, overlap, failover ও missed-run recovery business idempotency-সহ test করুন। Periodic relay বৈধ হতে পারে; memory pressure-এ long-lived process সব সমস্যার উত্তর নয়।
Commit-এর আগে/পরে crash, publish failure, concurrent duplicate, unknown timeout, bad payload, revoked access, heavy-job peak ও deploy mid-job rehearse করুন। Real external charge/message আলাদা রাখুন। একই scope/time/state-এ pending obligation ও actual effect মেলান; শুধু “queue depth zero” নয়।
কাজে লাগা 9 টার dashboard বলবে answer received, grading pending/completed, notification accepted/confirmed ও exception কার দায়িত্ব। Exact completion target integrated test চায়। StoreConsole-সহ supplier-কে offered version ও enabled module-এ journey, permission ও bounded recovery দেখাতে বলুন।


 সফটওয়্যার আর্কিটেকচার

