परीक्षा तय समय पर शुरू होती है। विद्यार्थी एक साथ आते हैं और घड़ी चलते रहने के बीच प्लेटफ़ॉर्म को उनके उत्तर स्वीकार करने होते हैं। बड़ा सर्वर खरीदने से महत्वपूर्ण सवालों के जवाब नहीं मिलते: कोई नोड बंद हो जाए, साझा सेवा धीमी हो जाए या डिप्लॉयमेंट किसी अनुरोध को बीच में रोक दे, तो क्या होगा?
यह पाँच भागों की केस स्टडी एक कोर्स और ऑनलाइन परीक्षा प्लेटफ़ॉर्म की निर्धारित व्यस्त समय के लिए तैयारी दिखाती है। पहले भाग में हम बुनियादी ढाँचा चुनने से पहले जोखिम पहचानने का तरीका समझते हैं।
केस के बारे में: NovaCommerce पहचान छिपाने के लिए दिया गया नाम है। नीचे के कॉन्फ़िगरेशन और माप सितंबर–अक्टूबर 2026 के परियोजना रिकॉर्ड से हैं। ये उसी प्लेटफ़ॉर्म और कार्यभार के परिणाम हैं, Store Console का बेंचमार्क नहीं। सामान्य तकनीकी जानकारी की समीक्षा 3 नवंबर 2026 को की गई।
व्यवसाय की महत्वपूर्ण घटना से शुरुआत करें
दिन का औसत ट्रैफ़िक परीक्षा की क्षमता समझाने के लिए पर्याप्त नहीं था। असली चुनौती शुरुआती मिनट था: बहुत से विद्यार्थी प्रश्न लोड करते, सत्र जाँचते और लगभग एक साथ परीक्षा शुरू करते थे। इससे चार ज़रूरतें निकलीं:
शुरू होने से पहले तैयार रहें। लोगों के आने से पहले पर्याप्त क्षमता सक्रिय और स्वस्थ होनी चाहिए।
स्वीकार किए गए उत्तर सुरक्षित रखें। तय करें कि उत्तर कब टिकाऊ रूप से सहेजा गया है और दोबारा भेजने पर डुप्लिकेट कैसे रोके जाएँगे।
चलता हुआ काम बाधित न करें। डिप्लॉयमेंट और नोड हटाने के लिए health check तथा सक्रिय अनुरोध पूरे होने देने की व्यवस्था चाहिए।
खर्च समझा सकें। हर नियमित संसाधन किसी मापी गई क्षमता की ज़रूरत या स्पष्ट विफलता को संबोधित करे।
ये आवश्यकताएँ थीं; यह दावा नहीं कि विफलता के सभी परिदृश्य पहले ही जाँचे जा चुके थे।
पुरानी आर्किटेक्चर की कमजोरियाँ
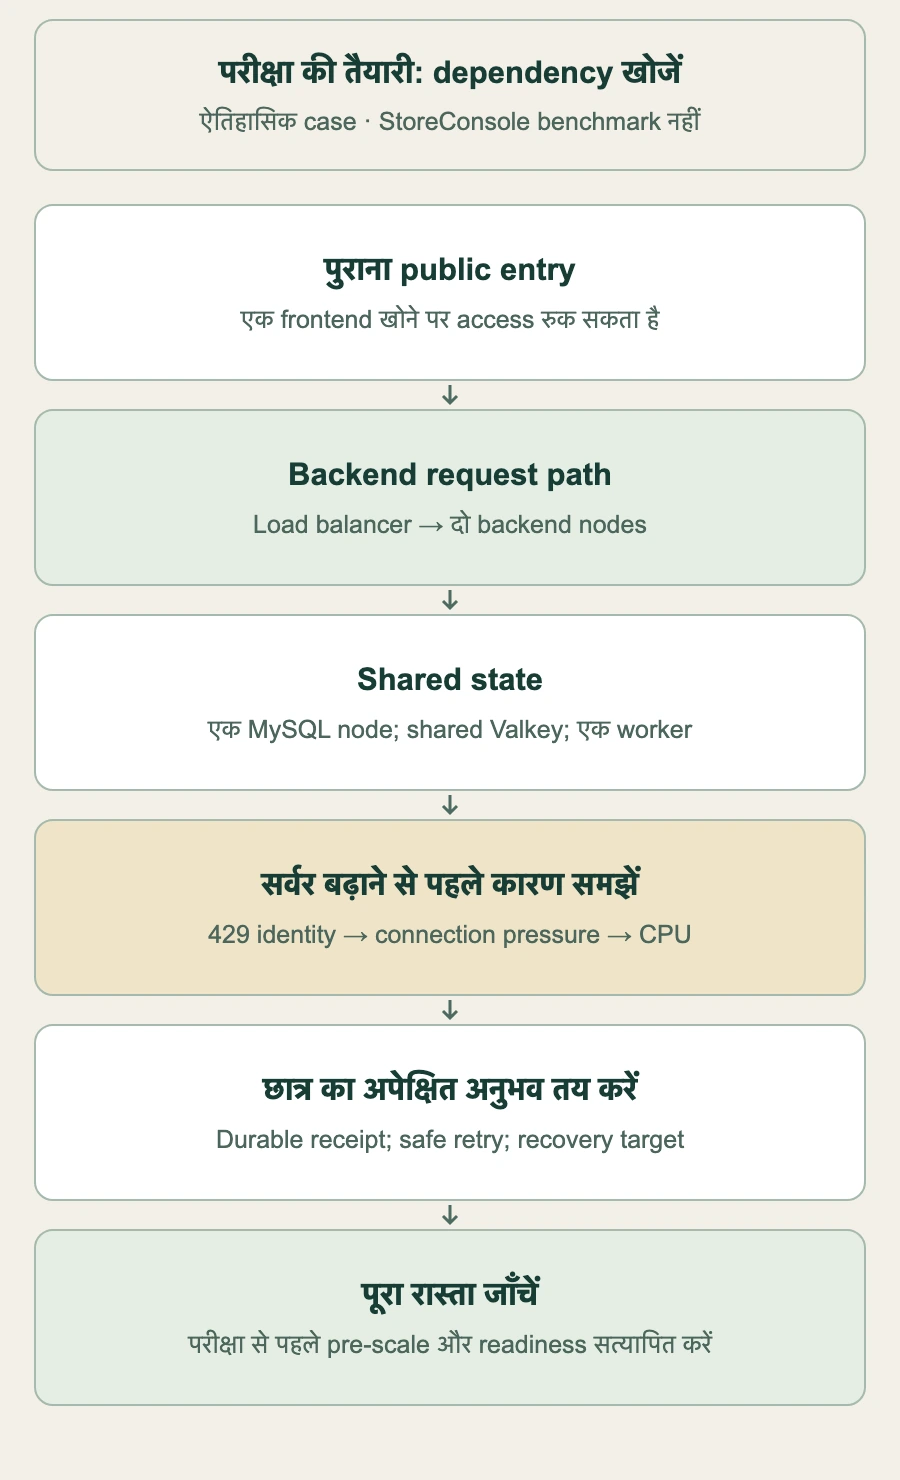
पुराने failure points से परीक्षा-पूर्व evidence तक। यह ऐतिहासिक case का शिक्षण map है, availability guarantee नहीं।
Frontend पर 8 vCPU और 16 GB वाले एक Droplet में एक Next.js container था। उसके आगे load balancer नहीं था। उस नोड के खोने पर सार्वजनिक वेबसाइट अनुपलब्ध हो सकती थी। Backend में 4 vCPU और 8 GB के दो नोड nginx और PHP-FPM से Laravel चलाते थे। Background job, scheduler और WebSocket अलग worker पर थे।
Backend load balancer निश्चित Droplet ID को लक्ष्य बनाता था। नया सर्वर जोड़ने पर उसका पंजीकरण करना पड़ता; यह कॉन्फ़िगरेशन नई क्षमता स्वयं नहीं खोजता था। Session, cache और queue पहले से managed Valkey में थे, जिससे web node बदलना आसान था।
MySQL का 8 vCPU और 32 GB वाला एक managed node था, configured standby नहीं था। Managed service खराब नोड बदल सकती है; यह उस replicated standby जैसा नहीं है जो primary की भूमिका लेने के लिए तैयार हो। अकेला worker भी asynchronous काम के लिए एक failure point था।
दो अतिरिक्त Droplet recovery के लिए बंद रखे गए थे। वे recovery procedure का हिस्सा हो सकते थे, लेकिन ट्रैफ़िक नहीं सँभाल रहे थे और automatic failover नहीं दे सकते थे।
Node.js की सही व्याख्या: एक JavaScript event loop CPU-प्रधान rendering को सीमित कर सकता है। लेकिन Node.js worker pool और native operation भी उपयोग करता है। केवल एक container होने से यह साबित नहीं होता कि आठ में सात core खाली थे। Process की संख्या profiling और load test से चुनें।
Availability को जाँचने योग्य बनाएँ
पूरे प्लेटफ़ॉर्म को केवल “highly available” कहने के बजाय हमने अलग-अलग विफलताओं में उपयोगकर्ता के अनुभव को परिभाषित किया:
Web node विफल हो: स्वस्थ नोड सेवा जारी रखें और खराब नोड को नया ट्रैफ़िक न मिले।
Database विफल हो: documented failover प्रक्रिया सेवा लौटाए और application अस्थायी disconnection सँभाले।
डिप्लॉयमेंट हो: पुराना नोड हटाने से पहले नया तैयार हो; सक्रिय अनुरोध पूरे होने का समय मिले।
निर्धारित peak आए: पर्याप्त क्षमता पहले से स्वस्थ हो और असमान ट्रैफ़िक के लिए गुंजाइश रहे।
Availability और data durability के लिए अलग प्रमाण चाहिए। Stateless web node बदलना आसान बनाते हैं; वे अपने आप उत्तर सुरक्षित रहने की गारंटी नहीं देते। Database commit, replication, persistence settings, duplicate-safe retry, backup और recovery test भी आवश्यक हैं। एक region का डिज़ाइन regional outage से recovery साबित नहीं करता।
तीन निष्कर्ष, तीन अलग प्रतिक्रियाएँ
1. HTTP 429: सीमा गलत पहचान पर गिनी जा रही थी
25 सितंबर को एक स्कूल या carrier network साझा करने वाले विद्यार्थियों को “too many requests” मिल रहा था। Authenticated identity सही resolve नहीं होने के कारण API limiter IP पर आधारित था। अनेक लोग एक allowance साझा कर रहे थे।
सुधार में authenticated limit विद्यार्थी या शिक्षक के account से जुड़ी और guest के लिए IP fallback रहा। अधिक सर्वर उस नियम को नहीं बदलते। Identity-आधारित सीमा के साथ भी abuse protection चाहिए; throttling हटाना समाधान नहीं है।
2. Valkey timeout: साझा निर्भरता पर दबाव
6 अक्टूबर के परीक्षण में Valkey connection timeout के साथ 2,854 application error मिले। केस रिकॉर्ड में नई TLS connection खोलने का overhead और primary तथा standby के हर नोड को 4 GB से 8 GB करने का उल्लेख है।
इसके बाद 25–500 requests/second की क्रमिक बढ़ोतरी में application error शून्य, लेकिन load balancer पर 143 error थे, जब backend CPU पूरी तरह व्यस्त हो गया। यह उस परीक्षण में application timeout हटने का प्रमाण है; सबसे अधिक लोड पर पूरे अनुरोध-पथ की सफलता का नहीं। अनुरोध अब भी विफल हुए थे।
Timeout अपने आप memory की कमी साबित नहीं करता। दूसरे सिस्टम में बड़ा plan लेने से पहले connection churn, limit, network और service metrics जाँचें।
3. Backend CPU: अगली सीमा
परीक्षित API mix में एक 4 vCPU backend node पूर्ण CPU पर लगभग 65–70 requests/second तक पहुँचा। यह देखा गया saturation point है; सुरक्षित operating target या दूसरे सिस्टम के लिए benchmark नहीं। CPU का काम घटाना और क्षमता जोड़ना, दोनों का मूल्यांकन करें।
एक परीक्षण में CPU 99% पर पहुँचने के लगभग सात मिनट बाद पहला अतिरिक्त autoscaled node आया। यह देरी इसी सेटअप की थी। निर्धारित परीक्षा के लिए पहले scale करना और शुरुआत से पहले readiness जाँचना व्यावहारिक निर्णय था।
खर्च की तुलना समान दायरे में करें
पुराने बजट में web tier लगभग $416/month था, जिसमें बंद Droplet के $112/month शामिल थे। ये सितंबर–अक्टूबर 2026 के ऐतिहासिक आँकड़े हैं। Database, Valkey और storage शामिल नहीं हैं; इन्हें बाद के पूरे stack के बिल से सीधे न तुलना करें।
DigitalOcean reserved CPU Droplet बंद होने पर भी बिल करता है। Cold capacity का मूल्य उसके वास्तविक recovery समय पर निर्भर है: वह कौन-सी विफलता सँभालती है, कितनी जल्दी मदद करती है और आखिरी बार कब जाँची गई थी?
Provider के plan बदलते हैं। वर्तमान DigitalOcean दस्तावेज़ PostgreSQL और MySQL Standard Edition पर नई सीमाएँ पहले कभी PostgreSQL या MySQL cluster नहीं बनाने वाले account के लिए 15 अक्टूबर 2026 और सभी account के लिए 30 नवंबर 2026 से लागू होने की घोषणा करते हैं। ऐतिहासिक कॉन्फ़िगरेशन दोहराने से पहले वर्तमान eligibility और कीमत जाँचें।
अगले peak से पहले यही समीक्षा करें
परीक्षा, product launch या checkout surge का critical request path लिखें। Shared dependency बंद होने पर क्या होगा, तय करें। अपेक्षित workload का परीक्षण करके पूरे पथ में successful response, सबसे धीमे अनुरोधों की latency और failure मापें। प्रमाण जिस layer की ओर इशारा करे, उसे बदलकर फिर जाँचें।
समीक्षा: 6 नवंबर 2026। उत्तर स्वीकार होने का अर्थ स्पष्ट हो: durable save की receipt, operation ID और उसी काम का idempotent retry। Queue job उत्तर की अकेली copy न हो। Standby, backup और सफल restore test अलग समस्याएँ सुलझाते हैं; एक से zero data loss सिद्ध नहीं होता। पुराने incident आँकड़े मौजूदा case record से सुरक्षित रखे गए हैं; इस editorial review में स्वतंत्र रूप से दोबारा नहीं मापे गए।



 सॉफ़्टवेयर आर्किटेक्चर

