Frontend-এর DNS বদলের এক ঘণ্টা পরও পুরোনো সার্ভারে প্রায় 36% traffic আসছিল। TTL 300 seconds করা হয়েছিল, hosts-file override দিয়ে নতুন পথও দেখা হয়েছিল। তবু ব্যবহারকারীরা দুটি দরজা দিয়ে ঢুকছিলেন। DNS বদল শেষ ঘোষণা করার চেয়ে পুরোনো দরজা সচল রাখা বেশি জরুরি ছিল।
NovaCommerce একটি course ও exam platform-এর গোপনীয়তা রক্ষার নাম। দ্বিতীয় পর্বে September–October 2026-এর বিদ্যমান case observation রাখা হয়েছে; এগুলো StoreConsole benchmark বা নতুন করে চালানো test নয়। প্রথম পর্বে rate-limit identity, Valkey connection pressure এবং backend CPU আলাদা বাধা ছিল। এবার application tier-এর গল্প।
যে tier-এর সিদ্ধান্ত আলাদা, তাকে আলাদাভাবে চালান
এই deployment-এ frontend-এর একটি load balancer ও autoscale pool, backend-এর জন্য আরেক জোড়া নেওয়া হয়। DNS name আগে থেকেই আলাদা ছিল। Health check, node size ও replacement policy আলাদা রাখা সুবিধাজনক হয়েছে; সব application-এ দুটি balancer লাগবেই—এমন নিয়ম নেই।
Backend-এর fixed Droplet ID list-এর বদলে tag দিয়ে discovery করা হয়। নতুন tagged node যথাযথ pool ও firewall rule পায়। Tag configuration মাত্র; app readiness বা authorization-এর প্রমাণ নয়। দুটি balancer-এর $48/month পুরোনো budget, বর্তমান quotation নয়।
Machine চাওয়া আর healthy capacity এক নয়
দুটি pool-ই 2–10 node-এর ছিল। Frontend node-এ 2 vCPU/4 GB, nginx ও দুটি Next.js container; backend-এ 4 vCPU/8 GB ও nginx/PHP-FPM। এগুলো এই deployment-এর পছন্দ। Node.js-এর একটি event loop দেখে বাকি CPU অব্যবহৃত বলা যায় না; worker pool ও native কাজও আছে।
পুরোনো frontend test-এ দুটি node প্রায় 356 requests/s, p95 0.05 s, শূন্য reported error ও 55–60% CPU দেখায়। সস্তা shared-CPU trial-এর পক্ষে এটি তথ্য ছিল; সব route, noisy neighbour বা answer-write capacity-এর প্রমাণ নয়। $28/$56 monthly node rate-ও পুরোনো planning input।
পুরোনো configuration
Frontend
Backend
Pool range
2–10 node
2–10 node
প্রতি node
2 vCPU / 4 GB; 2 Next.js container
4 vCPU / 8 GB; PHP-FPM
CPU target
70%
70%, পরে 55%
Health boundary
Next.js response check
nginx-only; app readiness আলাদা
অন্য state
Public cache coordination
Pool-এর বাইরে একটি fixed worker
পরীক্ষার ঘড়ি অনুযায়ী pre-scale করুন
5 October-এর 21:17–21:33 k6 run-এ GET-ভিত্তিক replay ছিল: 300–450 requests/s, এরপর ছয় মিনিট প্রায় 750। দুটি tier-ই দুই থেকে তিন node হয়। Reported server error/timeout শূন্য হলেও প্রায় 4% response ছিল shared test IP-এর HTTP 429। শিক্ষার্থীর request ফেরত গেলে সেটিও ব্যর্থ কাজ; এটি clean business-flow pass বা durable answer-write test ছিল না।
Overall p95 ছিল 132–153 ms, API p95 320–705 ms। এই configuration-এ 5–8 মিনিট metric lag এবং আরেক run-এ backend CPU 99% হওয়ার প্রায় সাত মিনিট পর বাড়তি node দেখা যায়। এটি provider-এর সর্বজনীন সময়সীমা নয়। পরীক্ষার প্রায় 45 মিনিট আগে pre-scale করে healthy capacity যাচাই করা হয়। Kubernetes বিবেচিত হয়েছিল, বাস্তবায়িত নয়; সেটিও instantly ready capacity নিশ্চিত করে না।
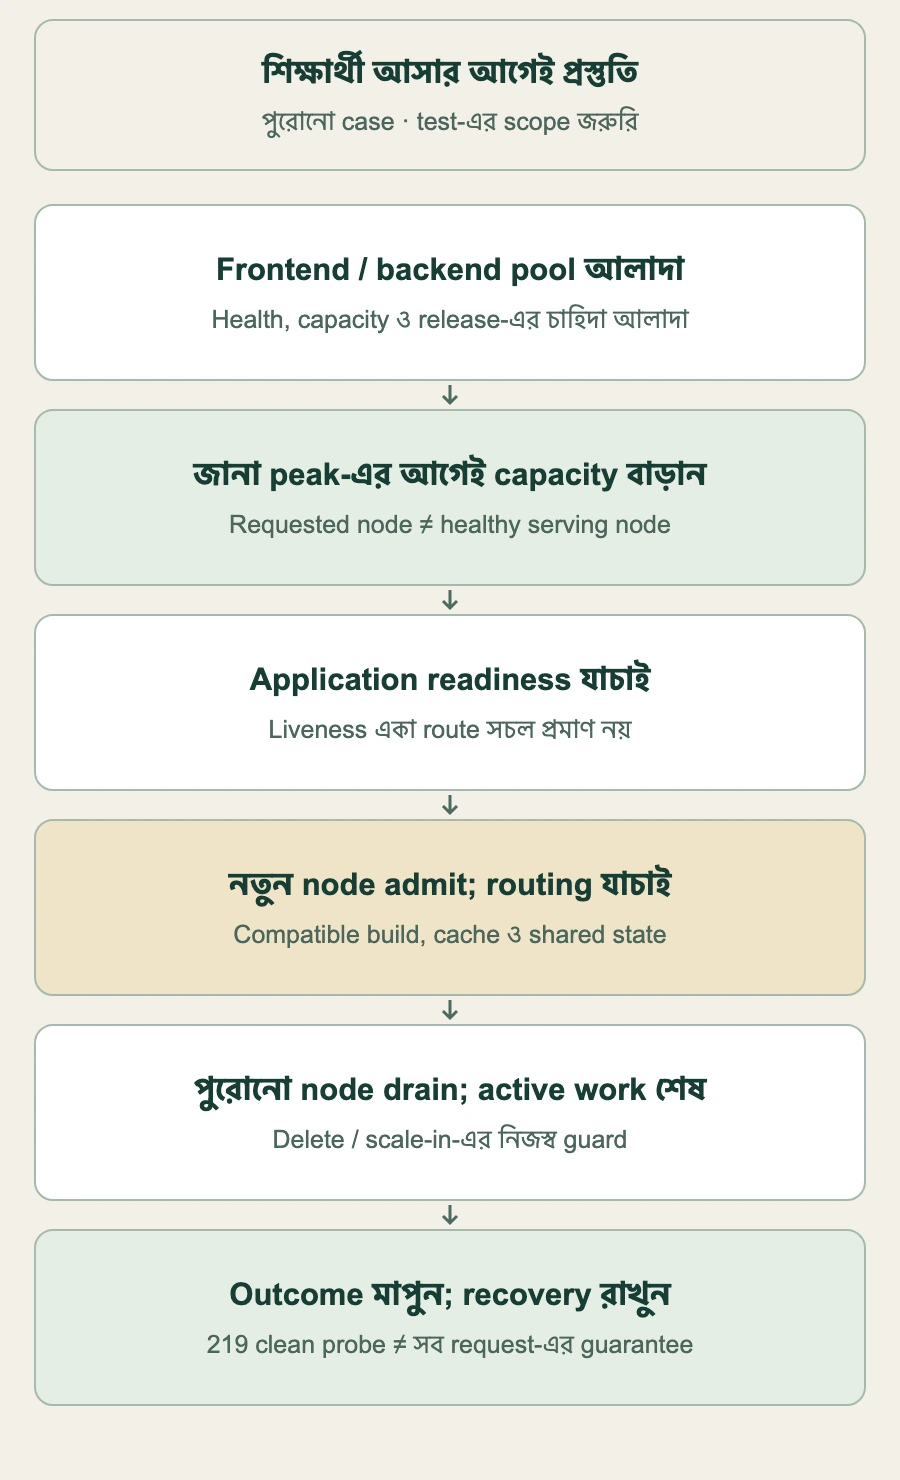
Case procedure-এর শিক্ষামূলক মানচিত্র। Readiness ও draining প্রমাণ দিয়ে যাচাই হয়; পুরোনো wait time সর্বজনীন guarantee নয়।
নতুন node কাজ করতে পারলেই পুরোনোটি সরান
প্রথম template rollout-এ অল্প সময় 503 আসে। পরে নতুন node ready ও balancer-এ admitted হওয়ার পর পুরোনোটি drain করে delete করা হয়। Case-এর 30–40 seconds ওই health-check setting-এর সময়; নিরাপদ gate আসল routing ও active work দেখে, শুধু timer নয়। Long request, WebSocket ও provider scale-in-এর জন্য আলাদা guard দরকার।
Backend-এর /lb-health কেবল nginx উত্তর দিত। এটি liveness ও drain switch হিসেবে কাজে লাগে, কিন্তু PHP বা database-নির্ভর route সচল প্রমাণ করে না। Bounded app readiness ও real-path probe রাখুন; প্রতিটি health check-কে ব্যয়বহুল query বানাবেন না। পরের rollout-এ দুই সেকেন্ড পরপর 219 probe-এ শূন্য error ছিল; সব user request বাধাহীন ছিল—এমন প্রমাণ নয়।
Tested immutable image এবং compatible database/queue change রাখুন। একাধিক Next.js instance-এ একই build, প্রযোজ্য action key, cache invalidation ও version skew সামলান। শুধু public response cache করুন; student session বা private page নয়। Trusted proxy header কেবল নিয়ন্ত্রিত ingress থেকে নিন। IP student identity বা permission নয়।
Disposable node-এরও state ও recovery পরিকল্পনা লাগে
Session/cache/queue Valkey-তে, upload Spaces-এ এবং backend log off-node রাখা হয়। 24 ঘণ্টা backend file write না দেখা design-কে সমর্থন করে; সব ভবিষ্যৎ route stateless বা abrupt deletion নিরাপদ প্রমাণ করে না। Queue ও scheduler একটি fixed worker-এ ছিল—এটি failure point; এক জায়গায় রাখলেই exactly-once হয় না।
পুরোনো connection ও cached address থাকা পর্যন্ত old frontend compatible থাকতে হয়। TTL 300 seconds হলে existing connection বন্ধ হয় না; 36% সংখ্যাটি দিয়ে সব কারণ শনাক্তও হয় না। DNS ফেরানো instant rollback নয়, দুটি database writer চালু করাও যাবে না। নতুন write হওয়ার পর recovery-তে সেগুলো রক্ষা করতে হবে।
ফল হলো repeatable readiness ও drain procedure, replacement কেউ কখনও টের পাবেন না—এমন প্রতিশ্রুতি নয়। তৃতীয় পর্বে database cutover এবং বাদ পড়া legacy client-এর ঘটনা।
পর্যালোচনা: ৬ নভেম্বর ২০২৬। Anichur Rahaman, StoreConsole প্রতিষ্ঠাতা। বিদ্যমান project record-এর পুরোনো observation রাখা হয়েছে; মূল সূত্র general guidance সমর্থন করে, নতুন live test নয়।



 সফটওয়্যার আর্কিটেকচার

