Frontend का DNS बदलने के एक घंटे बाद भी पुराने server को लगभग 36% traffic मिल रहा था। TTL 300 seconds किया गया था और hosts-file override से नया रास्ता जाँचा गया था। फिर भी दो प्रवेश द्वार चालू थे। बदलाव पूरा घोषित करने से अधिक ज़रूरी पुराना द्वार चलाना था।
NovaCommerce एक course और exam platform का अनाम नाम है। भाग 2 में September–October 2026 के मौजूदा case observations सुरक्षित हैं; ये StoreConsole benchmarks या दोबारा चलाए tests नहीं हैं। पहले भाग में rate-limit identity, Valkey connections और backend CPU अलग बाधाएँ थीं। अब application tier की बारी है।
अलग निर्णयों वाले tiers अलग चलाएँ
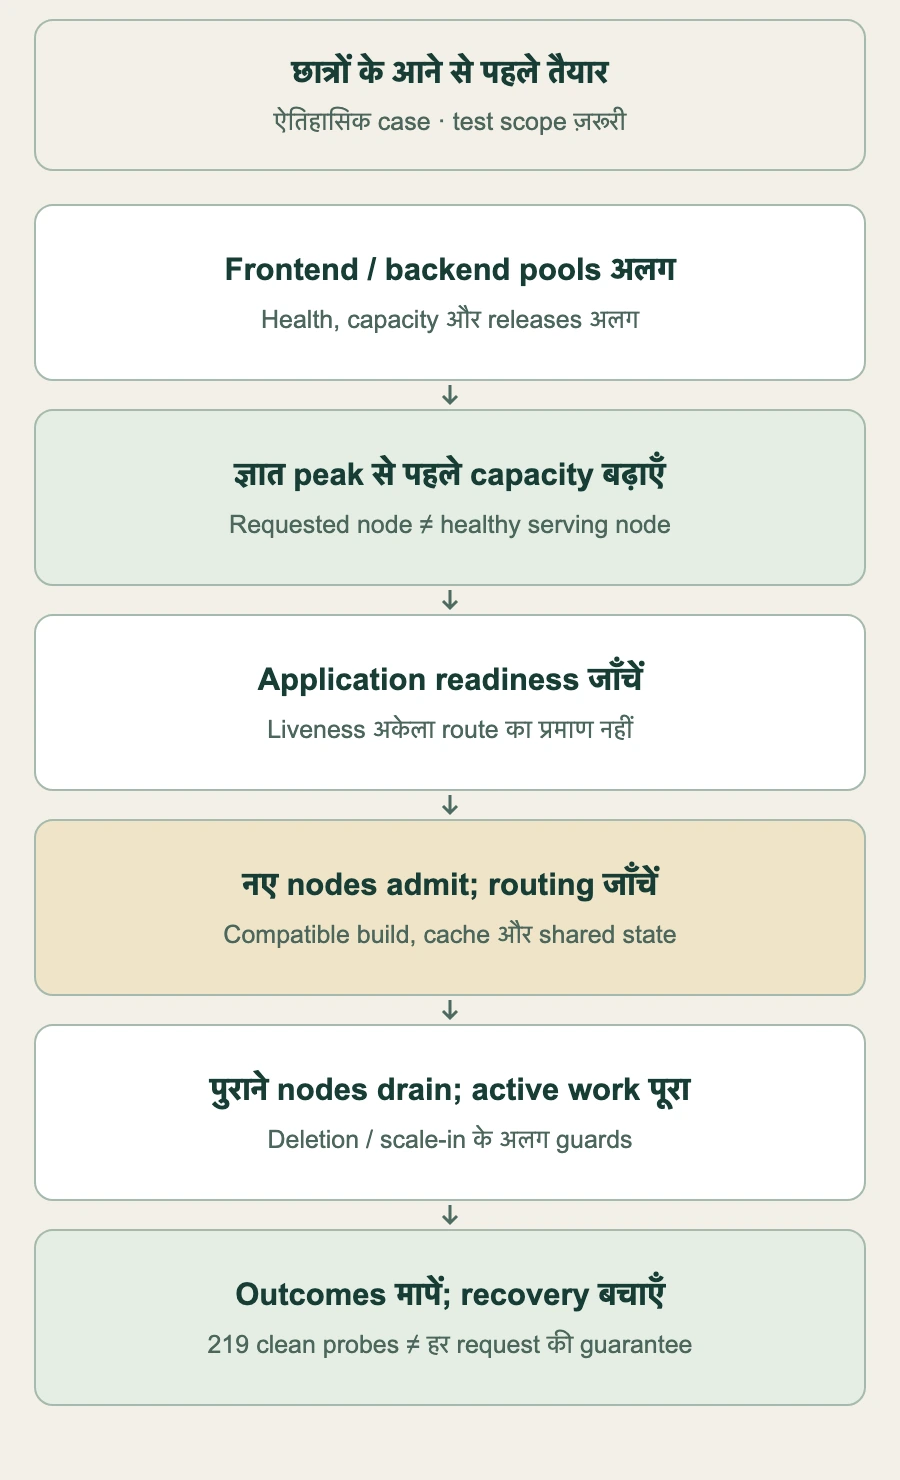
इस deployment में frontend के लिए एक load balancer और autoscale pool, backend के लिए दूसरी जोड़ी रखी गई। DNS names पहले से अलग थे। Health checks, node sizes और replacement policies अलग रखना उपयोगी था; हर application को दो balancers चाहिए, ऐसा नियम नहीं।
Backend की fixed Droplet ID list की जगह tag-based discovery आई। Tagged node सही pool और firewall rules पा सकता था। Tag configuration है, app readiness या authorization का प्रमाण नहीं। दोनों balancers का $48/month ऐतिहासिक budget है, वर्तमान quote नहीं।
माँगी गई machine और healthy capacity अलग हैं
दोनों pools में 2–10 nodes थे। Frontend node: 2 vCPU/4 GB, nginx और दो Next.js containers। Backend: 4 vCPU/8 GB, nginx/PHP-FPM। ये इस deployment के विकल्प थे। एक Node.js event loop से बाकी CPU निष्क्रिय सिद्ध नहीं होते; worker pool और native operations भी होते हैं।
पुराने frontend test में दो nodes ने लगभग 356 requests/s, p95 0.05 s, शून्य reported errors और 55–60% CPU दिखाया। इससे सस्ते shared-CPU trial का आधार मिला; सभी routes, noisy neighbours या answer-write capacity सिद्ध नहीं हुई। $28/$56 monthly node rates भी ऐतिहासिक planning inputs हैं।
ऐतिहासिक configuration
Frontend
Backend
Pool range
2–10 nodes
2–10 nodes
प्रति node
2 vCPU / 4 GB; 2 Next.js containers
4 vCPU / 8 GB; PHP-FPM
CPU target
70%
70%, बाद में 55%
Health boundary
Next.js response check
nginx-only; app readiness अलग
अन्य state
Public cache coordination
Pools से बाहर एक fixed worker
परीक्षा की घड़ी के लिए पहले scale करें
5 October, 21:17–21:33 के k6 run ने GET replay किया: 300–450 requests/s, फिर छह मिनट लगभग 750। दोनों tiers दो से तीन nodes हुए। Reported server errors/timeouts शून्य थे, लेकिन shared test IP के कारण लगभग 4% HTTP 429 थे। अस्वीकृत छात्र request भी असफल काम है; यह clean business-flow pass या durable answer-write test नहीं था।
Overall p95 132–153 ms और API p95 320–705 ms था। Case में 5–8 मिनट metric lag और दूसरे run में 99% backend CPU से अतिरिक्त node तक लगभग सात मिनट दर्ज थे। ये इस configuration के observations हैं, provider-wide guarantee नहीं। टीम लगभग 45 मिनट पहले pre-scale करके healthy capacity जाँचती थी। Kubernetes पर विचार हुआ, लागू नहीं; उससे भी तुरंत तैयार capacity सुनिश्चित नहीं होती।
Case procedure का शिक्षण map। Readiness और draining evidence gates हैं; पुराने wait times सार्वभौमिक guarantee नहीं।
पुराना node हटाने से पहले नया काम कर सके
पहले template rollout में कुछ 503 आए। बाद में replacement तैयार और balancer में admitted होने पर पुराने nodes drain करके हटाए गए। दर्ज 30–40 seconds उन्हीं health-check settings के थे; सुरक्षित gate actual routing और active work देखता है, केवल timer नहीं। Long requests, WebSockets और provider scale-in के अलग guards चाहिए।
Backend /lb-health केवल nginx से उत्तर देता था। यह liveness और drain switch है, PHP या database route की readiness नहीं। Bounded application readiness और real-path probes जोड़ें; हर health check महँगी query न बने। बाद के rollout में हर दो seconds पर 219 probes और शून्य errors थे; यह सभी users के लिए शून्य interruption का प्रमाण नहीं।
Tested immutable images और compatible database/queue changes रखें। कई Next.js instances में build, लागू action keys, cache invalidation और version skew समन्वित करें। केवल उपयुक्त public responses cache हों; छात्र session या private page नहीं। Trusted proxy headers नियंत्रित ingress से ही स्वीकारें। Forwarded IP छात्र identity या permission नहीं।
Disposable nodes को भी recovery चाहिए
Sessions/cache/queues Valkey में, uploads Spaces में और backend logs off-node रखे गए। 24 घंटे कोई backend file write न दिखना उपयोगी observation है; हर भविष्य का route stateless या abrupt deletion सुरक्षित नहीं सिद्ध होता। Queues और scheduler एक fixed worker पर रहे: known failure point। Centralising से exactly-once effects नहीं मिलते।
पुराने connections और cached addresses बने रहने तक old frontend compatible चाहिए। TTL 300 seconds existing connection बंद नहीं करता; 36% से अकेले हर कारण ज्ञात नहीं होता। DNS उलटना instant rollback नहीं और दो database writers नहीं बनाने चाहिए। नई writes आने के बाद recovery उन्हें सुरक्षित रखे।
परिणाम repeatable readiness और drain procedure है, replacement कभी किसी को दिखेगा ही नहीं ऐसा वादा नहीं। भाग 3 database cutover और छूट गए legacy client का विवरण देता है।
समीक्षा: 6 नवंबर 2026। Anichur Rahaman, StoreConsole संस्थापक। ऐतिहासिक observations मौजूदा project records से हैं; primary references general guidance के लिए हैं, नया live test नहीं।



 सॉफ़्टवेयर आर्किटेक्चर

