परीक्षा पूरी करके छात्र merit card की प्रतीक्षा करता है। उसका recomputation लगभग 0.34 seconds लेता है, लेकिन 6 October के record में कुछ cards 10–115 मिनट देर से आए। उसी lane के दो workers के आगे लगभग 2,000 AI jobs थे, हर एक करीब दस seconds का। छोटा काम कतार में अटका था।
NovaCommerce course और exam platform का अनाम नाम है। भाग 4 September–October 2026 के observations रखकर implemented changes और recommended safeguards अलग बताता है। यह नया incident audit या StoreConsole benchmark नहीं।
Shared state ने failure boundary बदली
Sessions, cache और queues managed Valkey में रखने से web nodes बदलना आसान हुआ। वही shared dependency भी बना: 6 October load test में 2,854 connection timeouts दर्ज हुए। Case में fresh TLS connections और primary/standby का प्रति node 4 GB से 8 GB resize है। अगली 25–500 requests/s ramp में application errors शून्य, मगर CPU saturation पर 143 load-balancer errors थे। Connection failure बदला; end-to-end requests फिर भी असफल थीं।
Timeout अकेला memory exhaustion या खास handshake CPU cost नहीं साबित करता। Connection churn, limits, network और server metrics देखें। Exam में 12.5% memory एक observation है, capacity guarantee नहीं। noeviction पुराने keys हटाने से रोकता है, लेकिन नई writes reject हो सकती हैं। यह queue persistence, lossless failover या cache/session/job isolation नहीं देता।
ज़रूरी परिणाम को अपनी serving capacity दें
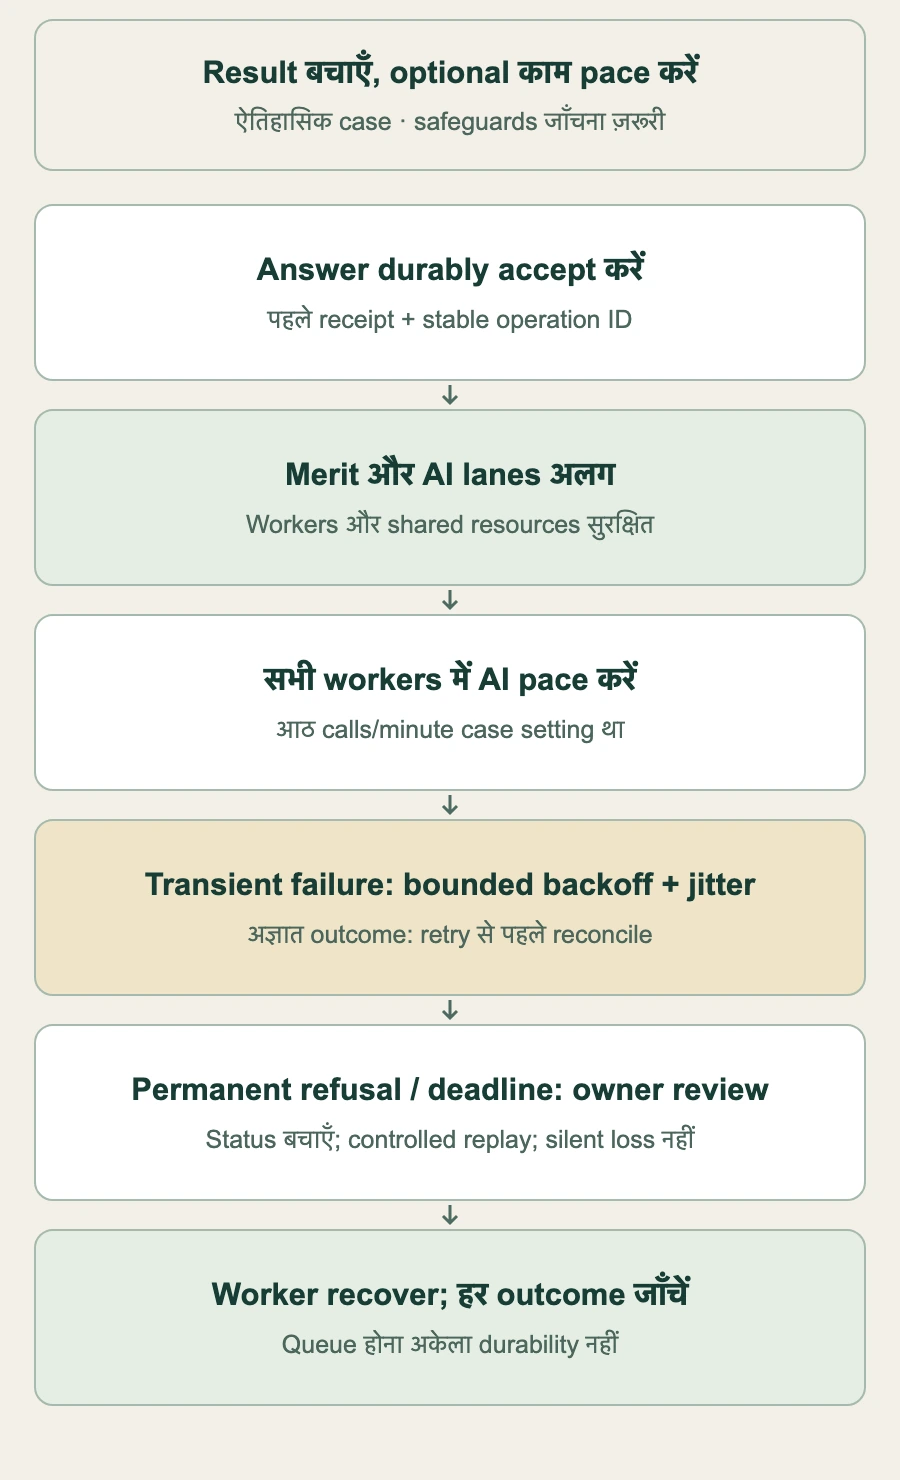
AI narrative lane merit/position काम से अलग की गई। Case में इसके बाद cards करीब एक मिनट में आने का उल्लेख है। केवल अलग queue names पर्याप्त नहीं; process allocation, database connections और shared CPU में भी urgent jobs के लिए जगह चाहिए।
पुराना हिसाब: 2,000×10=20,000 worker-seconds; दो workers में लगभग 10,000 seconds यानी 166.7 मिनट, overhead के बिना। यह संभावित wait समझाता है, exact forecast नहीं। बाद का provider limit अलग है: साझा आठ calls/minute पर 2,000 one-call jobs को कम-से-कम 250 मिनट, यानी 4 घंटे 10 मिनट चाहिए, retries और नई arrivals के बिना।
Failure class
Response
Completion evidence
Transient throttle
Shared limit; Retry-After; bounded jitter
Original operation reconcile
Credit/auth problem
Pause; alert; कारण सुधारें
Deadline देखकर controlled resume
External outcome अज्ञात
Replay से पहले query/reconcile
Duplicate side effect नहीं
Retry deadline समाप्त
Failed/pending record; review
Audited replay या स्पष्ट final state
Worker lost
Processing restore; ledger reconcile
Accepted work का हिसाब
हर refusal नहीं, पहचानी समस्या retry करें
ऐतिहासिक lane में shared eight-calls/minute limit, 1–15-minute exponential backoff with jitter, अधिकतम 12-hour retry window और temporary template text था। Credit shortage में करीब 3,800 delayed narratives और credit जोड़ने पर processing फिर शुरू होना दर्ज है। इससे हर job का complete होना या expiry असंभव होना साबित नहीं होता।
यह rate case setting है, provider entitlement की guarantee नहीं; token/concurrency limits भी लागू हो सकती हैं। मिला हो तो Retry-After मानें। Transient throttling और temporary failure को absolute deadline में retry करें। Permanent auth, invalid payload या exhausted credit पर pause/stop और owner alert करें। Pending/template status स्पष्ट हो। Deadline पर reviewable failure और controlled replay बचाएँ, काम चुपचाप न खोएँ।
Network timeout के बावजूद provider काम पूरा कर सकता है। Stable operation ID, supported idempotency या status reconciliation के बिना side effect न दोहराएँ। Internal allowance केवल confirmed unconsumed reservation पर लौटाएँ; app counter बदलना provider invoice refund नहीं। Billing reservations और completion audit हों। ये design checks हैं, इस ऐतिहासिक system में नई verified implementation नहीं।
Urgent result और optional narrative की सेवा ज़रूरतें अलग हैं। Map में पुराने settings के साथ recommended checks भी हैं।
एक worker exactly-once नहीं देता
एक fixed 4 vCPU/8 GB worker queues, scheduler, WebSockets और SMS सँभालता था; gateway एक outbound IP allow करता था। Snapshot था; reserved-IP recovery, standby worker और exam burst capacity planned थे। Address को आवश्यक outbound egress और provider allowlist सच में support करना चाहिए; assign करना SMS का प्रमाण नहीं।
Worker खोने पर background completion रुकता है। Accepted answer पहले durable authoritative record में हो; केवल Valkey queue से सुरक्षा का वादा न करें। Persistence, acknowledged-work reconciliation और failover replay जाँचें। Safe reservation और idempotent effects हों तो multiple workers सामान्य हैं। एक scheduler या distributed lock crash के बाद exactly-once business effect नहीं सुनिश्चित करता। लागू reservation visibility/retry_after से job timeout कम रखें; वह backoff से अलग है।
Identity सुधारें और evidence बचाएँ
दो limiter layers authenticated छात्र के बजाय IP गिनते थे। 7 October को एक dashboard endpoint की करीब 74% calls 429 थीं; account-and-route keys से उस endpoint को बाद में सुधारा गया। इसका अर्थ सभी abuse limits हटाना नहीं। Account, guest/network और provider protections रखें। Forwarded headers केवल controlled proxies से लें; signed IP भी authorization नहीं।
Backend logs Fluent Bit से OpenSearch जाते थे। Frontend shipping planned थी; करीब 440 MB/day local logs node deletion पर जोखिम में थे। Bounded buffer, delivery monitoring, restricted access और answers/tokens/private data की redaction चाहिए। Off-node का अर्थ instant lossless delivery नहीं।
Exam digest starts/submissions, per-node requests/5xx, CPU, queues और failed jobs देखता था। बीच परीक्षा minimum घटाने से लगभग 360 requests दो मिनट में असफल हुईं। “Exam में scale-in नहीं” runbook guard था, enforced lock नहीं। केवल CPU या zero failed jobs नहीं, oldest-job age और pending outcomes भी देखें। भाग 5 परीक्षण के वास्तविक प्रमाण की समीक्षा करता है।
समीक्षा: 6 नवंबर 2026। Anichur Rahaman, StoreConsole संस्थापक। पुराने observations सुरक्षित हैं; primary sources general behaviour समझाते हैं, private system का नया verification नहीं।



 सॉफ़्टवेयर आर्किटेक्चर

