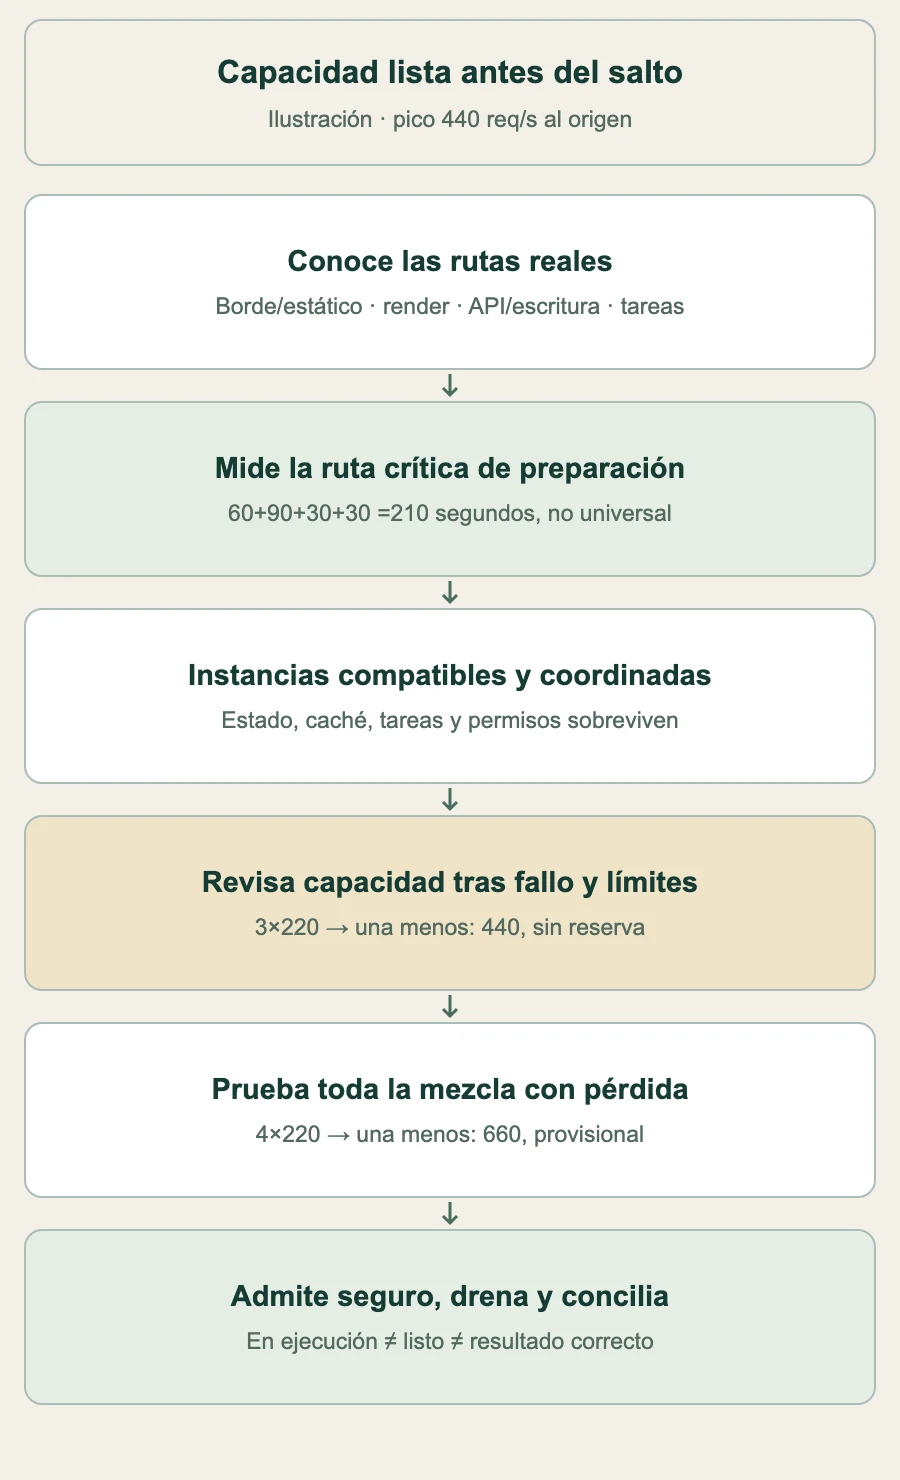
A medianoche empieza una promoción programada. La demanda al origen pasa de 20 a 440 peticiones por segundo mientras el equipo espera nuevas instancias. La máquina arranca, pero descargar la imagen, iniciar la aplicación, registrarla y calentar cachés aún separa “en ejecución” de una compra útil. Es una situación ilustrativa, no un incidente documentado ni benchmark de StoreConsole.
La demanda conocida da tiempo de preparación; no garantiza que añadir máquinas sirva. El plan debe unir llegadas, rutas reales, restricciones compartidas y tiempo hasta estar listo. Esta parte 1 de Engineering for High Volume sigue el recorrido desde el borde hasta la aplicación.
Presupuesta tiempo hasta capacidad útil, no hasta una máquina
El escalado reactivo observa una señal, la evalúa, solicita capacidad, inicia el trabajo y admite tráfico. Grupos calientes o procesos ligeros responden rápido; imágenes grandes, cuotas y dependencias frías pueden tardar. No existe un mínimo universal de uno a tres minutos ni un cooldown para toda política.
AWS distingue escalado por pasos/simple y calentamiento. Lee política real, periodo de métricas, evaluación y reducción. Un valor del escalado simple no impone espera a todo aumento con seguimiento de objetivos. Mide tu ruta crítica, incluidos aprovisionamiento fallido y preparación.
Solo como planificación, supón etapas consecutivas de detección/control 60 segundos, aprovisionamiento 90, registro/salud 30 y calentamiento 30:210 segundos, 3 minutos 30 segundos. Pueden solaparse en realidad. Programa capacidad con antelación suficiente para el caso lento observado y margen justificado; contar máquinas activas no demuestra preparación.
Etapa consecutiva ilustrativa
Segundos
Segundos acumulados
Detección/control
60
60
Aprovisionamiento
90
150
Registro/salud
30
180
Calentamiento
30
210
Para eventos conocidos combina preparación programada/predictiva con reglas reactivas para variación restante y máximos de gasto/capacidad. Preescalar cuesta y también puede fallar. Verifica cuotas, disponibilidad y dependencias; conserva admisión controlada o una espera honesta para demanda superior a la probada.
Dibuja las rutas que realmente llegan al origen
Separa recursos estáticos cacheados, páginas públicas, render dinámico, API, escrituras de checkout y tareas. Peticiones al borde, al origen, usuarios y pedidos son unidades diferentes. Una página Next.js puede llamar una API; un monolito puede usar SSR interno; otras APIs no pasan por SSR. No fuerces todo por una cadena ficticia.
Cachea recursos inmutables y respuestas realmente compartibles con política explícita de host/idioma/variante. Cuentas personales, carritos, contenido según permisos y respuestas que crean sesión necesitan bypass o tratamiento privado. Parecer público no prueba ausencia de personalización. Prueba caché fría/caliente, invalidación, avalanchas de regeneración y aciertos reales.
WAF, control de tasa y balanceador también tienen límites de conexiones, TLS, ancho de banda, registro, cuotas y salud. Gestionado no significa ilimitado ni incapaz de ser cuello. La reserva de capacidad de AWS ALB es una opción específica para eventos; estímala y verifícala con tu carga, sin repetir antiguas cifras de duplicación.
Una sonda solo demuestra lo que prueba. Usa preparación consciente de dependencias y recorridos reales, evitando que una dependencia compartida caída retire todos los nodos aún útiles. Ensaya drenaje, propagación y periodos de gracia; drenar reduce interrupciones, pero no garantiza escalado invisible ni repara peticiones ya fallidas.
Instancias intercambiables sin perder el estado
Sesiones, cargas de archivos, propiedad de trabajos, bloqueos y estado comercial deben sobrevivir a una instancia. Pueden servir almacenes compartidos de sesión/base de datos y archivos duraderos compartidos u objetos. Redis/S 3 son opciones, no obligaciones universales. Una caché local inmutable puede ser válida; coordinación e invalidación tienen necesidades distintas de una caché local prescindible.
La guía de autoalojamiento de Next.js trata coordinación de caché y versiones entre instancias. Despliega artefactos compatibles y coordina invalidación, identidad/secretos y archivos generados. Un almacén compartido no demuestra que todos los tipos, etiquetas y versiones en vuelo sean seguros.
Coordina tareas programadas y evita efectos comerciales duplicados. La documentación del scheduler de Laravel describe exclusión con bloqueo atómico compartido. Aun así prueba bloqueo, vencimiento/failover e identidad de operación; cron en un nodo no es un diseño completo de exactamente una ejecución.
Alinea límites de cuerpo/tiempo y cargas en la ruta proxy/aplicación real, no en servicios imaginarios. La caída de nodo no debe perder un archivo aceptado o resultado de pago. La autoridad comprueba entidad/registro en el servicio responsable; escalar no concede permisos.
Mide SSR y FPM como cargas, no promedios de CPU del host
JavaScript intensivo en CPU puede saturar un event loop de Node mientras otros núcleos quedan libres. No significa que el proceso nunca use otros: trabajo nativo, runtime y worker threads cambian el caso. Mide CPU por proceso, retraso del loop, memoria/GC, E/S y esperas al backend antes de añadir procesos, cambiar render/caché u optimizar código.
Los ajustes oficiales de PHP-FPM limitan concurrencia y ciclo de vida. En otro ejemplo estable, 200 peticiones/segundo comienzan ejecución y ocupan un worker una media de 0.15 segundos: unos 30 workers ocupados de media. No prescribe 60 procesos, núcleos o conexiones; p95 no sustituye a la media.
Con presupuesto ilustrativo incremental/privado de 100 MiB por worker, 60 necesitan 6,000 MiB≈5.86 GiB antes de sistema operativo, otros servicios y memoria compartida. No sumes OPcache compartida como privada repetida. Mide picos y límites de conexiones/CPU aguas abajo; más concurrencia FPM puede saturar la base en lugar de aumentar trabajo útil.
Prepara modo de procesos y cachés con peticiones seguras representativas. Desactivar comprobaciones de fecha en OPcache exige refrescar procesos que sirven tras el despliegue; una opción copiada o reset desde CLI no garantiza seguridad. Procesos y contenedores también pueden arrancar/calentar lentamente: demuestra los segundos de reacción.
Cuenta capacidad después del fallo y prueba el techo compartido
Solo para esta tabla supón que cada instancia comparable sostiene 220 peticiones/segundo al origen para la mezcla y objetivo elegidos. Pico 440. Multiplicar es presupuesto provisional, no escalado lineal medido. Se pierde una instancia, no un host o zona completos.
Tres dan 660 nominales; tras perder una, 440:justo el pico, sin reserva. Cuatro dan 880 y quedan 660,1.5 veces el objetivo. Cuatro en una máquina no son cuatro dominios independientes. Prueba la pérdida real de host/zona que quieras tolerar.
Instancias
req/s nominales
req/s tras perder una
Frente al pico 440
2
440
220
Quedan 220, por debajo del pico
3
660
440
440 iguala pico, sin reserva
4
880
660
660 con margen provisional
Escrituras, conexiones, contención de caché/bloqueos, cuotas de pagos/logística, red y tareas pueden limitar antes todo el sistema. No resuelvas una capa inundando otra. Usa contrapresión, trabajo limitado y responsabilidad; los diferidos también necesitan frescura y presupuesto de recuperación.
NGINX least_conn elige por conexiones activas y pesos, no conoce todo costo comercial. Menor número de peticiones pendientes no es el mismo algoritmo. Conexiones largas, multiplexación, mezcla y límites afectan la elección. Compara con tu carga; round robin no es automáticamente erróneo.
Mapa de preparación y aceptación, no garantía de rendimiento. Tiempo, supervivientes y dependencias deben pasar la mezcla real.
Controla la carga conservando los resultados
Reintentar upstream puede repetir un efecto cuya respuesta se perdió. Las reglas de reintento de NGINX delimitan otro intento; método y proxy no sustituyen idempotencia de aplicación. No conviertas fallos de pago en reintentos indiscriminados de POST. Conserva identidad duradera, consulta resultados desconocidos y limita reintentos permitidos con backoff/jitter, edad/intentos y responsable.
Aplica admisión/tasa donde preserve la promesa, con estado comprensible y regreso seguro. Evita colas ilimitadas que ejecuten después de decir al cliente que falló. La antigüedad debe medir trabajo listo elegible, no tareas futuras intencionadas. Distingue pedidos aceptados/pendientes/terminados, reservas, pago capturado y entrega.
Reduce cuando llegadas, trabajo activo, pendientes de recuperación y mínimo para fallos lo permitan. Drena y supervisa terminación; espera o recupera con seguridad el trabajo propio y conserva conciliación. Terminar el evento en un reloj no termina obligaciones de pago y entrega.
Ensaya llegadas y libera capacidad con evidencia
Antes de probar define éxito comercial, límites de error/timeout y latencia. Incluye navegación, búsqueda, variantes, carrito, acceso y checkout autorizado en proporciones reales, con fallos de caché y reintentos. Aísla efectos externos para no cobrar clientes ni enviar paquetes en un ensayo.
k6 distingue modelos abiertos y cerrados. Para un salto de llegadas, evita que respuestas lentas reduzcan silenciosamente la demanda ofrecida. Una iteración puede tener varias peticiones; mira tasas reales enviadas/completadas, iteraciones descartadas y capacidad del generador, no solo usuarios configurados.
Prueba salto objetivo, pico sostenido, escenario mayor justificado, frío/revalidación, pérdida de instancia y reducción segura. Recoge colas de latencia, resultados comerciales, admitidos/rechazados y esperas por capa. Detén según límites acordados y vía de operador; un guardián de CPU no detecta cobros duplicados. Cambia una restricción material y repite el escenario pertinente.
El equipo preparado del ejemplo puede mostrar quién está listo antes de medianoche, qué queda tras fallar y cómo trata sobrecarga. Solo una prueba integrada dice si la mezcla de 440 cumple el objetivo. Pide al proveedor, incluido StoreConsole, evidencias de la versión, módulos y despliegue ofrecidos.
Revisado el 5 de noviembre de 2026. Anichur Rahaman, creador de StoreConsole. Tráfico, tiempos, memoria y capacidad son ejemplos de planificación, no pruebas realizadas ni rendimiento garantizado.


 Arquitectura de software

