Un examen empieza a una hora fija. Los estudiantes llegan juntos y la plataforma debe aceptar sus respuestas mientras corre el reloj. Comprar un servidor más grande no responde a las preguntas importantes: ¿qué ocurre si falla un nodo, se ralentiza un servicio compartido o un despliegue interrumpe una solicitud?
Esta serie de cinco partes sigue la preparación de una plataforma de cursos y exámenes para un pico programado. La primera parte explica cómo identificamos los riesgos antes de elegir infraestructura.
Sobre el caso: NovaCommerce es un nombre ficticio para anonimizar un proyecto real. Las configuraciones y mediciones proceden de los registros de septiembre y octubre de 2026. Describen esa plataforma y esa carga; no son un benchmark de Store Console. Las explicaciones técnicas generales se revisaron el 3 de noviembre de 2026.
Empezar por el evento de negocio
El tráfico medio diario no describía el momento difícil: el minuto de apertura, cuando muchos estudiantes cargaban preguntas, comprobaban su sesión y comenzaban a la vez. Lo convertimos en cuatro requisitos:
Estar preparados antes del inicio. La capacidad debe estar operativa cuando llegue el público.
Proteger las entregas confirmadas. Definir cuándo una respuesta queda guardada de forma duradera y cómo evitar duplicados al reintentar.
No interrumpir el trabajo activo. Los despliegues y la retirada de nodos necesitan comprobaciones de salud y drenaje de solicitudes.
Poder explicar el gasto. Cada recurso recurrente debe cubrir una necesidad medida o un fallo definido.
Eran requisitos, no afirmaciones de que todos los escenarios de fallo ya se hubieran probado.
La arquitectura original y sus puntos débiles
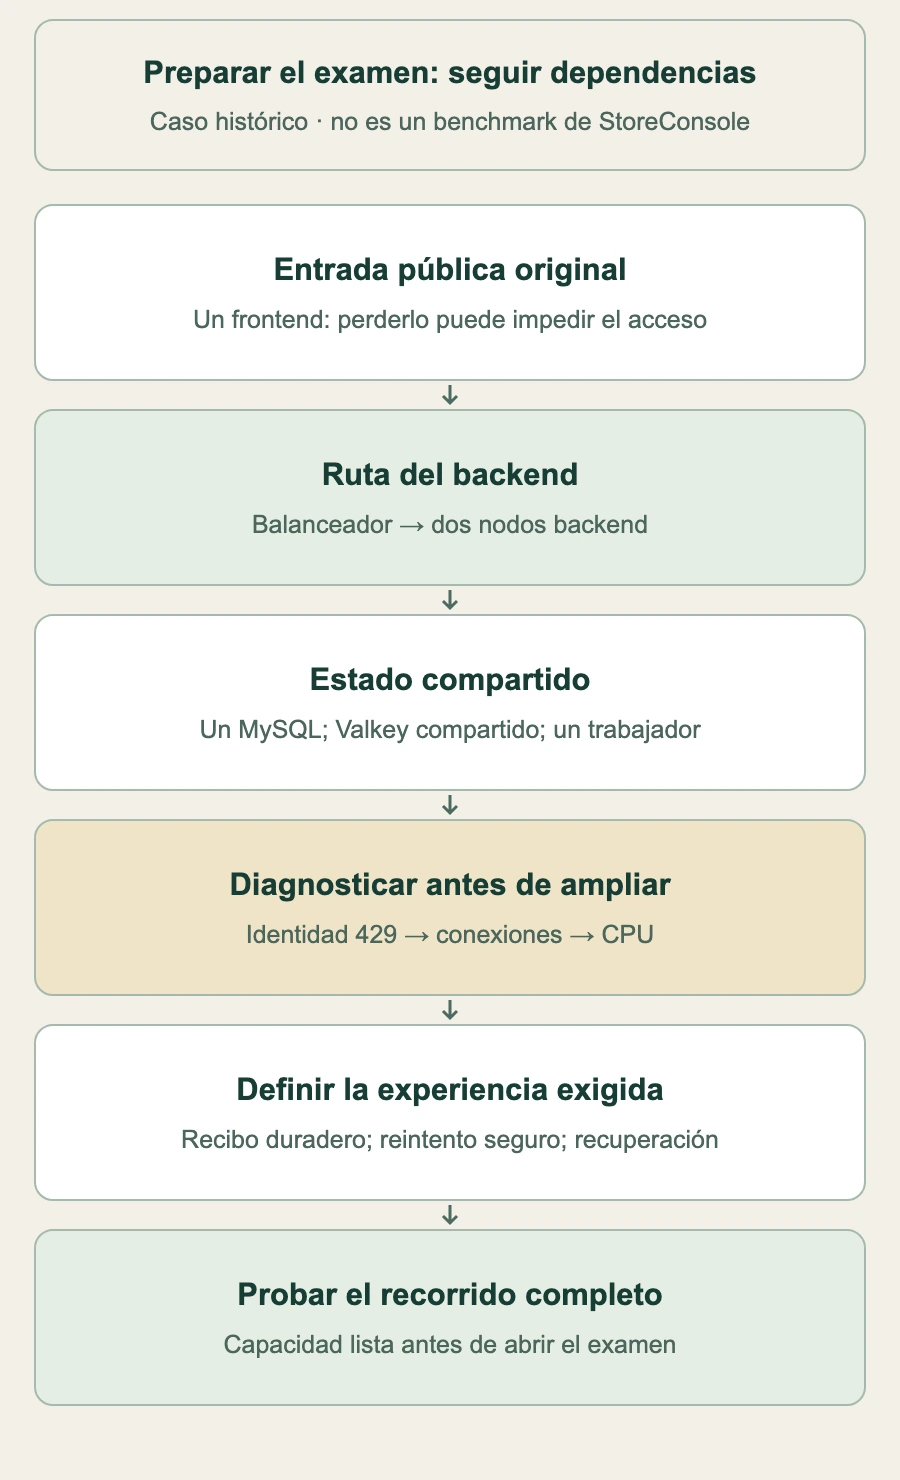
Puntos de fallo originales y evidencia necesaria antes del examen. Mapa didáctico del caso histórico, sin garantía de disponibilidad.
El frontend ejecutaba un contenedor Next.js en un Droplet de 8 vCPU y 16 GB, sin balanceador delante. Su pérdida podía dejar la web pública inaccesible. Dos nodos backend de 4 vCPU y 8 GB servían Laravel mediante nginx y PHP-FPM. Las tareas de fondo, el planificador y WebSockets se ejecutaban en un worker separado.
El balanceador del backend apuntaba a identificadores fijos de Droplets. Un servidor nuevo tenía que registrarse: esa configuración no descubría automáticamente la nueva capacidad. Sesiones, caché y colas ya estaban en Valkey administrado, lo que facilitaba sustituir nodos web.
MySQL tenía un único nodo administrado de 8 vCPU y 32 GB, sin standby configurado. El proveedor puede reemplazar un nodo averiado; eso no equivale a tener una réplica preparada para asumir el papel de primario. El único worker también era un punto de fallo para el trabajo asíncrono.
Otros dos Droplets estaban apagados como recursos de recuperación. Podían formar parte de un procedimiento de recuperación, pero no servían tráfico ni proporcionaban conmutación automática.
Matiz sobre Node.js: un único bucle de eventos JavaScript puede limitar el renderizado intensivo en CPU. Sin embargo, Node.js también utiliza un pool de workers y operaciones nativas. Un contenedor no demuestra que siete de ocho núcleos estuvieran ociosos. El número de procesos debe decidirse con perfiles y pruebas de carga.
Definir la disponibilidad mediante pruebas
En lugar de llamar “altamente disponible” a toda la plataforma, definimos qué debía experimentar una persona ante cada fallo:
Fallo de un nodo web: los nodos sanos siguen sirviendo y el averiado deja de recibir tráfico nuevo.
Fallo de base de datos: existe un procedimiento documentado de recuperación y la aplicación gestiona desconexiones transitorias.
Despliegue: el reemplazo está listo antes de retirar el nodo anterior; las solicitudes activas tienen tiempo para terminar.
Pico programado: la capacidad está sana antes del evento y dispone de margen para un reparto desigual.
Disponibilidad y durabilidad requieren pruebas distintas. Los nodos web sin estado facilitan la sustitución, pero no garantizan que una respuesta sobreviva. También importan los commits de base de datos, la replicación, la persistencia, los reintentos sin duplicados, las copias y las pruebas de recuperación. Una arquitectura en una sola región no demuestra recuperación ante la caída de esa región.
Tres hallazgos, tres respuestas
1. HTTP 429: se contaba la identidad equivocada
El 25 de septiembre, estudiantes de una misma red escolar o de operador recibían “demasiadas solicitudes”. El limitador usaba la IP porque no se resolvía correctamente la identidad autenticada. Muchas personas compartían así una sola cuota.
La corrección aplicó el límite a la cuenta del estudiante o instructor y conservó la IP como alternativa para invitados. Más servidores no habrían cambiado esa regla. Los límites por identidad siguen necesitando protección contra abusos; no justifican quitar el control de frecuencia.
2. Timeouts de Valkey: fallaba una dependencia compartida
La prueba del 6 de octubre registró 2.854 errores de aplicación por timeouts de conexión a Valkey. Los registros describen el coste de abrir conexiones TLS nuevas y el cambio de una configuración de primario y standby de 4 GB a 8 GB por nodo.
Después, una subida gradual de 25 a 500 solicitudes/segundo informó de cero errores de aplicación, pero 143 errores del balanceador mientras se saturaba la CPU del backend. Ese ensayo indica que se eliminó el fallo de timeout de aplicación; no demuestra éxito de extremo a extremo a la carga máxima. Seguían fallando solicitudes.
Un timeout no demuestra por sí solo falta de memoria. En otro sistema habría que investigar rotación de conexiones, límites, red y métricas del servicio antes de contratar un plan mayor.
3. CPU del backend: el siguiente límite
Con la mezcla de API probada, un nodo backend de 4 vCPU alcanzó aproximadamente 65–70 solicitudes/segundo con la CPU al máximo. Es un punto de saturación observado, no un objetivo operativo seguro ni un benchmark trasladable. Tanto reducir trabajo de CPU como añadir capacidad son opciones que evaluar.
En una prueba, el primer nodo adicional llegó unos siete minutos después de que la CPU alcanzara el 99 %. Ese retraso pertenecía a esta configuración. Para un examen programado, la respuesta práctica fue ampliar antes y verificar la preparación antes del inicio.
Comparar costes con el mismo alcance
El presupuesto histórico situaba la capa web en unos 416 USD/mes, incluidos 112 USD/mes por los Droplets apagados. Son cifras de septiembre y octubre de 2026; excluyen bases de datos, Valkey y almacenamiento. No deben compararse directamente con una factura posterior de toda la plataforma.
DigitalOcean sigue cobrando los Droplets de CPU reservados aunque estén apagados. El valor de esa capacidad fría depende del tiempo de recuperación que realmente ofrezca: qué fallo cubre, cuánto tarda en ayudar y cuándo se probó por última vez.
Los planes cambian. La documentación actual anuncia restricciones de PostgreSQL y MySQL Standard Edition desde el 15 de octubre de 2026 para cuentas que nunca hayan creado un clúster PostgreSQL o MySQL y el 30 de noviembre de 2026 para todas las cuentas. Compruebe precios y elegibilidad actuales antes de reproducir una configuración histórica.
Repetir la revisión antes del próximo pico
Para un examen, lanzamiento o aumento de compras, dibuje el recorrido crítico de una solicitud e identifique las dependencias compartidas. Defina qué sucede cuando fallan. Pruebe la carga prevista y mida respuestas correctas, latencia de las solicitudes más lentas y errores a lo largo de todo el recorrido. Cambie la capa que señale la evidencia y repita la prueba.
Revisión: 6 de noviembre de 2026. Aceptar una respuesta exige definir un recibo de guardado duradero, un identificador de operación y un reintento idempotente. El trabajo en cola no debe ser la única copia. Un nodo de reserva, una copia de seguridad y una restauración probada resuelven problemas distintos; ninguno demuestra por sí solo pérdida de datos nula. Conservamos los recuentos históricos del caso existente; esta revisión editorial no los ha vuelto a medir de forma independiente.



 Arquitectura de software

