Checkout atascado, CPU tranquila: encuentra el trabajo pendiente
Un gráfico verde puede ocultar pedidos retrasados. Conecta resultados de negocio con métricas, logs protegidos y trazas; cada alerta necesita acción y responsable.
«El checkout está atascado», comunica soporte a las 10:01. CPU al 40% y la página de inicio abre. En esta escena didáctica, no importa tanto el servidor verde: ¿recibe el cliente el resultado correcto y dónde espera el trabajo pendiente?
La parte 4 de Ingeniería para alto volumen construye una cadena pequeña: resultado de negocio, señal agregada, operación concreta y respuesta controlada. No afirma un incidente real, benchmark personal ni plazo garantizado de diagnóstico.
Define éxito antes de medirlo
HTTP 200, job completado o página de pago abierta no prueban un pedido pagado. Define operación elegible, resultado correcto, límite temporal y exclusiones. Un SLI propuesto podría exigir resultado exacto o recibo pendiente durable en 2 segundos. Pago/fulfillment necesitan objetivos de frescura separados; de otro modo “pendiente” puede seguir verde indefinidamente.
En el cálculo, supón objetivo 99% de eventos buenos en 30 días y previsión de 3,000,000 intentos elegibles. Malo es la unión de resultados incorrectos, fallidos o lentos: cuenta cada intento una vez aunque falle y tarde. Son hipótesis didácticas, no SLO medido de StoreConsole.
Cálculo didáctico
Resultado
Intentos elegibles previstos /30 días
3,000,000
Fracción mala permitida: 1−99%
1%
Presupuesto malo previsto
30,000
Pico: 440×600
264,000
Eventos malos: 264,000×2%
5,280
Presupuesto previsto consumido: 5,280÷30,000
17.6%
A 440 intentos/s durante 10 minutos llegan 264,000 intentos. Si 2% son malos, 5,280 consumen 17.6% del presupuesto previsto 30,000. La tasa mala es 2× el 1% permitido; convertirla en tiempo hasta agotar exige asumir tráfico. La guía SLO de Google fundamenta alertas por impacto y varias ventanas.2% fijo no es umbral universal para despertar a alguien: importan volumen, riesgo y urgencia.
Une señales sin confundir identidades
Las señales OpenTelemetry conectan métricas agregadas, eventos y trazas por spans. Añade las cuatro señales doradas—latencia, tráfico, errores y saturación—a la finalización real del negocio. Observa esperas de pool/locks, edad de trabajo listo elegible, obligación sin resolver más antigua, disco y memoria. Un job programado para el futuro no está ya retrasado.
Evidencia
Pregunta
Límite
Contador de resultados
¿Resultado correcto a tiempo?
Elegibilidad; una cuenta por intento
Log estructurado
¿Qué pasó a esta operación/intento?
Acceso acotado; mínimos campos sensibles
Traza
¿Dónde fue el tiempo instrumentado?
Cobertura, solapamiento y muestreo
Auditoría/conciliación
¿Qué efecto durable existe?
Autoridad, retención y recuperación propias
Request ID identifica una solicitud; trace ID enlaza instrumentación; la operación de negocio conserva identidad en reintentos relevantes y cada intento se distingue. Un job posterior puede tener traza enlazada. W 3 C Trace Context define propagación, no autenticación. Valida/limita IDs entrantes no fiables, genera correlación interna segura cuando proceda y no envíes contexto sensible indiscriminadamente a socios.
Un span evidencia tiempo instrumentado, no causa raíz automática. Spans anidados/paralelos se solapan; sumarlos todos duplica duración. Normaliza marcas/unidades, mide bien y marca despliegues/cambios. Una release cercana es hipótesis, no prueba de rollback seguro.
Mide distribuciones de latencia, poblaciones de éxito/fallo, conteos y tasas. La media ayuda a planificar capacidad pero oculta colas largas. La guía de histogramas Prometheus explica agregación: promediar p95 de nodos no da p95 del conjunto. Usa distribuciones/buckets compatibles u otro método correcto con ventanas conocidas.
Recoge evidencia sin crear otro incidente
Logs estructurados: fecha, servicio/entorno/release, ruta normalizada, resultado/motivo, duración/unidad y correlación acotada necesaria. Una ruta sin query también puede contener datos personales. IDs internos siguen siendo sensibles; minimiza y restringe. La guía OWASP de logging cubre secretos, acceso, integridad, retención e inyección. No copies tarjetas, contraseñas, tokens ni documentos de clientes.
IDs de solicitud/pedido/usuario, cuando sean necesarios, van en contexto consultable protegido, no en dimensiones ilimitadas. La guía de etiquetas Prometheus advierte sobre cardinalidad; la de Loki diferencia etiquetas de streams y campos detallados. Un customer ID por etiqueta puede agotar un backend pequeño incluso con tráfico moderado.
Define retención por finalidad y requisitos, incluyendo borrado y conservación legal. Dimensiona ingesta, índices, consultas y recuperación con volumen medido: no hay nodo universal 2 GB ni retención universal 30 días. Vigila pérdidas, exportadores, buffers, disco y entrega de alertas. Limita backoff/reintentos/buffers para no bloquear checkout por fallos de telemetría. La evidencia de auditoría durable requerida tiene política propia, no descarte/muestreo silencioso.
La guía de muestreo OpenTelemetry distingue decisión inicial head y posterior tail. Head no asegura guardar todo error futuro. Tail puede priorizar errores/lentitud, pero necesita capacidad, espera y routing consistente; no recupera spans descartados antes. Registra pérdidas/cobertura y conserva contadores de resultados sin muestreo adecuados al SLI. Verifica SDK/instrumentación concreta, no una supuesta estabilidad universal.
Convierte una alerta en una decisión acotada
La primera pantalla muestra volumen bueno/malo y latencia del recorrido crítico; después pendientes y límites, con detalle por ámbito. Debe leerse en los dispositivos de guardia. Comprobaciones externas/sintéticas y proveedor complementan métricas internas; falta de telemetría no significa cero errores.
Una llamada necesita responsable, alcance, evidencia, runbook y escalado. Combina ventanas cortas/largas, tráfico mínimo cuando proceda y gravedad. Seguridad, corrupción o capacidad a punto de fallar pueden requerir acción antes de subir errores de usuario. Un descuadre monetario con poco tráfico puede ser más urgente que CPU ruidosa.
Verifica servicio/estado de negocio, conserva evidencia y elige mitigación reversible. No reinicies automáticamente la base ni reviertas toda release de los últimos 15 minutos. Comprueba compatibilidad esquema/API, pagos en curso y trabajo aceptado. Ante resultado externo desconocido consulta la referencia original antes de repetir dinero. Después concilia resultados y pendientes; un gráfico que baja no cierra el incidente.
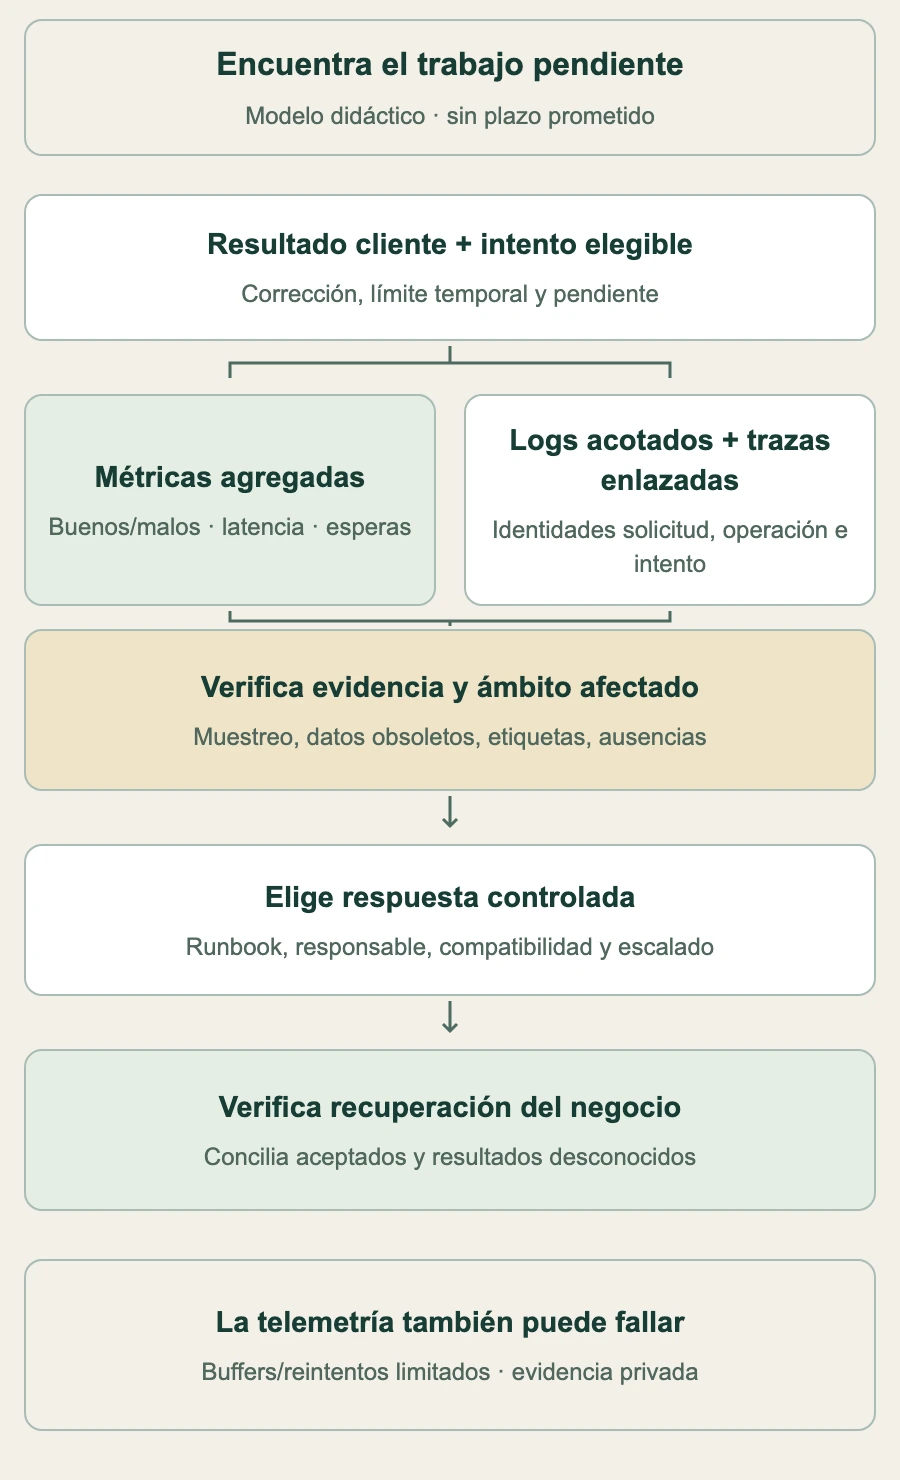
Flujo didáctico. La correlación acota hipótesis; registro durable y permisos actuales determinan la acción segura.
Ensaya la investigación y el fallo del monitoreo
En prueba aislada o explícitamente controlada, ejercita mezcla representativa, caché fría y dependencias. Documenta trabajo ofrecido/completado, límites del generador, ámbito y condiciones de parada. Un guard de CPU no garantiza evitar caídas. Gráficos de proveedor/app difieren por ventanas, denominadores, unidades o alcance; concilia definiciones antes de declarar uno incorrecto.
Inyecta dependencia lenta, enqueue fallido, callback tardío y exportador caído. Comprueba llegada de alerta al responsable y que el registro enlazado explica pendientes sin revelar otra entidad. Guarda resultados, decisiones y límites con el cambio. A las 10:01, la evidencia debe acotar la espera y proteger recuperación, no prometer clientes satisfechos por una CPU tranquila.
Revisado el 6 de noviembre de 2026. Anichur Rahaman, creador de StoreConsole. SLO, tráfico y presupuesto son ejemplos didácticos, no resultados medidos.


 Arquitectura de software

