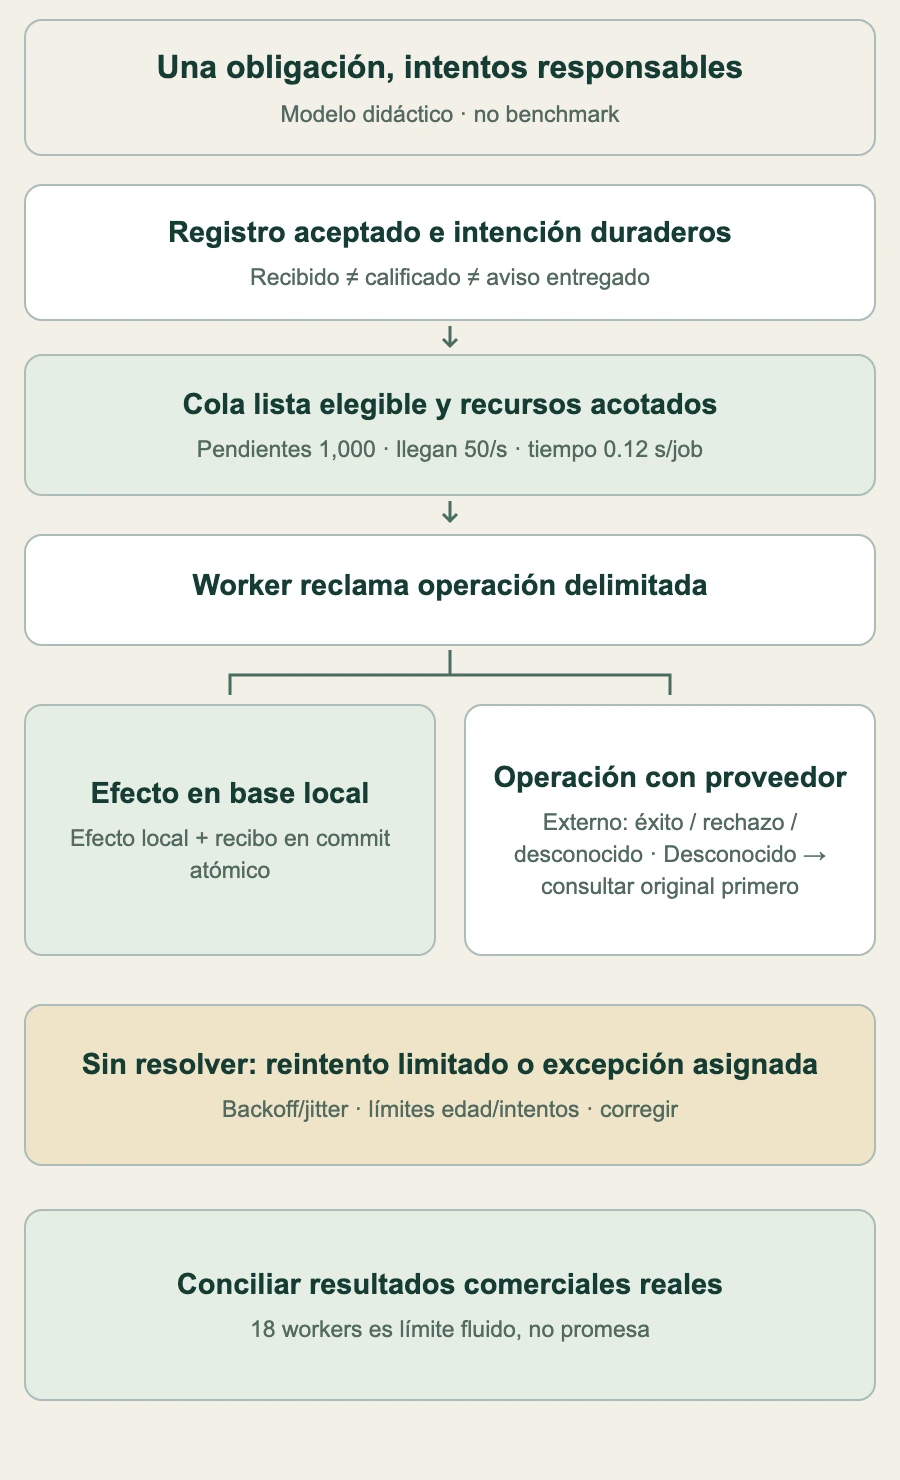
A las 9:00 una plataforma de exámenes ha aceptado de forma duradera 1,000 respuestas, pero aún falta calificarlas. El alumno debe ver “recibida; calificación pendiente”, no un resultado inventado. Este ejemplo también describe generar una factura ERP o una etiqueta de envío: aceptar la solicitud y completar la obligación son hechos distintos.
La cola absorbe llegadas desiguales; no crea capacidad ni demuestra que terminó la acción comercial. Esta parte 2 de Engineering for High Volume sigue la obligación desde su registro autoritativo hasta workers limitados, un resultado externo incierto y su recuperación. No afirma pruebas personales ni resultados de clientes.
Conserva el hecho aceptado antes de prometer éxito
La respuesta validada debe sobrevivir antes de decir recibida. No dejes la única copia de una respuesta, pedido o aprobación en una cola prescindible. Registra qué se aceptó, quién lo autorizó y qué falta; calificación, notificación y entrega externa tienen estados distintos.
La documentación de colas de Laravel explica despachar después del commit: evita leer datos sin confirmar o ejecutar trabajo cuya transacción se revirtió. Si confirmar el registro y publicar en otra cola son escrituras separadas, un fallo después del commit todavía puede dejarlo sin mensaje.
Para obligaciones críticas usa un diseño atómico apropiado de cola/base de datos o un outbox transaccional que guarde intención de publicar con el cambio propio. Un relay recuperable la publica. Duplicados, retención y fallos operativos siguen necesitando control; after commit por sí solo no garantiza ausencia de pérdidas.
Separa clases de servicio y reserva recursos
Define un objetivo de finalización/frescura por trabajo. Respuestas, conciliación de pagos, notificaciones, imágenes e informes tienen urgencias, costos y fallos diferentes. Colas separadas ayudan a enrutar; no reservan por sí solas CPU, memoria, base de datos o cuota de proveedor.
Asigna presupuestos explícitos de supervisor/pool cuando haga falta capacidad independiente. Un worker que mira primero una cola alta aún ejecuta un job a la vez y puede dejar sin servicio las siguientes. Capacidad dedicada no interrumpe un job largo en ejecución, y trabajo menor puede seguir compitiendo por la misma base.
Separar cómputo web y workers protege presupuestos en ciertos casos. Contenedores/cgroups o nodos separados pueden ser apropiados. Base, caché y red compartidas aún afectan a ambos: mover workers no promete que las páginas nunca sufran.
Cuenta llegadas además de la acumulación
Supón acumulación lista instantánea B=1,000 jobs y ocupación media s=0.12 segundos/job, incluida E/S pertinente. Hay 120 worker-segundos de trabajo. Sin nuevas llegadas, 12 workers perfectamente equilibrados dan límite fluido inferior 10 segundos. Incluso jobs idénticos indivisibles requieren 84 ondas×0.12=10.08 segundos; despacho, variación, reintentos y contención añaden tiempo.
Ahora siguen llegando 50 jobs listos/segundo. Con w workers, rendimiento ideal w÷0.12; la acumulación solo baja si supera 50. Tiempo ideal B÷(w÷s−50). Es un modelo de planificación, no benchmark ni garantía de plazo.
Para vaciar en 10 segundos con esas llegadas, el límite fluido es w≥s×(50+B÷10)=18. Añade margen probado por variabilidad, fallos y dependencias. Dividir cantidad de jobs por tiempo de ejecución no da directamente número de workers: importan unidades y horizonte.
Workers
Rendimiento ideal jobs/s
Reducción neta jobs/s
Vaciado fluido de 1,000
6
50
0
No reduce acumulación
12
100
50
20 segundos
18
150
100
10 segundos
Añadir workers acaba encontrando un límite compartido. Mide finalizaciones útiles, edad del listo elegible más antiguo, distribución de ocupación, esperas de base/bloqueo y límites externos. Una cola lista corta puede ocultar muchos reservados/atascados; trabajo futuro retrasado no debe inflar su alerta.
Escala procesos o réplicas según tu despliegue
La guía actual de Horizon para Laravel 13 distingue reparto simple de procesos, auto y false con orden de colas, que puede seguir escalando procesos. Auto no da prioridad estricta por orden del array. Comprueba la versión instalada, sin tratar false como interruptor universal de pool fijo.
Horizon supervisa workers Redis; la documentación actual excluye Redis Cluster. Puede ejecutarse en varios nodos, pero no los provisiona. Suma mínimos, máximos y recursos entre colas, supervisores y réplicas. El límite de un supervisor no se convierte automáticamente en límite global.
KEDA 2.21 aporta escalado por eventos alrededor de cargas Kubernetes, con HPA cambiando réplicas. Cómputo disponible, frescura/polling, activación, imagen, preparación y reducción determinan reacción. Ni pods ni procesos tienen segundos/minutos universales, ni eliminan costos de recursos/operación.
Elige métricas del driver real. Longitud de lista Redis puede ver listos y omitir reservados/diferidos. Prepara un mínimo justificado para un pico conocido y limita capacidad reactiva a lo probado. No dejes dos lazos pelearse.
Timeout, vencimiento de reserva y backoff son relojes distintos
Presupuesto hipotético Horizon/Redis: llamada externa 10 segundos, job 45, supervisor 60, retry_after de conexión 90. No son ajustes entregados. El timeout Horizon debe superar el del job y quedar suficientemente antes de retry_after; prueba driver, extensiones y terminación reales.
retry_after no es espera entre reintentos de aplicación. Marca cuándo un reservado puede volver a ser elegible si no se completó/liberó correctamente. Si otro worker lo recibe mientras el primero sigue, puede duplicar efectos. SQS y otros drivers tienen sus contratos de visibilidad.
Límite ilustrativo
Segundos
Propósito
Llamada externa
10
Acota la llamada
Timeout del job
45
Acota una ejecución
Timeout del supervisor Horizon
60
Mayor que job; menor que vencimiento
Redis retry_after
90
Elegibilidad reservada, no backoff
Fija límites de intentos/edad total, comportamiento de excepciones/liberación y backoff/jitter pertinente. Datos o permisos inválidos necesitan corrección, no intentos infinitos. El almacén de fallos necesita alerta, responsable y ruta revisada de reintentar/cancelar. Una fila no recupera trabajo. Algunas liberaciones de middleware consumen intentos: comprueba semántica real.
Haz seguro el duplicado en el límite del efecto
Comprobar ya hecho al principio puede competir con otro worker o fallar antes de guardar el recibo. Para efecto local, reclama operación única delimitada, aplica cambio y guarda resultado en una transacción atómica. Unicidad de cola o bloqueo de solapamiento no demuestran un solo pago/correo externo.
En llamadas externas conserva referencia comercial duradera e idempotencia/consulta admitida. El contrato de Stripe ilustra alcance, parámetros y retención de claves. Si el resultado es desconocido consulta/concilia el original antes de otro; una clave nueva puede producir otro cargo.
Si falló el PDF de una factura pagada, recupera documento, no cobro. Petición de correo aceptada no prueba entrega en bandeja. Separa intento, resultado del proveedor y conclusión comercial; al repetir respeta estado autorizado y no borres todas las claves.
La cola transporta obligaciones. Cada intento conserva la operación y mantiene visible el resultado externo desconocido.
Presupuesta memoria, privacidad y recuperación del despliegue
Incluye runtime residente, memoria retenida, picos de jobs y base compartida/contenedor. Ejemplo: 10 workers×128 MiB privados/incrementales=1,280 MiB=1.25 GiB antes de otros costos/margen. No prueba que 2 GiB basten. Suma cada pool con su presupuesto y prueba picos coexistentes.
Streaming/chunks pueden reducir memoria, pero bibliotecas aún almacenan y dividir cambia orden/recuperación. Mide antes/después en vez de inventar ahorro 288→128 MiB. Recicla procesos largos cuando proceda; más RAM/workers sin evidencia puede dejar intacto el límite.
Transporta datos mínimos delimitados: un ID no autoriza acceso permanente. Revalida autoridad/estado en el dueño. Protege transporte, almacén, payloads, fallos, paneles y exportaciones. Cifrar payload no protege todos los metadatos/logs. OWASP sobre logging orienta evidencia útil sin volcar secretos ni documentos salariales/personales.
Despliega código/esquema/payload compatible y sustituye workers supervisados con salida ordenada. No hace falta vaciar toda cola. Deja terminar o recupera con límites de terminación/visibilidad probados; conserva compatibilidad mientras haya trabajo antiguo. Arrancar el scheduler al final no corrige por sí solo jobs incompatibles ni duplicación.
Opera la cola como obligaciones visibles
La guía del scheduler de Laravel permite coordinación mediante bloqueos atómicos compartidos: un nodo cron fijo no es la única topología. Prueba vencimiento, solapamiento, failover y ejecuciones perdidas con idempotencia comercial. Un relay periódico puede ser válido; un proceso permanente no cura universalmente presión de memoria.
Ensaya caída antes/después de commit, fallo de publicación, duplicado concurrente, timeout desconocido, payload incorrecto, acceso revocado, pico pesado y despliegue a mitad de job. Aísla cobros/mensajes reales. Concilia obligaciones y efectos con mismo ámbito/periodo/estado, no solo profundidad cero.
El panel útil de las 9:00 distingue respuestas recibidas, calificación pendiente/terminada, avisos aceptados/confirmados y excepciones asignadas. El plazo exacto exige prueba integrada. Pide al proveedor, incluido StoreConsole, demostrar ruta, permisos y recuperación limitada en versión/módulos ofrecidos.
Revisado el 5 de noviembre de 2026. Anichur Rahaman, creador de StoreConsole. Respuestas, capacidad, tiempos y memoria son ejemplos, no benchmarks de clientes ni garantía del software instalado.


 Arquitectura de software

