Escalar comercio autohospedado: de pedidos diarios a capacidad probada
100,000 pedidos diarios son una meta comercial, no una especificación de servidor. Calcula picos, elimina el cuello de botella medido y prueba los fallos.
Autor
Anichur Rahaman
hace 3 meses8 min de lectura145 vistas
Los pedidos diarios se duplican y el dueño pide un servidor dos veces mayor. Sin embargo, checkout solo se frena cuando una importación y un informe financiero coinciden con la hora punta. Más hardware puede ayudar, o esconder una consulta inadecuada, un pool agotado o competencia por memoria. Es una escena didáctica, no un caso observado.
Una hoja de ruta útil conecta la promesa del negocio con trabajo medido.100,000 pedidos/día pueden estar repartidos mundialmente o concentrarse en una venta breve. No existe un volumen universal que obligue a una CPU concreta, separar Redis o gestionar una flota.
Traduce primero los pedidos a trabajo
Pedidos aceptados, intentos de checkout, visitantes, solicitudes dinámicas, transacciones y jobs son cantidades diferentes. Incluye quienes no compran, repeticiones, importaciones, webhooks, informes y búsquedas costosas. Los assets estáticos respondidos en CDN van por otro camino. Conversión y peticiones por visita pueden cambiar antes que las ventas.
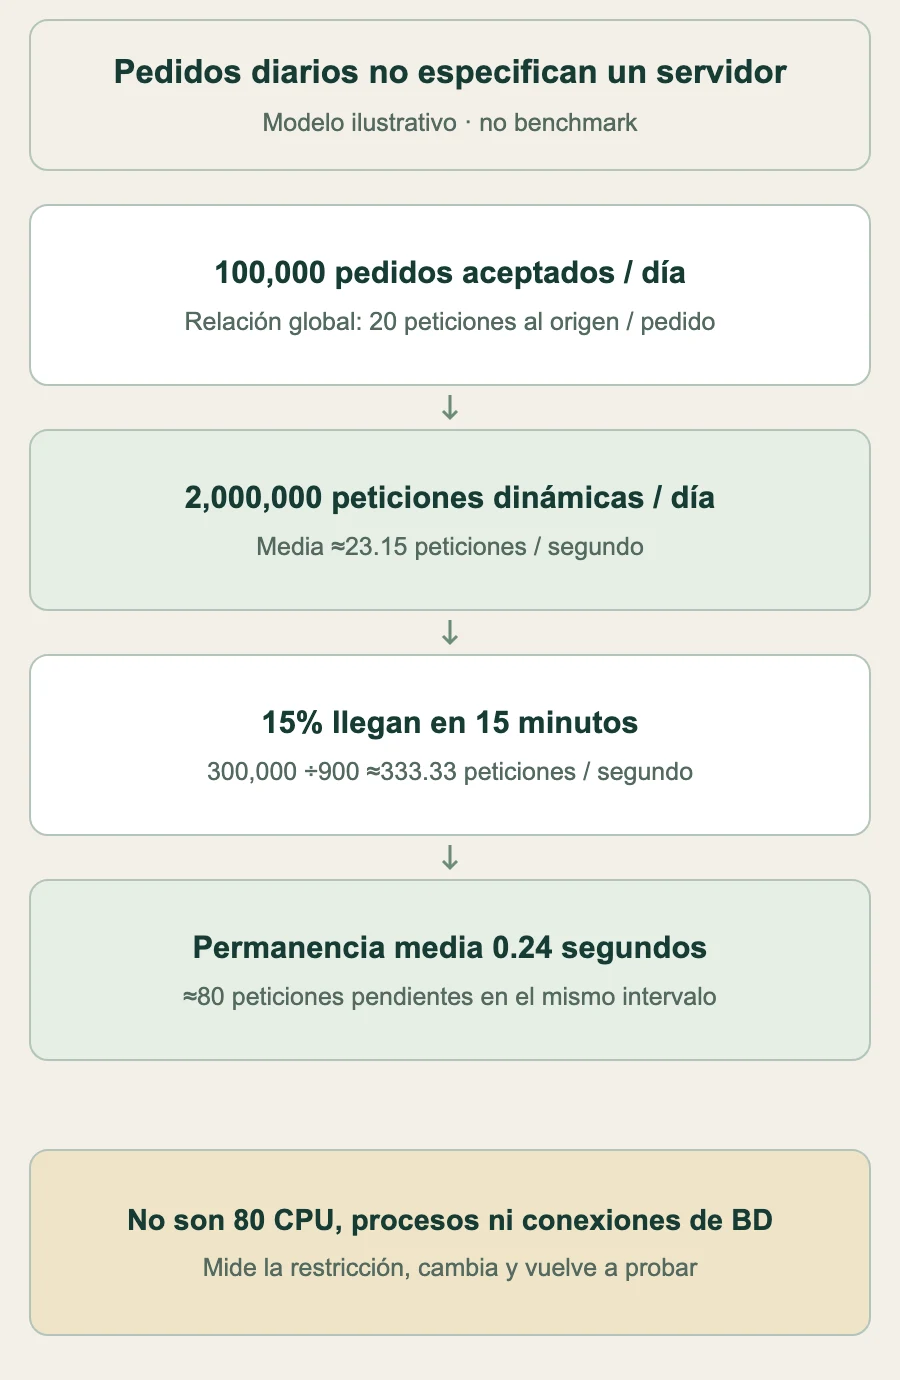
Modelo ilustrativo, no benchmark: 100,000 pedidos aceptados/día entre 86,400 segundos son aproximadamente 1.16 pedidos/segundo. Supón una relación de 20 solicitudes dinámicas al origen por pedido aceptado para todo el tráfico del día, incluidos quienes navegan sin comprar. Resultan 2,000,000 solicitudes/día, unas 23.15/segundo; no significa que cada comprador haga exactamente 20.
Si 15% de esas peticiones llega en 15 minutos, 300,000÷900≈333.33 solicitudes/segundo en esa ventana; los picos de un segundo pueden ser mayores. Con tiempo medio de permanencia de 0.24 segundos en ese mismo intervalo estable, hay aproximadamente 333.33×0.24≈80 peticiones pendientes a la vez. No son 80 CPU, procesos PHP ni conexiones. Usa límites y medias coherentes; p95 no sustituye la media en esta cuenta.
Relación y ráfaga son supuestos que deben sustituirse por tráfico medido. Assets, jobs y límites de recursos requieren otro modelo.
Mide la promesa y el cuello de botella
Define el recorrido: reservar variante correcta, total correcto, pago elegido y referencia duradera de pedido. Acuerda objetivos de latencia, errores y frescura con el negocio.800 ms en checkout o 60% de CPU de base no son umbrales universales. Un error rápido no es una compra exitosa.
Observa p95/p99 por ruta, errores/timeouts y resultados comerciales junto a demanda entrante y capacidad aceptada. Incluye fallos en el denominador correspondiente. Añade CPU limitada, memoria/OOM, latencia/espacio de disco, esperas de conexiones/bloqueos/contribución de consultas y ritmo/reintentos/edad del job listo más antiguo. Un job programado para después no está necesariamente retrasado. Relaciona checkout lento con la espera real.
Una instalación pequeña puede ser sencilla y bien operada
Un host puede ser un inicio razonable si carga medida y riesgo de caída lo permiten. También puede convenir una base gestionada desde el principio. Ninguno es obligatorio. Presupuesta memoria, CPU, disco, backups y acceso para todos los procesos. Supervisa workers y tareas recurrentes: iniciar algo desde una shell temporal no es operación fiable.
PHP-FPM documenta límites de procesos concurrentes. Ajusta con memoria por proceso medida, costes compartidos, CPU y capacidad de dependencias; más procesos pueden agotar RAM o conexiones. OPcache evita recompilar, pero preloading tiene su propio ciclo de vida y no garantiza acelerar 50%. Verifica funcionamiento, memoria e invalidación al publicar. Perfila consultas y trabajo por solicitud antes de añadir una caché obsoleta o con fugas de alcance.
Separa cuando la competencia justifique complejidad
Si importaciones, imágenes, informes o IA dañan checkout repetidamente, separa presupuestos o usa otro pool/host. Reserva capacidad crítica y reintentos limitados. La prioridad no interrumpe un job largo que ya ocupa el único worker. Algunas decisiones deben ser consistentes antes de aceptar checkout; ponerlas en cola no elimina la condición. Un estado pendiente deliberado no es un éxito inventado.
Separar la base puede mejorar aislamiento y añade red, seguridad, backups y monitorización. Caché/sesiones/colas necesitan persistencia, expulsión y disponibilidad según su uso. Laravel documenta opciones de programación y coordinación. Un mínimo de 512 MB para scheduler o un proceso permanente no son curas universales. Elige modo soportado y evita recurrencias duplicadas no deseadas.
Escala web sin agravar otra restricción
Varios nodos necesitan sesiones compartidas o replicadas adecuadamente, cargas duraderas y versiones/configuración compatibles. No guardes la única copia de datos comerciales en un nodo descartable. Cachea respuestas elegibles con claves que cubran host/empresa, idioma y dimensiones de representación. Excluye respuestas privadas o que crean sesión salvo aislamiento probado. Misses y avalanchas de reconstrucción necesitan capacidad controlada.
Los modos de PgBouncer tienen semánticas diferentes. Pooling por transacción puede reducir conexiones, pero exige compatibilidad con funciones de sesión y configuración de sentencias preparadas. No crea capacidad de ejecución en la base. Presupuesta conexiones de web, workers, informes, migraciones y administración; mide espera del pool y saturación antes de subir límites.
Una réplica sirve lecturas que toleren retraso, no toda decisión de stock/pago actual. PostgreSQL replica asíncronamente por defecto; puede haber lag y conflictos entre consultas pesadas y recuperación, y replicar consume recursos. Una réplica de lectura no es automáticamente failover seguro ni backup independiente. Separa rendering, búsqueda o analítica si demanda y costes lo justifican. Renderizar en servidor puede formar parte de la petición viva, no siempre ser trabajo de fondo.
Prueba llegadas, estado y fallos
En un entorno autorizado usa tamaño/índices similares a producción, variantes populares, estados de caché, retrasos externos y trabajo de fondo. Incrementa demanda, sostén y prueba ráfagas con límites de aborto. Protege datos personales y evita cobros, mensajes y envíos reales. Registra build/config y alcance no cubierto.
Grafana k6 diferencia modelos abiertos y cerrados. Con usuarios fijos puede disminuir la carga enviada cuando las respuestas empeoran, sin representar una venta súbita. En modelos por llegada, dimensiona el generador y revisa iteraciones descartadas y métricas reales. Una iteración es un recorrido programado, no necesariamente una petición ni un pedido. Informa llegadas intentadas, throughput, resultados y espera juntos; no solo buena latencia tras descartar carga.
Prueba estado degradado previsto: nodo caído, proveedor lento, caché fría o reinicio de worker. Dos nodos no dan capacidad suficiente si uno no soporta la carga necesaria. Más procesos web pueden empeorar contención de base. Cambia una restricción justificada, repite la misma prueba útil y conserva comparación. Un test de portada no certifica 100,000 pedidos para cualquier instalación.
El crecimiento cambia recuperación y publicaciones
El negocio debe elegir pérdida recuperable y tiempo de recuperación aceptables, RPO/RTO, por impacto, no por tramo de pedidos. Un dump nocturno no garantiza pérdida máxima de 24 horas si falla, está incompleto o es inconsistente. Verifica punto recuperable y restauración del negocio completo. Una réplica también copia borrados; no sustituye retención protegida.
Mantén versiones compatibles, relevo gradual limitado y decisión de recuperación ensayada. Blue/green no revierte migraciones destructivas ni pagos completados. No borres indiscriminadamente sesiones, locks o archivos activos. Consulta la guía de despliegue seguro y la de recuperación. El video existente muestra una interfaz, no prueba recuperar tu entorno.
Demostración existente (0:46). No establece tu punto recuperable, tiempo de recuperación completo ni capacidades instaladas.
Elige el siguiente paso por evidencia
La tabla son decisiones, no bandas fijas de pedidos. Calcula coste total de cómputo, almacenamiento/IO, réplicas, media/tráfico saliente, monitorización, restores, reserva y horas de ingeniería/guardia. Un servidor barato sin recuperación probada puede salir caro. Más componentes implican versiones, credenciales y procedimientos adicionales.
Para la tienda inicial, identifica si la pausa viene del informe, importación, conexiones u otra dependencia. Aísla contención demostrada, repite el recorrido mixto y verifica que pedido, stock y pago coinciden. La siguiente compra debe seguir evidencia, no una garantía de hardware para cualquier tienda con cierto volumen.
Para StoreConsole, consulta requisitos y documentación de instalación como base soportada y valida módulos, extensiones y operación reales. El mínimo soportado no es benchmark. Conserva evidencia y un responsable de la próxima revisión.
Etapa de decisión
Motivo del cambio
Evidencia de aceptación
Runtime sencillo operado
Carga cabe y riesgo de fallo entendido
Prueba mixta, límites monitorizados y backup restaurado
Aislar competencia
Informes/importaciones/jobs dañan rutas críticas
Mejora la misma prueba; coste y responsable cubiertos
Redundancia y escala horizontal
Disponibilidad/capacidad exige más nodos
Estado compartido y pruebas degradadas/de entrega pasan
Especializar operación
Búsqueda/analítica/IA/datos tienen restricción propia
Consistencia, lag, retención, coste y recuperación aceptables
Revisado el 5 de noviembre de 2026. Anichur Rahaman es el creador de StoreConsole. Tasas y escenas son ejemplos, sin garantía de hardware ni capacidad.


 Arquitectura de software

