El 7 de octubre de 2026 se celebraron dos exámenes consecutivos. El registro recoge 661 inicios y 638 entregas en uno, 439 inicios y 425 entregas en el otro. Después se redujo el mínimo del pool: desapareció un nodo sin el drenaje esperado y fallaron unas 360 peticiones en dos minutos. El servicio que funcionó y ese fallo forman parte del resultado.
NovaCommerce anonimiza una plataforma de cursos y exámenes. Esta conclusión conserva las observaciones de septiembre–octubre, recalcula la aritmética publicada y aclara lo no demostrado. No es una nueva prueba de carga ni un benchmark de StoreConsole.
Leer cada prueba según su alcance
La investigación encontró un limitador por IP el 25 de septiembre, fallos de conexión Valkey el 6 de octubre y saturación CPU del backend para la mezcla probada. Causas diferentes necesitaron cambios diferentes. Más servidores ayudaban a cierta presión de capacidad, no sustituían identidad correcta ni un servicio compartido funcional.
El registro incluye frontend de unos 356 requests/s, p95 0.05 s y cero errores reportados; autoescalado GET del 5 de octubre de unos 750 requests/s sin errores de servidor/timeouts, pero aproximadamente 4% HTTP 429; y una rampa 25–500 con cero errores de aplicación y 143 del balanceador. Son mezclas y alcances distintos. No combines sus mejores cifras en una sola promesa de rendimiento.
El despliegue posterior obtuvo 219 sondas, cada dos segundos, sin errores. Es evidencia muestreada, no prueba de que sobreviviera toda petición, escritura o conexión larga. El ensayo de negocio debe verificar aceptación autenticada, recibos duraderos, repetición segura y resultados finales, no solo códigos HTTP o una portada cacheada.
La operación real encontró otro fallo
638/661 redondea a 96.5%; 425/439 a 96.8%. Son proporciones de entrega, no porcentajes de disponibilidad. No entregar admite varias causas; los recuentos no atribuyen cada ausencia a un fallo técnico ni establecen pérdida nula.
El pico backend fue de unos 69 requests/s en logs por minuto y 63 con agregación del proveedor a dos minutos. CPU del pool llegó a 47% en la media reportada mientras un nodo alcanzó 86% un minuto. MySQL: máximo 24.5%, media 13.4%; trabajador: máximo 46% y cero trabajos fallidos registrados. Conserva ventanas y denominadores. Cero fallidos no significa ausencia de pendientes o perdidos.
La estimación previa era 59 ms CPU/request. A 63 requests/s son 3.717 CPU-segundos/s; sobre ocho vCPU, aproximadamente 46.5%. Acercarse al 47% es una comprobación de coherencia bajo supuestos, no causalidad ni escalado lineal probado. El incidente mostró que preparación, carga individual y retirada requieren evidencia propia. El runbook de examen era control humano, no prohibición obligatoria.
Usar el modelo para elegir la siguiente prueba
El modelo histórico asumía 50 requests/s por nodo backend, base de 30, factor de desequilibrio 1.3, quince peticiones de apertura por estudiante y 0.025 requests/s mientras seguía presente. Considera 50 una hipótesis para la misma mezcla y objetivo de latencia, no un límite seguro universal.
Con N nodos sanos, el presupuesto estudiantil es N×50÷1.3−30 requests/s. En una ventana de 600 segundos cada persona aporta 15÷600+0.025=0.05; en 120 segundos, 0.15. Para cuatro nodos, (4×50÷1.3−30)÷0.05≈2,477; la tabla didáctica redondea hacia abajo a 2,400. Es una media fluida: ráfagas, llegadas irregulares y pausas pueden superarla.
El divisor 1.3 es un factor de planificación, no 30% de capacidad ociosa ni cobertura automática ante pérdida de nodo. Modela esa pérdida aparte. Las filas superiores a las pocas máquinas observadas son extrapolaciones, no capacidad certificada de estudiantes. PDFs, colas, contención de base y límites externos quedan fuera. CPU baja en la base no demuestra techo de 450 requests/s ni seis veces de margen.
Nodos backend sanos
Presupuesto requests/s
Llegada en 600 s: estudiantes redondeados
Llegada en 120 s: estudiantes redondeados
2
≈77
900
300
4
≈154
2,400
800
6
≈231
4,000
1,300
Describir también los riesgos abiertos
El diseño histórico tenía pools frontend/backend independientes, mínimo dos y máximo diez cada uno; MySQL primario/reserva; Valkey compartido; PostgreSQL/pgvector separado; objetos y logs backend en OpenSearch. Un trabajador fijo alojaba colas, programador, WebSockets y SMS. Seguía siendo punto único de fallo; logs del frontend y reserva del trabajador estaban planificados.
Réplicas, web stateless e imágenes mejoran recuperaciones específicas. No vuelven redundante cada dependencia ni protegen por sí solos de fallo regional, despliegue malo, acceso indebido o borrado erróneo. Prueba bloqueo de escritores y restauración por separado. Datos antiguos congelados no son rollback actualizado tras nuevas escrituras; volver a una imagen también exige esquemas, sesiones y mensajes compatibles.
Sumar antes de comparar facturas
Las partidas web históricas suman $272: backend $112 +frontend $56 +trabajador $56 +dos balanceadores $48. Datos/logs: $709, con MySQL $389 +Valkey $240 +PostgreSQL $60 +OpenSearch $20. Snapshots $5 y Spaces base $5 llevan a $991 antes de consumo variable. El antiguo “unos $990” era redondeo, no factura exacta.
Los $416 anteriores describían solo web, incluidos Droplets de recuperación apagados, no toda la plataforma. Compara $416 con $272 únicamente tras confirmar el mismo alcance y servicio, no con el nuevo conjunto de $991. Faltan personal, soporte, impuestos, AI/SMS, excesos y capacidad temporal de despliegue/pico. No es coste total de propiedad ni cotización vigente.
Comprueba planes y elegibilidad actuales. Los cambios MySQL Standard de la parte 3 impiden copiar la pareja histórica como receta de compra sin revisar. Más presupuesto de fiabilidad puede justificarse; afirmar ahorro requiere servicio comparable y modelo operativo completo.
Antes de consumo, personal, impuestos y otros servicios
La siguiente aceptación sigue pendiente
El registro dejaba planificados un soak formal de varias horas y carga completa con escrituras mixtas. Dos horas de examen observado no fueron un soak controlado. Veinticuatro horas sin escritura local no descartan fugas de memoria, conexiones crecientes o colas acumuladas. No conviertas esos huecos en “aprobado”.
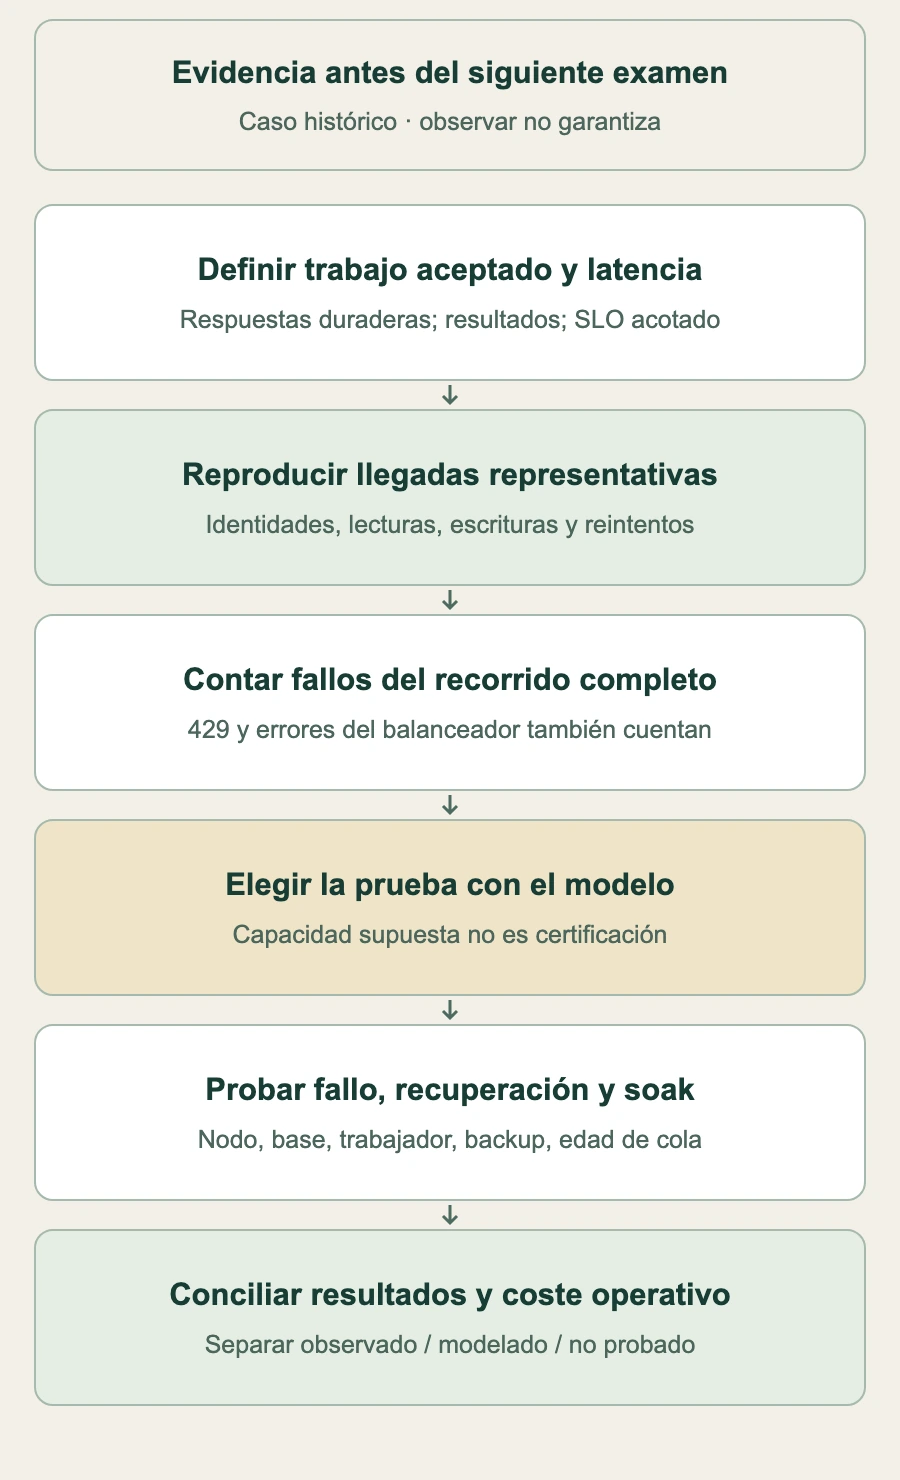
Antes de ampliar el evento, acuerda umbrales de respuesta aceptada y latencia; usa identidades y llegadas representativas; comprueba duplicados y vencimientos. Sostén la carga para ver memoria, conexiones, almacenamiento y antigüedad de trabajos. Incluye fallo de nodo, reducción segura, reconexión/failover de base, recuperación del trabajador y restauración. Guarda versiones, scripts, recursos, errores y conciliación. Los ensayos disruptivos deben ir en un entorno representativo aislado o ventana aprobada con criterios de parada.
La serie deja un ciclo útil: medir resultado de negocio, localizar restricción, cambiar esa capa y volver a probar resultado y recuperación. Su mejor artefacto es un registro que diga observado, modelado o todavía no probado sin confundirlos.
Plan para obtener evidencia, no una afirmación de pruebas ya superadas. Las capacidades son salidas del modelo; los costes, gasto base histórico.
Revisión: 6 de noviembre de 2026. Anichur Rahaman, fundador de StoreConsole. Observaciones conservadas, aritmética comprobada y extrapolaciones y pruebas previstas diferenciadas.



 Infraestructura y escalamiento