Listos antes del examen: escalar y sustituir nodos — NovaCommerce 2
Dos pools dieron capacidad a la plataforma. Lo difícil fue comprobar que los nodos estaban listos, retirar los anteriores y mantener versiones compatibles.
Una hora después del cambio de DNS, el servidor anterior aún recibía cerca del 36% del tráfico registrado. El equipo había reducido el TTL a 300 segundos y probado la nueva ruta modificando el archivo hosts. Seguían abiertas dos entradas. Mantener operativa la antigua era más útil que declarar terminada la migración.
NovaCommerce es el nombre anonimizado de una plataforma de cursos y exámenes. Esta segunda entrega conserva observaciones de septiembre–octubre de 2026: no son benchmarks de StoreConsole ni pruebas repetidas para esta revisión. La primera distinguió identidad del limitador, presión de conexiones Valkey y CPU del backend. Ahora seguimos la aplicación.
Separar los niveles que exigen decisiones distintas
Se implementó un balanceador con su pool para el frontend y otro conjunto para el backend. Ya existían nombres DNS separados. Tamaños, comprobaciones y políticas de sustitución independientes encajaban aquí; dos balanceadores no son un requisito universal.
El backend pasó de una lista fija de IDs de Droplets al descubrimiento por etiqueta. Los nuevos nodos etiquetados podían incorporarse al pool y sus reglas de firewall. Una etiqueta configura pertenencia: no acredita que la aplicación esté lista ni autoriza a una persona. Los $48 mensuales de ambos balanceadores son presupuesto histórico, no una cotización actual.
Contar capacidad sana, no máquinas solicitadas
Ambos pools tenían entre 2 y 10 nodos. Cada frontend usaba nginx y dos contenedores Next.js en 2 vCPU/4 GB; cada backend, nginx/PHP-FPM en 4 vCPU/8 GB. Eran decisiones del despliegue medido. Un único bucle JavaScript no demuestra que los demás núcleos estén ociosos: existen trabajo nativo y pool de trabajadores.
El ensayo del frontend registró unos 356 requests/s, p95 de 0.05 s, cero errores reportados y 55–60% de CPU con dos nodos. Permitió probar CPU compartida más barata; no acredita todas las rutas, interferencias de otros usuarios del host ni escrituras de respuestas. Los antiguos $28/$56 por nodo también son referencias históricas.
Configuración histórica
Frontend
Backend
Rango
2–10 nodos
2–10 nodos
Por nodo
2 vCPU / 4 GB; 2 contenedores Next.js
4 vCPU / 8 GB; PHP-FPM
Objetivo CPU
70%
70%; después 55%
Límite del health check
Comprueba respuesta Next.js
Solo nginx; readiness aparte
Otro estado
Coordinar caché pública
Un trabajador fijo fuera de pools
Prepararse para la hora de apertura
El k6 del 5 de octubre, 21:17–21:33, reprodujo GET: 300–450 requests/s y unos 750 durante seis minutos. Ambos niveles crecieron de dos a tres nodos. No se reportaron errores de servidor ni timeouts, pero alrededor del 4% fueron HTTP 429 por una IP de prueba compartida. Rechazar una petición legítima sigue siendo un fallo; no fue una aprobación limpia del flujo ni ensayó escrituras duraderas de respuestas.
El p95 global fue 132–153 ms; el de API, 320–705 ms. El caso anotó 5–8 minutos de retraso de métricas y, en otra prueba, unos siete minutos desde 99% de CPU hasta un nodo adicional. Son observaciones de esa configuración, no garantías del proveedor. Se preescalaba unos 45 minutos antes del examen, verificando capacidad sana. Kubernetes se consideró, no se implementó; tampoco garantizaría capacidad instantáneamente lista.
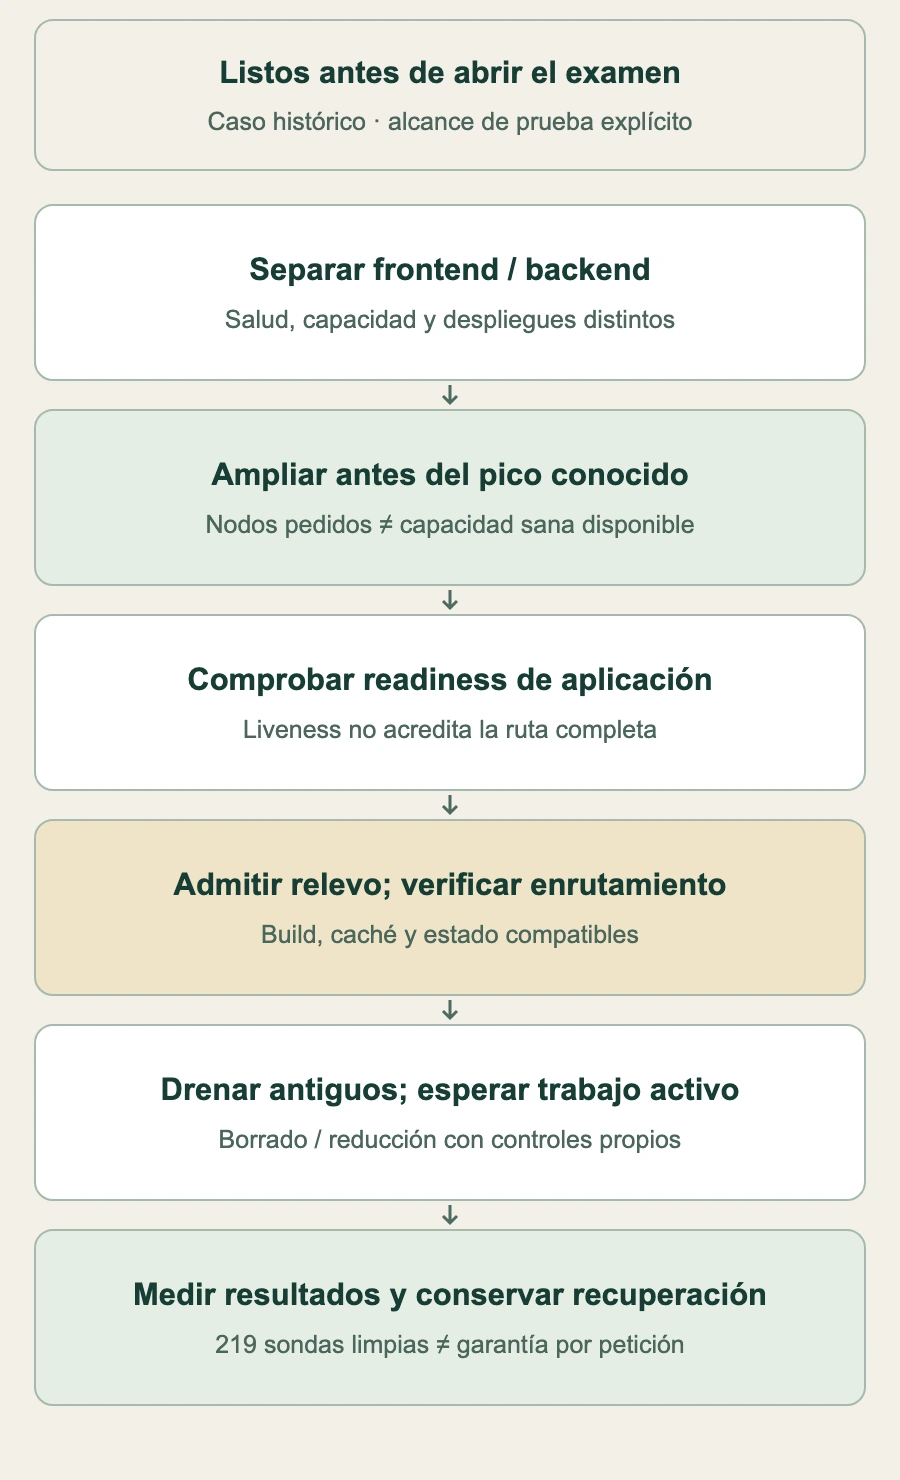
Mapa didáctico del procedimiento. Preparación y drenaje exigen evidencia; los tiempos históricos no son garantías universales.
Sustituir después de comprobar que el relevo funciona
El primer cambio de plantilla causó una breve ráfaga de 503. Después se esperó a los reemplazos, se comprobó su admisión y se drenaron los antiguos antes de borrarlos. Las esperas históricas de 30–40 segundos dependen de aquellas comprobaciones. El criterio seguro observa enrutamiento y trabajo activo, no solo un reloj. Peticiones largas, WebSockets y reducciones automáticas requieren controles propios.
El /lb-health del backend respondía solo desde nginx: útil para liveness y drenaje, insuficiente para demostrar PHP o una ruta con base de datos. Añade readiness de aplicación acotada y sondas reales sin convertir cada comprobación en una consulta costosa. El despliegue posterior obtuvo 219 sondas, cada dos segundos, sin errores; la muestra no demuestra ausencia de interrupciones para todas las personas.
Usa imágenes probadas e inmutables y cambios compatibles de esquema y colas. En varias instancias Next.js coordina build, claves de acciones aplicables, invalidación y diferencias de versión. Cachea solo respuestas públicas elegibles, nunca sesiones o páginas privadas. Acepta cabeceras proxy únicamente desde el ingreso controlado. Una IP reenviada no es identidad ni permiso.
Un nodo desechable necesita recuperación
Sesiones, caché y colas estaban en Valkey; archivos en Spaces y logs del backend fuera del nodo. Observar 24 horas sin escrituras locales apoya el diseño, pero no prueba que toda ruta futura sea stateless ni permite borrar abruptamente. Colas y tareas programadas seguían en un trabajador fijo, un punto de fallo conocido. Centralizarlas no produce efectos exactamente una vez.
El frontend anterior debía seguir compatible mientras persistieran conexiones y direcciones almacenadas. Un TTL de 300 segundos no cierra conexiones; el 36% observado tampoco identifica por sí solo todas las causas. Revertir DNS no es rollback instantáneo ni debe crear dos escritores. Tras nuevas escrituras, la recuperación debe conservarlas.
El resultado útil es un procedimiento repetible de preparación y drenaje, no la promesa de sustituciones imperceptibles siempre. La parte 3 sigue el cambio de base de datos y al cliente antiguo que quedó fuera del inventario.
Revisión: 6 de noviembre de 2026. Anichur Rahaman, fundador de StoreConsole. Observaciones históricas del registro existente; fuentes primarias para la orientación general, no una nueva prueba en producción.



 Arquitectura de software

